
Нейросети для классификации изображений без дообучения: метод Google добавил 10,5 пункта F1
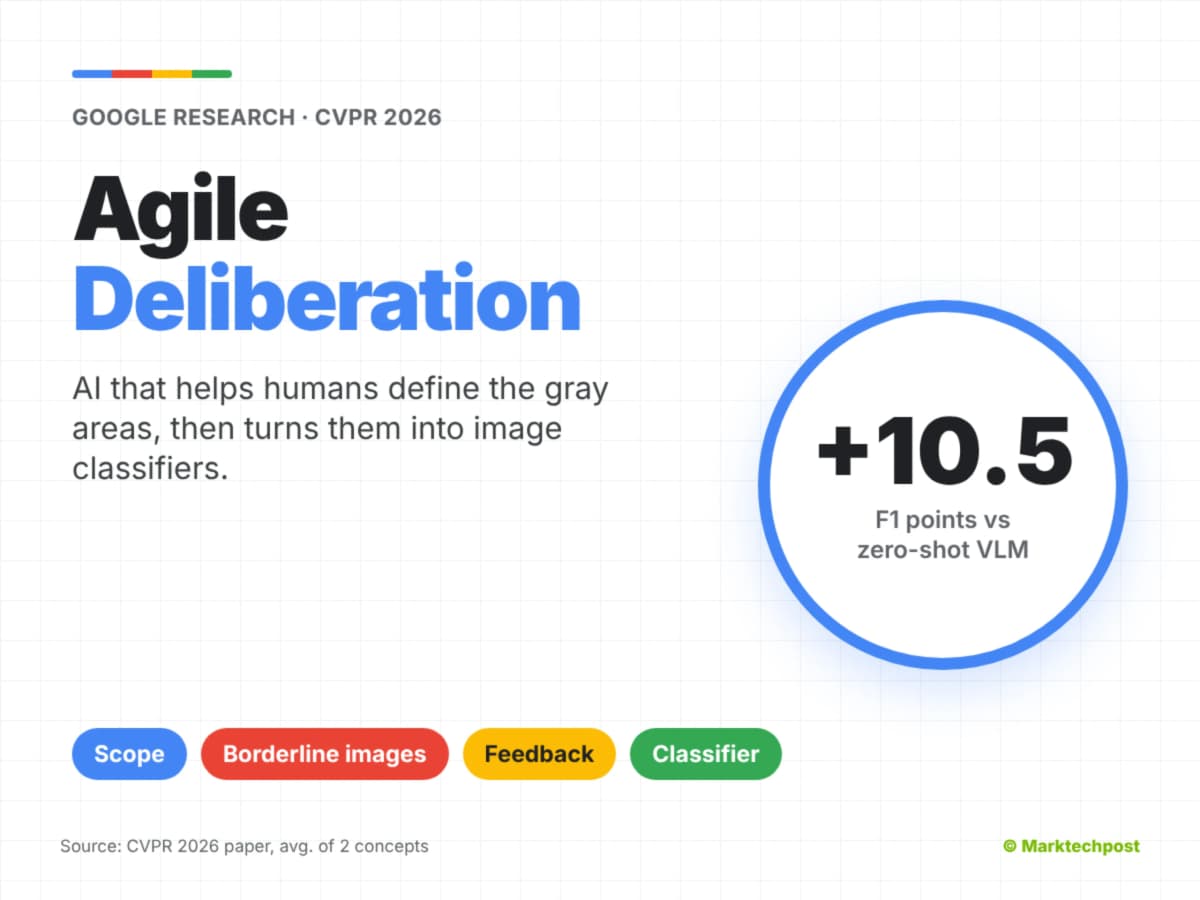
Google Research открыла код Agile Deliberation, системы, где человек вместе с Gemini превращает размытое понятие вроде «полезной еды» в рабочий фильтр картинок, и описала результаты в статье к конференции по компьютерному зрению CVPR 2026.
| Показатель | Значение | Источник |
|---|---|---|
| Средний прирост F1 относительно Gemini 2.5 Flash без примеров | +10,5 пункта | Google Research, статья CVPR 2026 |
| F1 на понятии «paid to play» | 0,59 против 0,48 | Google Research, статья CVPR 2026 |
| Точность на «paid to play» | с 0,35 до 0,57 (+22 пункта) | Google Research, статья CVPR 2026 |
| Полнота на «paid to play» | с 0,80 до 0,63 (минус 17 пунктов) | Google Research, статья CVPR 2026 |
| Падение полноты на «полезной еде» | 15 пунктов | Google Research, статья CVPR 2026 |
| Живые сессии | 18, около 90 минут каждая | Google Research, статья CVPR 2026 |
| Участники | 9 человек без опыта профессиональной модерации | Google Research, статья CVPR 2026 |
| Размер поискового индекса для демо | около 260 МБ, полный около 13 ГБ | Google Research, GitHub |
Нейросети для классификации изображений обычно настраивают так, будто человек заранее знает, где граница между «подходит» и «не подходит». Agile Deliberation исходит из обратного: пользователь границу не знает, и система помогает её найти. Об исследовании рассказало издание Marktechpost со ссылкой на статью и блог Google Research.
Что измеряли?
Речь о субъективных понятиях, у которых нет единственно верного ответа: «полезная еда», «вдохновляющий арт», кликбейт при модерации контента. Классификатор (программа, которая раскладывает картинки по категориям) здесь строится без дообучения, то есть без обучения модели на ваших примерах. Вместо этого система отправляет промпты к Gemini 2.5 Pro и Gemini 2.5 Flash через API, программный доступ к модели.
На выходе получается письменное определение понятия, и у него две роли. Это правило, понятное человеку, и одновременно текстовый промпт для визуально-языковой модели (VLM, нейросеть, которая понимает и картинки, и текст). Схему подсказали интервью с экспертами по модерации: они сначала очерчивали понятие, потом уточняли его на пограничных картинках, и поиск таких картинок отнимал больше всего времени.
На первом этапе Gemini 2.5 Pro раскладывает понятие максимум на 3 составные части. К каждой предлагаются примеры «за» и «против» с подобранными картинками. Для полезной еды «за» могут быть салаты и боулы с крупой, «против» будут переработанная еда или сырые неприготовленные продукты, а пользователь каждый пункт оставляет, переворачивает или удаляет.
Второй этап ищет картинки, спорные по смыслу, а не по уверенности модели. Генеративная модель плохо оценивает собственную уверенность, поэтому эта цифра мало что говорит. Порядок такой:
- Gemini 2.5 Flash пишет пограничные запросы вроде «салаты с обильной майонезной заправкой», каждый приносит от 50 до 100 картинок.
- Картинки очищают от дублей и группируют по сходству.
- Алгоритм выбора, так называемый «многорукий бандит» (метод, который балансирует между проверенным и новым), отдаёт приоритет группам, где человек поправил модель или оставил подробный отзыв.
- Модель описывает каждую картинку одним предложением, человек видит минимум 5 картинок с одной общей неоднозначностью.
Человек ставит метки и коротко поясняет, где не согласен с моделью. Языковая модель превращает заметки в варианты определения, и в каждом раунде остаётся вариант с лучшим F1 на разметке пользователя. F1 сводит в одну оценку точность (какая доля отобранного верна) и полноту (какую долю нужного нашли), чем ближе к 1, тем лучше.
Готовых эталонов для субъективных понятий нет, поэтому команда провела 18 живых сессий. Девять участников прошли по две: одну с Agile Deliberation, другую с ручной формулировкой определения. Каждый около 45 минут формулировал понятие, потом размечал 200 отложенных тестовых картинок.
Понятий было два: кликбейт «paid to play», то есть заманивание обещанием денег за игру, и «полезная еда». Поиск шёл соответственно по закрытому набору Google из 100 млн картинок и по базе WebLI.
Что обнаружили?
- В среднем по двум понятиям F1 вырос на 10,5 пункта относительно Gemini 2.5 Flash в режиме без примеров, когда модели дают задачу без образцов.
- Лучший результат на «paid to play»: F1 0,59 против 0,48, точность выросла на 22 пункта, с 0,35 до 0,57.
- Полнота на том же понятии упала на 17 пунктов, с 0,80 до 0,63, на «полезной еде» на 15 пунктов.
- Участники сообщили о значительно меньших усилиях и стрессе, чем при ручной правке промпта. Цифр по этому пункту источник не приводит.
- Код открыт на GitHub. Демо в блокноте Jupyter или Colab (среды, где код запускается по шагам прямо в браузере) разбирает пример с полезной едой, базовый индекс по набору LAION-400M занимает около 260 МБ.
Если перевести на бытовой язык, фильтр стал строже: реже берёт лишнее, но чаще пропускает нужное. Определение при этом одновременно служит регламентом для людей и промптом для машины, а это сокращает разрыв между тем, что команда решила, и тем, что делает модель.
Выборка маленькая: 9 человек, 2 понятия, 18 сессий, а набор для кликбейта закрыт и снаружи его не повторить. Рост F1 оплачен падением полноты, поэтому там, где пропуск дороже ложной тревоги, выигрыш может обернуться потерей.
Что это значит для вас?
Автору Дзена. Главный приём работает без кода: опишите словами, что для вас «живая обложка» или «картинка в стиле канала». Потом проверьте описание на спорных примерах, а не на очевидных, и каждое несогласие с ответом модели допишите в промпт одной фразой.
Маркетологу. Метод подходит для отбора визуала под бренд и для модерации пользовательского контента. Определение, собранное так, становится общим правилом для команды и для нейросети. Учтите, что строгий фильтр будет отсекать часть подходящих картинок.
Предпринимателю в РФ и СНГ. Демо требует ключа Gemini API, доступ к нему из России проверьте заранее. Из доступных в РФ аналогов есть YandexGPT и GigaChat. Сам подход, определение плюс проверка на пограничных примерах, не привязан к конкретной модели.
На мой взгляд, ценнее всего здесь не прирост F1, а честное признание: человек не знает границ собственного понятия, пока не увидит спорные примеры. Я вижу то же самое, когда собираю промпты для обложек: первые версии описывают то, что я хотел, а не то, что я на самом деле отбираю. Падение полноты на 15 и 17 пунктов говорит, что для серьёзной модерации систему пока рано оставлять без присмотра.
Возьмите одну субъективную задачу из своей работы, найдите пять спорных картинок и перепишите определение по ним. Это и есть Agile Deliberation без строчки кода.
По данным Google Research (статья к CVPR 2026) в изложении Marktechpost

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Что такое ИИ-агент в команде: pepper-orchestrator делит большой проект и проверяет каждого
Основатель студии ITSalt Максим Никитин выпустил для Claude Code и Codex плагин pepper-orchestrator, раздающий большую задачу нескольким ИИ-агентам, потому что…
Плагиат и кража в геймдеве: ИИ-«рекомпы» старых игр выходят нечитаемыми
Автор колонки на Хабре предупредил о тёмной стороне нейросетевого моддинга: ИИ-инструменты уже выдают нечитаемые «рекомпы» старых игр и присваивают чужие…
Что такое ИИ-агент в деньгах: ответ от 0,94 до 121,57 рубля, цену задают инструменты
Каталог Agents Place разобрал 69 ИИ-агентов в срезе цен на 5 ноября 2026 и показал, что ответ стоит примерно от 0,94 до 121,57 рубля, а дорожает он из-за…
Комментарии