
Нейросеть на железе с помойки: Bonsai 2 27B, сжатая в 9 раз, проиграла Qwen3 8B
Bonsai 2 27B от PrismML, о которой после выхода 17 сентября заговорили профильные каналы, на майнинговой карте с 8 ГБ не обогнала обычную Qwen3 8B, а та местами работала быстрее и стабильнее.
Сжатие в девять раз не дало выигрыша владельцу видеокарты на 8 ГБ. Модель на 8 миллиардов параметров запускается штатными программами и справляется не хуже. Для домашнего стенда главное не размер файла, а то, понимают ли формат привычные инструменты.
Автор теста искал для своего проекта локальную модель, которая работает без облака на железе под столом. PrismML выпустила Bonsai 27B в середине июля и заявила, что это первая модель такого размера, которая помещается в iPhone. Через два месяца вышла троичная Bonsai 2 27B, и её проверили на майнинговой NVIDIA P104-100 2017 года и процессоре i7-3770 2012 года.
Как Bonsai 2 27B ужали в девять раз?
Параметры, это внутренние настройки модели: чем их больше, тем модель умнее и тяжелее. У Bonsai 2 27B их 27 миллиардов, и по данным разработчиков файл сжали с 54 до 5,9 ГБ, сохранив 98,2% качества исходной модели. Июльскую версию на Hugging Face скачали около 5 млн раз.
Модель построена на Qwen3.8-27B под свободной лицензией Apache 2.0. Обычная модель хранит каждый вес как 16-битное число, а у троичной вариантов всего три: минус один, ноль и плюс один. Умножать такие числа не нужно, хватает сложения и смены знака.
Ещё несколько фактов из паспорта модели:
- контекст (сколько текста модель держит в памяти за раз) заявлен в 262 тысячи токенов, токен это кусочек слова;
- примерно три четверти слоёв используют облегчённую схему, которая дешевле обходится на длинном тексте;
- формат PTQ1_0, по данным PrismML, быстрее на игровых картах уровня RTX 4090, а PQ2_0 на серверных H100, A100 и Blackwell.
Что понадобится для запуска?
- Видеокарта NVIDIA с 8 ГБ памяти (в тесте майнинговая P104-100) и компьютер с 15,5 ГБ оперативной памяти.
- Готовая сборка llama.cpp от PrismML с поддержкой CUDA 12.4. llama.cpp это бесплатная программа для запуска нейросетей на своём компьютере, CUDA это технология NVIDIA для расчётов на видеокарте.
- Файл модели в формате GGUF (так упакованы модели для llama.cpp) и быстрый накопитель NVMe: с обычного жёсткого диска старт заметно дольше.
- Вечер на установку и замеры.
Пошаговая инструкция: Bonsai запускается только через форк
- Проверьте свободную видеопамять и запустите наблюдение за картой. Автор снимал температуру, мощность и загрузку памяти каждые полсекунды.
- Установите сборку от PrismML. Форк, это копия программы с правками другой команды: только он понимает быстрые троичные тензоры PQ2_0.
- Скачайте Bonsai 2 27B нужного формата и замерьте скорость утилитой llama-bench.
- Ставьте контекст не выше 16 384 токенов: на 32 768 модель на 8 ГБ не стартует.
- Для сравнения поставьте Qwen3 8B. Она помещается в те же 8 ГБ без форков и патчей.
nvidia-smi --query-gpu=temperature.gpu,power.draw,memory.used --format=csv -lms 500
llama-bench -m путь_к_модели.gguf
Эталон Q4_K_S весит 15,4 ГБ и не влез ни в видеопамять, ни в свободную оперативку. С подкачкой с диска он выдал около 1 токена в секунду, а при 28 слоях на видеокарте 1,14. Bonsai 2 27B на майнинговой карте выдала примерно пятую часть скорости RTX 4090, где PrismML заявляет от 81 до 91 токена в секунду. При контексте 16 384 токена видеопамять заполнилась на 97%, это 7967 МБ из 8191.
Стандартная Ollama версии 0.40.6 на троичном файле честно выдаёт ошибку. Стандартный llama.cpp хуже: старый формат Q2_0 он загружает молча, а модель потом пишет бессмыслицу. Причина в особом «повороте» весов при сжатии, который обычная программа не повторяет, и разработчики предупреждают об этом на странице модели.
Ollama можно пропатчить вручную и подменить в ней движок на сборку PrismML, скорость при этом не падает. Но правки сотрёт первое же обновление Ollama.
Не выбирайте формат по числу бит. Обычный двухбитный IQ2_XXS при сопоставимом размере на этой карте читал промпт в шесть раз медленнее, а печатал ответ в 1,6 раза медленнее.
Что делать с этим прямо сейчас, по ролям
Автору Дзена. Для черновиков, планов статей и рерайта на домашней карте с 8 ГБ берите Qwen3 8B: она ставится штатно и не ломается после обновлений.
Маркетологу. Локальная модель не отправляет тексты клиентов в облако, это довод для работы с закрытыми брифами. Длинные документы режьте на части: больше 16 тысяч токенов на такой карте не поместится.
Предпринимателю в РФ и СНГ. Нейросеть на железе с помойки, это реальный вариант: модели скачиваются файлом и работают без подписок. Если локальный запуск не нужен, из доступных в РФ облачных аналогов есть YandexGPT и GigaChat.
На мой взгляд, история «Нейросеть на железе с помойки, или Как Bonsai 2 27B проиграла Qwen3 8B» не про плохую модель, а про цену входа. Bonsai технически интересна, но требует форка, а форк на домашнем стенде живёт до первого сбоя. Честная оговорка: тест проведён на одной карте поколения Pascal, на RTX 4090 расклад может быть другим. Мой совет: начните с Qwen3 8B, а к троичным моделям возвращайтесь, когда их поддержку примут в обычный llama.cpp целиком.
Подберите нейросеть под свои задачи
В dzen.guru разбираем, какие модели и приёмы реально работают для авторов и маркетологов.
Перейти в dzen.guruЕсли под столом лежит старая карта на 8 ГБ, не гонитесь за цифрой 27B на упаковке: поставьте 8B, и она начнёт писать тексты в тот же вечер.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
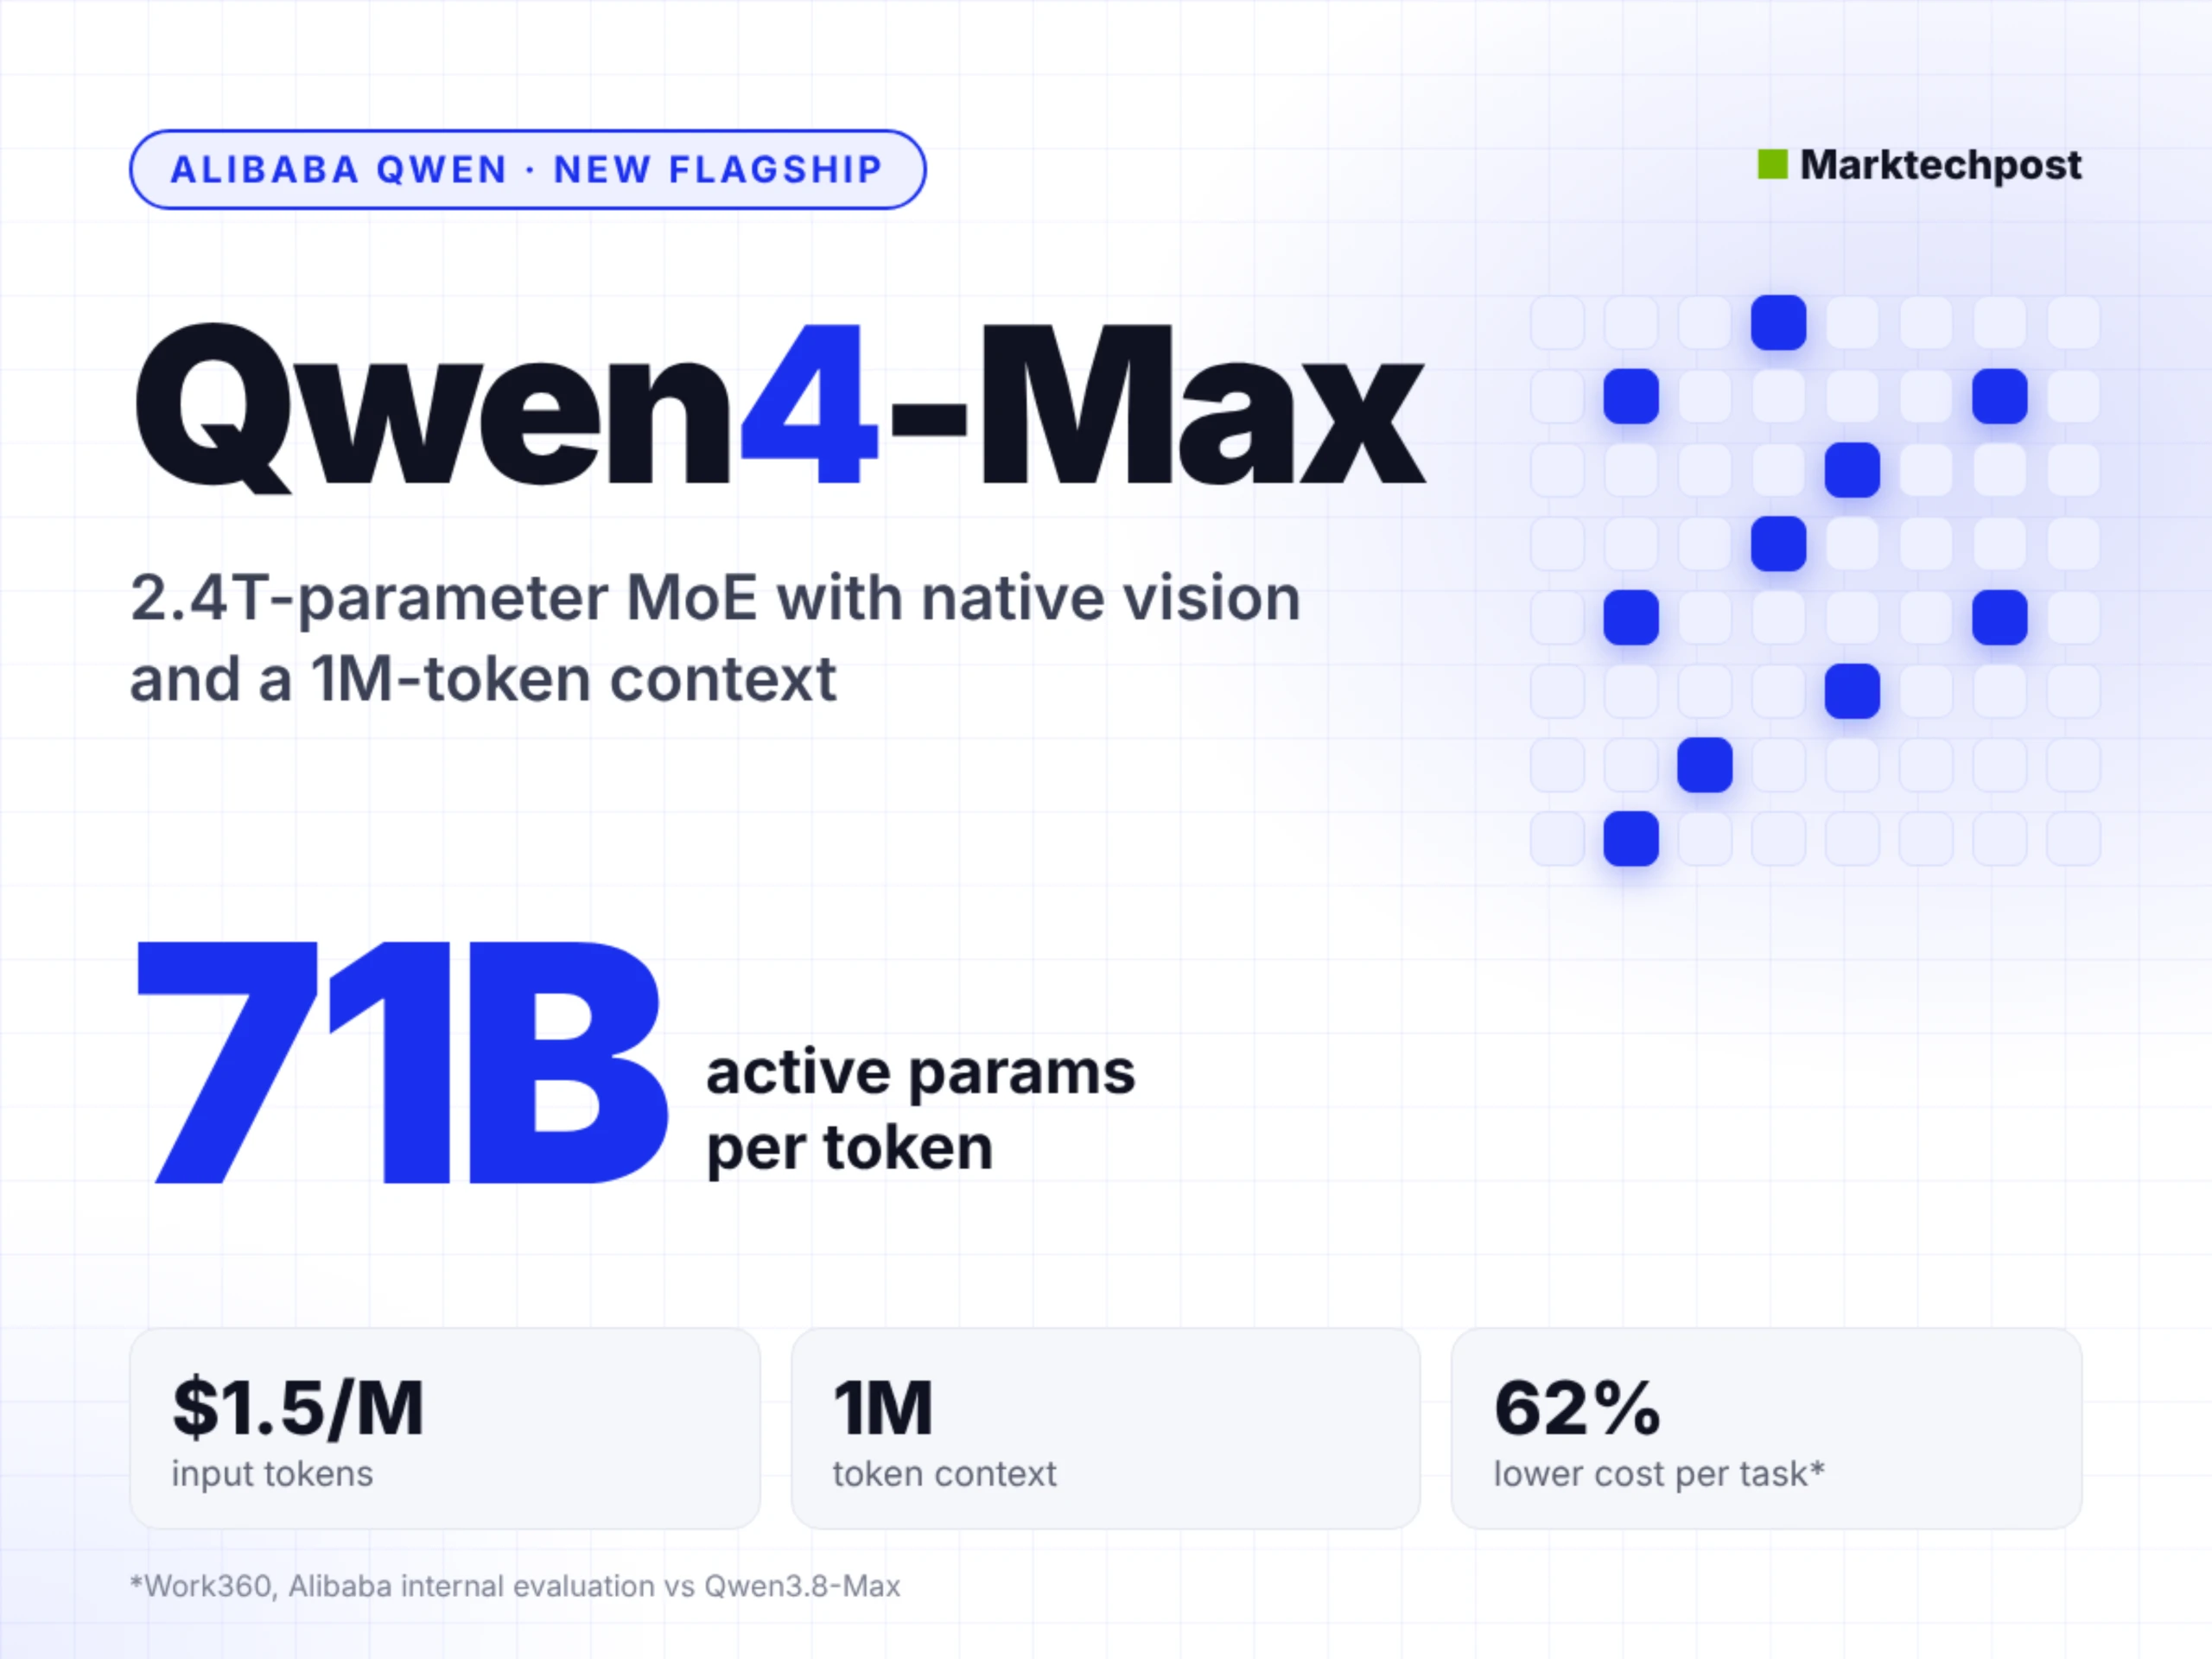
Alibaba выпустила Qwen4-Max: средняя задача подешевела на 62%, с $4,43 до $1,67
Alibaba в этом месяце открыла предварительный доступ к Qwen4-Max, первой модели нового поколения Qwen, и одновременно снизила цены, из-за чего средняя задача,…
Дженсен Хуанг ушёл с поста главы Nvidia из-за предполагаемой шпионки, акции упали на 8%
Дженсен Хуанг, сооснователь Nvidia, одного из крупнейших производителей ИИ-чипов, ушёл с поста генерального директора 12 ноября 2026 года, когда связь с…
Amazon задумал базу всех товаров интернета к 2027 году, чтобы удержать ИИ-агентов
Amazon готовит проект World Product Graph, базу данных обо всех товарах в интернете, даже чужих, и внутренний документ с датой запуска 1 октября 2027 года…
Комментарии