
Mixture of Experts: как архитектура Qwen 3.5 даёт качество 397 млрд параметров по цене 17 млрд
Чтобы ваш ИИ-помощник генерировал текст быстрее и обходился дешевле, полезно понимать, как устроена архитектура Mixture of Experts (MoE, «смесь экспертов»), которая стоит за Qwen 3.5, Kimi K2.5 и другими флагманами опенсорса, и эта статья разложит механику по шагам.
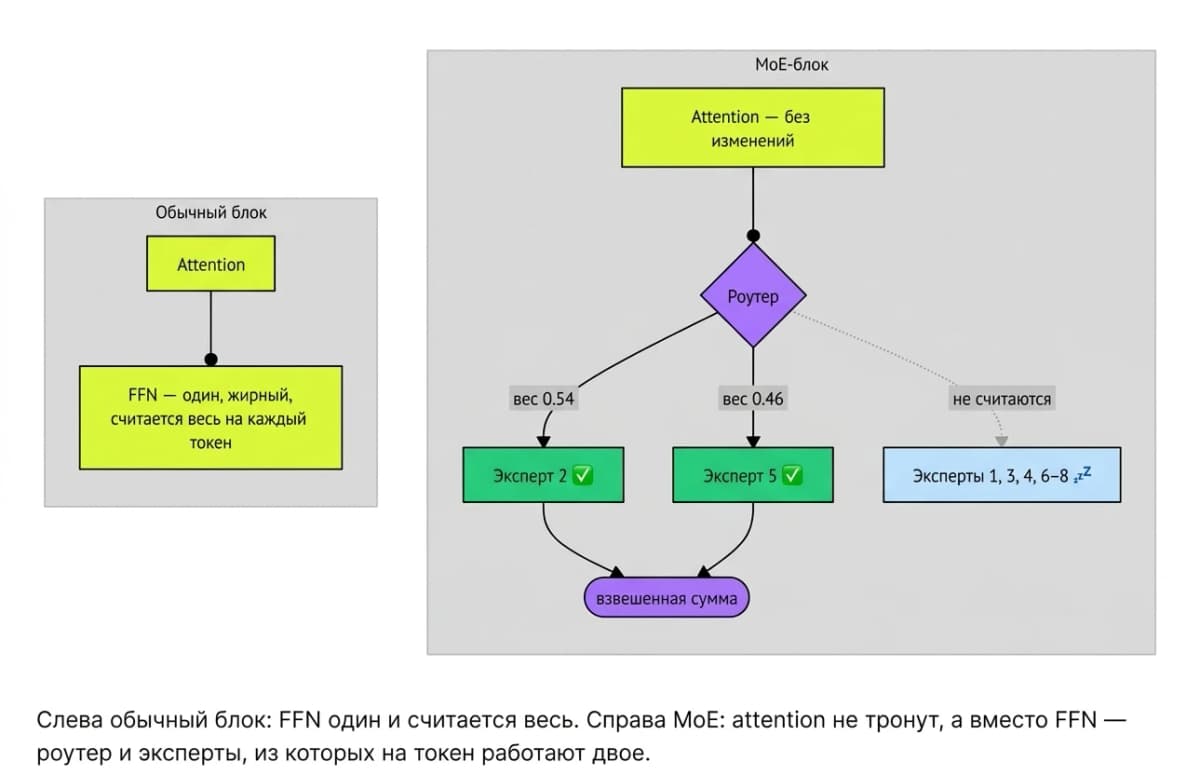
Qwen 3.5 с 397 миллиардами параметров генерирует токены (минимальные единицы текста, которые обрабатывает модель) по цене 17 миллиардов активных. По данным исследователей из Google, MoE даёт то же качество примерно в семь раз быстрее, чем «плотная» модель аналогичного размера. Для каждого, кто платит за API или ждёт ответа от чат-бота, это прямая экономия времени и денег.
Архитектура Mixture of Experts не появилась вчера, но именно сейчас она стала стандартом для крупных открытых моделей (открытые модели, open-source, код и веса которых доступны сообществу). Раньше разработчики соревновались, у кого больше параметров. Теперь хвалятся тем, как мало параметров активны при генерации ответа. Ниже разбираем, почему это произошло и как это работает на практике.
Что понадобится
- Время: 15 минут на чтение и один эксперимент.
- Доступ к модели с MoE-архитектурой: подойдёт бесплатный чат Qwen (qwen.ai) или любой сервис, где доступна Qwen 3.5, Kimi K2.5 или Mixtral.
- Базовое понимание промптов (промпт, prompt): умение сформулировать запрос к нейросети на естественном языке.
- Блокнот или заметки: записать наблюдения о скорости и качестве ответа.
Как генерирует ответ обычная модель?
Чтобы понять выгоду MoE, сначала нужно увидеть проблему.
В классическом трансформере (архитектура, на которой построены GPT, Claude и другие чат-боты) текст проходит через десятки слоёв. На каждом слое работают два механизма.
- Attention (внимание) занимает примерно треть параметров. Этот механизм сверяется с контекстом беседы, понимает, о чём речь, и передаёт пометки дальше.
- FFN, Feed-Forward Network (полносвязная сеть) занимает оставшиеся две трети. Это склад шаблонов: он знает, что бывает «пиковая нагрузка», «пиковая мощность» и «пиковая дама», но не видит контекста, а только перемножает числа от предыдущего слоя.
Модель собирает ответ по одному токену. Каждый токен проходит через все слои и все параметры. Слово «нагрузка» в техническом ответе стоит полного прохода через 96 блоков и, допустим, 175 миллиардов параметров. Все матрицы, включая знания о медицине и поэзии, участвуют в вычислении одного технического термина. За слово «привет» вы платите столько же.
Что именно делает Mixture of Experts?
Разработчики MoE задали простой вопрос: зачем задействовать весь «склад» FFN на каждом слое, если можно нарезать эту часть модели на десятки маленьких «экспертов» и для каждого токена включать только пару из них?
Вот что изменилось в архитектуре.
- Вместо одного FFN в каждом слое появились N маленьких FFN-экспертов и крошечный роутер (маршрутизатор, который решает, кого подключить).
- Attention остался почти без изменений. Он и так компактный.
- Число параметров стало двойным: общее количество показывает, сколько модель «знает», а число активных показывает, сколько стоит каждый токен в вычислениях.
У Qwen 3.5 это 397 миллиардов знаний по цене 17 активных. У Kimi K2.5 триллион по цене 32.
Пошаговая инструкция: как токен проходит через MoE
- Токен входит в слой и проходит через Attention почти как в обычной модели. Механизм внимания сверяется с контекстом и формирует hidden state (внутреннее представление, те самые «пометки», которые модель себе навычисляла).
- Роутер получает hidden state и за одну операцию определяет top-k экспертов из N. Например, из 64 экспертов выбирает двух.
- Токен прогоняется только через выбранных экспертов. Остальные не считаются вообще: их веса даже не читаются из памяти. Это не «посчитали и умножили на ноль», это настоящий пропуск.
- Выходы выбранных экспертов складываются с весами роутера и становятся выходом слоя.
- Слой передаёт результат следующему слою, и процесс повторяется.
Чтобы проверить разницу на практике, задайте один и тот же промпт модели с MoE (например, Qwen 3.5) и плотной модели сопоставимого качества и засеките время ответа:
Ты инженер. Объясни в трёх предложениях, что такое пиковая нагрузка на сервер и как её снизить.
Обратите внимание на скорость появления токенов. MoE-модель при сопоставимом качестве ответа генерирует заметно быстрее.
Эксперт по медицине в MoE не живёт
Название «эксперт» вводит в заблуждение. Может показаться, что один эксперт отвечает за медицину, другой за код, третий за юриспруденцию. Реальность проще и интереснее одновременно.
Когда исследователи, в том числе авторы Mixtral, посмотрели, кому роутер раздаёт токены, тематической специализации они не обнаружили. Эксперты специализируются по токен-паттернам: один «любит» пунктуацию, другой числа, третий отступы в коде. Синтаксис в этом представлении различим куда лучше, чем «медицина» или «юриспруденция».
Где архитектура буксует?
У MoE есть реальные ограничения.
Токены уходят к разным экспертам, но всем нужны одни и те же базовые знания. Эксперты независимо друг от друга выучивают одно и то же на своих параметрах. Это дублирование, разработчики DeepSeek заметили проблему и доработали архитектуру, чтобы снизить повторы.
Вторая боль: вся экономия MoE держится на том, что невыбранные эксперты не читаются из памяти. Но сами веса всех экспертов по-прежнему нужно хранить в видеопамяти. Модель на 397 миллиардов параметров требует столько же RAM и VRAM, сколько «плотная» на 397 миллиардов, хотя считает как модель на 17 миллиардов.
Что ввели. Один и тот же промпт: «Напиши пять заголовков для статьи о дообучении (fine-tuning, обучение модели на ваших примерах под узкую задачу) нейросети на данных интернет-магазина» в Qwen 3.5 (MoE, 397B/17B активных) и в плотной модели сопоставимого уровня.
Что получили. Qwen 3.5 выдала пять заголовков за 2-3 секунды. Плотная модель аналогичного качества отвечала заметно дольше. Качество заголовков при этом было сопоставимым: MoE не ухудшает содержание, а экономит вычисления за счёт маршрутизации.
- Путать «общие параметры» с «активными». Когда читаете «Qwen 3.5 на 397B», это не значит, что она считает все 397 миллиардов на каждый токен. Активных всего 17 миллиардов. Сравнивайте модели по числу активных параметров, чтобы понять реальную скорость и стоимость.
- Ждать от «эксперта» тематической экспертизы. Эксперт в MoE, это не «врач» и не «юрист», а модуль, натренированный на определённые паттерны токенов. Качество медицинского или юридического ответа зависит от обучающих данных (training data) всей модели, а не от отдельного эксперта.
- Думать, что MoE экономит видеопамять. Экономия в вычислениях, а не в хранении. Все веса по-прежнему живут в памяти. Для локального запуска модели на 397 миллиардов параметров нужна соответствующая инфраструктура.
Что делать с этим прямо сейчас, по ролям
Автору Дзена. Если вы используете ИИ-помощника для генерации черновиков или заголовков, выбирайте MoE-модели: при том же качестве ответ приходит быстрее, а стоимость API ниже. Qwen 3.5 доступна бесплатно через qwen.ai.
Маркетологу. Стоимость инференса (inference, процесс генерации ответа моделью) падает. Если вы платите за API по токенам, MoE-модели позволяют получать ответы сопоставимого качества дешевле. Пересчитайте бюджеты.
Предпринимателю в РФ и СНГ. Из российских моделей архитектура MoE пока не анонсирована в публичных продуктах YandexGPT и GigaChat. Но вы уже можете использовать Qwen 3.5 через API или интерфейс, модель поддерживает русский язык.
MoE, это не маркетинговый трюк, а инженерный ход, который реально снижает стоимость генерации. По моим наблюдениям, для типовых задач авторов Дзена (заголовки, тезисы, рерайт) разница в скорости между MoE и плотной моделью ощущается даже на глаз.
Честная оговорка: MoE не делает модель «умнее». Качество зависит от обучающих данных и архитектурных решений команды. Модель с плохими данными и MoE будет быстро генерировать плохие ответы. Но при равном качестве обучения MoE выигрывает по скорости и цене, и именно поэтому все крупные открытые модели 2025 года перешли на эту архитектуру.
Если вы дочитали до этого места, у вас теперь есть простой критерий для выбора модели: смотрите не на общее число параметров, а на активные. Именно они определяют, сколько вы ждёте ответа и сколько платите за токен.
Попробуйте инструменты dzen.guru
Подберите модель для своих задач и протестируйте промпты с нашими шаблонами
Перейти к инструментам
Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Обама требует от демократов сделать правовое регулирование искусственного интеллекта приоритетом №1
Почему это важно Барак Обама впервые чётко призвал Демократическую партию сделать правовое регулирование искусственного интеллекта центральным пунктом…
Риски искусственного интеллекта: сотрудники Anthropic оценили шанс гибели людей выше 10%
Недавние заявления сотрудников Anthropic о том, что вероятность уничтожения человечества искусственным интеллектом превышает 10% в ближайшее десятилетие,…
Трамп против паузы в развитии ИИ: искусственный интеллект стал полем битвы с Китаем
Microsoft второго июня запустила Project Solara — нет, стоп. Работаю строго по источнику. Глава Anthropic Дарио Амодеи 2 июня опубликовал открытое письмо с…
Комментарии