
Microsoft открыла RetroChimera: ИИ для синтеза молекул обошёл учёных в слепых тестах
Модель RetroChimera от Microsoft Research, опубликованная в журнале Nature и выложенная с открытыми весами на GitHub под лицензией MIT, автоматически предлагает маршруты синтеза новых молекул, и для российских химиков и биотех-стартапов это шанс ускорить разработку лекарств и материалов без дорогих консультантов.
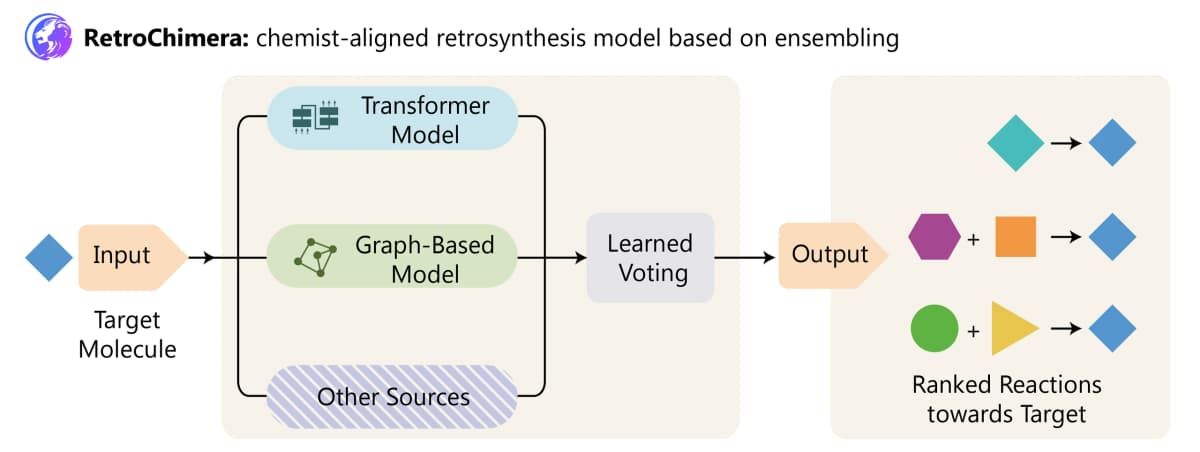
Впервые открытая модель для ретросинтеза обошла в слепых тестах не только предшествующие системы, но и записи из научной литературы: PhD-химики в «слепых» оценках предпочли предложения RetroChimera реальным опубликованным реакциям.
Планирование синтеза молекул по-прежнему остаётся ручным, долгим и затратным процессом. Даже когда вычислительные методы позволяют перебирать тысячи кандидатов, найти практический способ собрать нужную молекулу из доступных реагентов часто сложнее, чем придумать её. Microsoft Research опубликовала в Nature модель RetroChimera и выложила код с весами на GitHub. Теперь любой исследователь может запустить её локально, на своих данных, без подписки и без облачных платформ.
Что такое ретросинтез и почему ИИ здесь уместен?
Ретросинтез (retrosynthesis) работает от обратного: берёт целевую молекулу и пошагово разбирает её на более простые предшественники, пока не дойдёт до коммерчески доступных реагентов. Авторы модели сравнивают этот процесс с шахматами или го, но с оговоркой: число возможных «ходов» в химии на порядки больше, и далеко не очевидно, какие ходы вообще допустимы для конкретной молекулы.
Существующие системы спотыкаются на редких, но стратегически важных реакциях, плохо работают за пределами обучающих данных (training data, данные, на которых модель училась) и часто расходятся с интуицией опытного химика. RetroChimera решает это, объединяя две модели с разными сильными сторонами.
Как устроена RetroChimera?
Внутри модели работают два компонента:
- R-SMILES 2 построен на архитектуре Transformer (трансформер, та же архитектура, что лежит в основе ChatGPT). Он предсказывает предшественники напрямую из входной молекулы, обучаясь паттернам реакций на данных. Это даёт гибкость, но порождает риск галлюцинаций (hallucination, когда модель уверенно выдумывает несуществующую реакцию).
- NeuralLoc использует графовую нейросеть (GNN). Он кодирует и целевую молекулу, и шаблоны реакций как графы, затем подбирает шаблон и определяет, куда его применить. Предсказания привязаны к реальным паттернам из обучающих данных, поэтому они точнее, но менее гибки для реакций, не покрытых библиотекой шаблонов.
Различия между ними оказались сильной стороной. R-SMILES 2 лучше справляется с реакциями, где молекула сильно меняется. NeuralLoc точнее в редких реакциях и в тех, где изменения локальны. RetroChimera объединяет ранжированные предсказания обоих через обучаемую стратегию ансамблирования: каждая модель присваивает голос каждому предложенному набору реагентов, голоса складываются, когда обе модели предлагают одну и ту же реакцию.
Что понадобится
- Код и веса модели: репозиторий на GitHub (лицензия MIT, бесплатно)
- Доступ через облако (альтернатива): Microsoft Foundry
- Среда запуска: Python, GPU для инференса (инференс, запуск модели для получения предсказания); на CPU тоже работает, но медленнее
- Формат входных данных: молекула в формате SMILES (текстовая запись структуры молекулы, стандарт в хемоинформатике)
- Время на установку: от 30 минут до нескольких часов в зависимости от окружения
- Для дообучения (fine-tuning, обучение модели на ваших примерах под узкую задачу) на собственных данных: набор реакций в поддерживаемом формате
Пошаговая инструкция
- Клонируйте репозиторий и установите зависимости:
git clone https://github.com/microsoft/RetroChimera.git
cd RetroChimera
pip install -r requirements.txt
-
Скачайте веса модели по инструкции из README репозитория (авторы указывают отдельный чекпоинт, ссылка в GitHub).
-
Подготовьте входную молекулу в формате SMILES. Если у вас есть структурная формула, конвертируйте её через любой бесплатный конвертер (RDKit, PubChem).
-
Запустите предсказание ретросинтеза. Точный синтаксис команды зависит от версии; ориентируйтесь на примеры из репозитория.
-
Получите ранжированный список маршрутов: модель выдаст несколько вариантов разложения целевой молекулы на предшественники, отсортированных по уверенности ансамбля.
-
Оцените маршруты: проверьте доступность предшественников в каталогах реагентов (Sigma-Aldrich, Enamine) и реалистичность условий реакции.
-
Дообучите на своих данных (опционально): если вы работаете с проприетарным набором реакций, авторы показали в статье успешный zero-shot перенос (применение модели к данным, которых она не видела) и дообучение на закрытых датасетах.
Допустим, вы разрабатываете аналог известного противовоспалительного препарата и вам нужен маршрут синтеза модифицированной молекулы. Вы вводите SMILES-код целевой молекулы. RetroChimera за секунды предлагает три маршрута по два-четыре шага. Первый маршрут использует коммерчески доступные реагенты. Второй задействует редкую реакцию, которую R-SMILES 2 «увидел» в данных, но которую шаблонная модель пропустила бы. Вы выбираете первый маршрут для пилотного синтеза и экономите недели лабораторного планирования.
- Принимать выход модели без проверки химиком. RetroChimera предлагает маршруты, но не проверяет условия реакции (температуру, растворитель, катализатор). R-SMILES 2 может галлюцинировать, особенно на молекулах, далёких от обучающей выборки.
- Игнорировать доступность реагентов. Модель не знает, что конкретный реагент запрещён к ввозу или стоит непропорционально дорого в вашем регионе.
- Ждать готового «нажми кнопку» интерфейса. Пока это инструмент для исследователей с минимальным опытом работы с Python, а не SaaS-платформа. Установка требует технических навыков.
- Путать ретросинтез с прямым синтезом. Модель планирует маршрут на бумаге. Лабораторная проверка обязательна.
Что это даёт вам прямо сейчас, по ролям?
Химикам и фармакологам в РФ и СНГ: синтез молекул с помощью ИИ перестаёт быть привилегией корпораций с доступом к коммерческим платформам. RetroChimera работает локально, данные не уходят на внешние серверы. Для институтов с ограниченным бюджетом это инструмент, который раньше стоил сотни тысяч долларов в виде консалтинговых часов и проприетарных лицензий.
Биотех-стартапам: открытая модель (open-source) под лицензией MIT позволяет встроить ретросинтез в свой пайплайн разработки без юридических ограничений. Дообучение на проприетарных данных подтверждено авторами в публикации Nature.
Авторам и маркетологам в теме науки: синтез молекул ИИ уже не гипотеза, а рабочий инструмент с рецензированной публикацией. Это тема для контента, которая понятна широкой аудитории через аналогию с шахматами: ИИ перебирает ходы за химика.
Я вижу в RetroChimera редкий случай, когда крупная компания отдаёт в открытый доступ не демо-версию, а полноценную модель с весами, да ещё и под MIT. Для российских лабораторий, работающих в условиях ограниченного доступа к западным SaaS-платформам, это практически подарок. Но честная оговорка: без подготовленного химика на выходе модель бесполезна. Она ускоряет планирование, но не заменяет экспертизу. Если вы из биотеха и ещё не попробовали, начните с простой молекулы, маршрут синтеза которой вы уже знаете, и сравните с тем, что предложит модель. Это лучший способ калибровать доверие к инструменту.
Для тех, кто работает с контентом и хочет разобраться, как ИИ меняет не только химию, но и вашу ежедневную работу с текстом, попробуйте наши инструменты.
Попробуйте ИИ-инструменты dzen.guru
Разберитесь, как нейросети ускоряют рутину, от текстов до аналитики, на практике, а не в теории.
Попробовать бесплатноRetroChimera уже доступна, код открыт, статья опубликована в Nature. Если вы занимаетесь синтезом молекул и до сих пор планируете маршруты вручную, сейчас подходящий момент проверить, справится ли модель с вашими задачами, пока конкуренты читают об этом в новостях.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Робот Google вырос до миллиарда пользователей за год: как устроен AI Mode изнутри
Google в октябре покажет, как масштабировать ИИ-продукт на миллиард пользователей, и пришлёт на сцену руководителя поиска, который строил Stories в Instagram и…
Benchmark собрала $2 млрд на рост: платформы стартапов по искусственному интеллекту требуют новой экономики
Компания Benchmark, одна из старейших венчурных фирм Кремниевой долины, впервые выведет всех пятерых управляющих партнёров на сцену конференции TechCrunch…
TechCrunch Disrupt раскрыл 4 критерия, по которым VCs оценивают инвестиции в стартапы
Конференция TechCrunch Disrupt 2026 назвала пять новых судей конкурса Startup Battlefield 200, среди которых бывшие топ-менеджеры Apple и Atlassian, и открыла…
Комментарии