
Microsoft CARE-X совмещает текстовый отчёт и оценку уверенности: новый подход в нейросетях для радиологии
Microsoft представила CARE-X, исследовательскую модель для анализа рентгеновских снимков грудной клетки, которая объединяет генерацию текстовых отчётов и структурированные диагностические прогнозы с калиброванной уверенностью в одном решении.
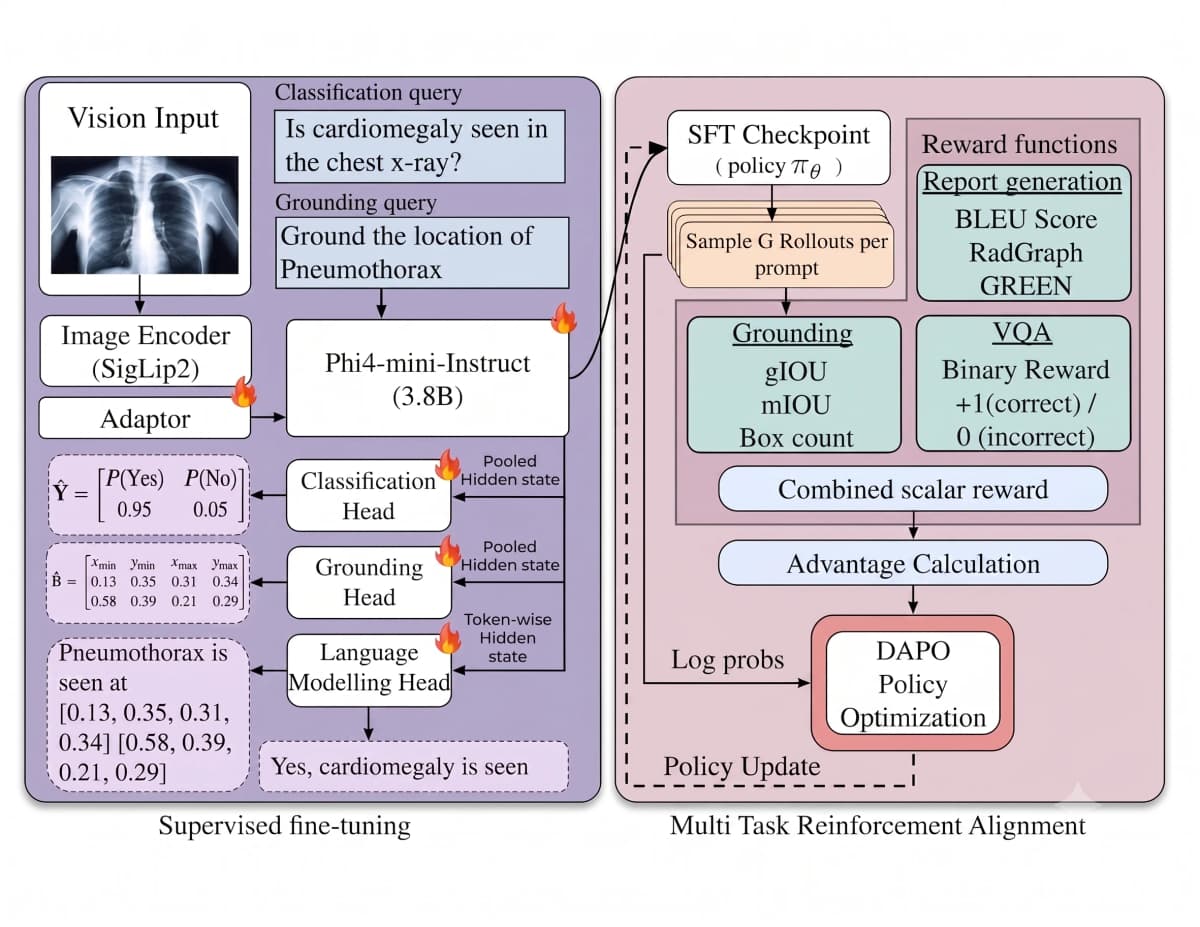
CARE-X впервые в исследовательском формате совмещает свободный текстовый отчёт и числовую оценку уверенности диагноза в одной модели, что позволяет врачу не просто читать заключение, а настраивать порог чувствительности под конкретную клиническую ситуацию.
Существующие нейросети для радиологии умеют либо генерировать текстовые описания снимков, либо выдавать структурированные диагнозы с числовой уверенностью, но не то и другое одновременно. Microsoft Research разработала CARE-X как исследовательскую модель, которая объединяет оба подхода. Модель валидирована на реальных клинических данных индийской сети больниц Narayana Health, включая редкие патологии из реанимационных отделений и состояния, подтверждённые компьютерной томографией.
Важная оговорка: CARE-X не является продуктом Microsoft, медицинским устройством и не одобрена ни одним регулятором. Все описанные результаты получены ретроспективно и не подтверждают безопасность или пригодность модели для клинического использования.
Что понадобится
- Понимание базовых принципов работы VLM (Vision-Language Model, модель, которая «видит» изображение и описывает его текстом)
- Доступ к публикации Microsoft Research для изучения архитектуры (модель не выпущена как продукт)
- Знакомство с метриками диагностической точности: чувствительность (sensitivity, доля выявленных больных среди всех больных) и специфичность (specificity, доля правильно определённых здоровых)
- Около 30 минут на разбор логики модели и применимости к вашим задачам
Три проблемы, которые CARE-X пытается решить
Прежде чем переходить к устройству модели, нужно понять, какие именно пробелы в нейросетях для радиологии она закрывает.
-
Отсутствие калиброванной уверенности. Генеративные модели выдают диагноз текстом, но не сообщают, насколько они в нём уверены. Врач не может настроить баланс между чувствительностью и специфичностью под конкретный случай. Дискриминативные модели (те, что классифицируют «да/нет») дают числовую уверенность, но не умеют писать развёрнутые отчёты.
-
Одинаковый штраф за разные ошибки при обучении. Стандартная функция потерь (cross-entropy) штрафует модель одинаково за безобидную замену слова и за пропуск жизнеугрожающей находки. Перепутать «да» и «нет» в диагнозе или пропустить пневмоторакс для алгоритма так же «плохо», как поменять синоним. Клинически это катастрофа.
-
Невозможность точных измерений. Некоторые диагнозы требуют не визуального впечатления, а конкретных замеров. Например, кардиомегалия (увеличение сердца) определяется по кардиоторакальному индексу: нужно измерить ширину сердца и грудной клетки, вычислить соотношение, учесть тип проекции снимка. Визуальная «прикидка» здесь недостаточна.
Как устроена CARE-X?
Модель построена на визуальном энкодере SigLIP2-so400M (компонент, который «читает» изображение) и языковой модели Phi-4-mini-instruct с 3,8 миллиарда параметров, соединённых через лёгкий адаптер.
Ключевая особенность: помимо генеративной «головы», которая пишет текст, модель оснащена вспомогательными «головами» для классификации и визуальной локализации. Они обучаются совместно с языковой частью, а не отдельно.
Двойной инференс (инференс, это процесс, когда обученная модель выдаёт результат на новых данных): за один проход модель генерирует и текстовый ответ, и структурированный прогноз с числовой оценкой уверенности. Врач получает и читаемый отчёт, и порог, который можно настраивать.
Для клинической корректности CARE-X использует обучение с подкреплением по методу DAPO, где вознаграждение привязано к клинической правильности, а не к «гладкости» текста. Пропуск опасной находки штрафуется сильнее, чем стилистическая неточность.
Инструментальное измерение вместо «на глаз»
В отдельном эксперименте исследователи Microsoft соединили модель Qwen3-VL-4B-Instruct с детерминированными измерительными инструментами. Задача: проверить, улучшает ли прямое вычисление (замер ширины сердца и грудной клетки в пикселях с последующим расчётом) результат по сравнению с визуальной аппроксимацией. Этот подход отделён от самой CARE-X и представляет отдельное направление исследований.
На вход подаётся рентгеновский снимок грудной клетки из индийской больницы Narayana Health. Модель CARE-X за один проход выдаёт: текстовый отчёт с описанием находок и их локализацией, структурированный прогноз по каждой патологии с числовой уверенностью (например, 0,87 для плеврального выпота), визуальную разметку области на снимке, где обнаружена аномалия. Врач видит не просто «выпот справа», а уровень уверенности модели, и может решить, при каком пороге считать находку клинически значимой.
- Принимать исследовательскую модель за готовый инструмент. CARE-X не одобрена регуляторами, не является медицинским устройством и не предназначена для постановки диагнозов пациентам. Результаты получены ретроспективно.
- Игнорировать разницу между калиброванной уверенностью и «процентом точности». Калиброванная уверенность 0,8 означает, что из всех случаев с такой оценкой примерно 80% действительно имеют патологию. Это не то же самое, что «модель точна на 80%».
- Переносить выводы на другие популяции. Валидация проведена на данных индийских больниц. Перенос на другие популяции, оборудование и протоколы съёмки требует отдельной проверки.
- Путать два эксперимента. Инструментальное измерение с Qwen3-VL-4B-Instruct это отдельное исследование, а не часть CARE-X.
Что делать с этим прямо сейчас, по ролям
Автору медицинского или научно-популярного контента на Дзене: тема калиброванной уверенности ИИ-диагноза почти не раскрыта на русском языке. Объясните читателям разницу между «модель написала красивый отчёт» и «модель сообщила, насколько она уверена в каждом пункте». Это даёт понятный и честный материал.
Клиницисту или медицинскому IT-специалисту: обратите внимание на метрики, которые CARE-X ставит во главу угла. Уверенность диагноза и штраф за пропуск жизнеугрожающей находки, это критерии, по которым стоит оценивать любую нейросеть для радиологии, не только эту.
Предпринимателю в сфере MedTech в РФ: готовых российских аналогов CARE-X с двойным инференсом на рынке пока нет. Из работающих в РФ решений для анализа медицинских снимков можно отметить платформу Botkin.AI и систему «Третье мнение». Ни одна из них не заявляет о совмещении генеративного отчёта и калиброванной структурированной классификации в одном проходе.
Подход CARE-X интересен не столько архитектурой, сколько постановкой вопроса. Большинство медицинских VLM до сих пор оптимизируются на «правильность текста», а не на клиническую безопасность. Идея штрафовать модель за пропуск опасной находки сильнее, чем за стилистику, кажется очевидной, но реализована она впервые в таком формате. По моим наблюдениям, именно калиброванная уверенность, а не качество текста, станет главным критерием при внедрении ИИ в реальную радиологию. Врачу нужен не красивый отчёт, а ответ на вопрос: «Насколько ты уверен и могу ли я на это опереться?» Честная оговорка: до клинического применения дорога длинная. Ретроспективная валидация на данных одной сети больниц ещё ничего не гарантирует. Но сам вектор исследования заслуживает внимания тех, кто строит медицинские ИИ-продукты в России.
Разберитесь в нейросетях на практике
Если вы хотите понять, как работают современные ИИ-модели и применять их в своих проектах, начните с практических разборов на dzen.guru.
Перейти к материаламДля тех, кто работает с медицинским ИИ или пишет о нём, CARE-X полезна не как готовый инструмент, а как исследовательский ориентир: какие метрики считать критичными, как совмещать текст и числа в одном проходе и почему визуальная «прикидка» при измерительных задачах уступает прямому вычислению.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Дядя Боб уместил правила для ИИ-агента в 750 слов: «готово» без теста не принимается
Роберт Мартин, автор книги «Чистый код», на днях выложил в открытый доступ ub-mode, свод правил для нейросетей, которые сами пишут код, и теперь агент обязан…
Nvidia открыла бесплатную модель распознавания речи на 40 языков: хватит одного чипа
Nvidia выпустила бесплатную открытую модель Nemotron 3.5 Transcribe для распознавания речи до 40 языков в разгар волны голосовых релизов, когда Mistral,…
Фотограф автоматизировал оцифровку плёнки 35 мм с Claude: 4 часа обработки ушли в код
Фотограф Shan выложил разбор с перепиской о том, как нейросеть Claude взяла на себя четырёхчасовую обработку плёнки 35 мм, включая аварию со сканером, и это…
Комментарии