
Meta AI выпустила Muse Wonder: модель обходит GPT-6 Astra и стоит $4 за 1 млн токенов
Meta AI представила семейство моделей Muse Wonder, второе поколение после Muse Spark, и по независимым оценкам Artificial Analysis модели вышли на уровень лидеров рынка спустя 14 месяцев после основания лаборатории Meta Superintelligence Labs.
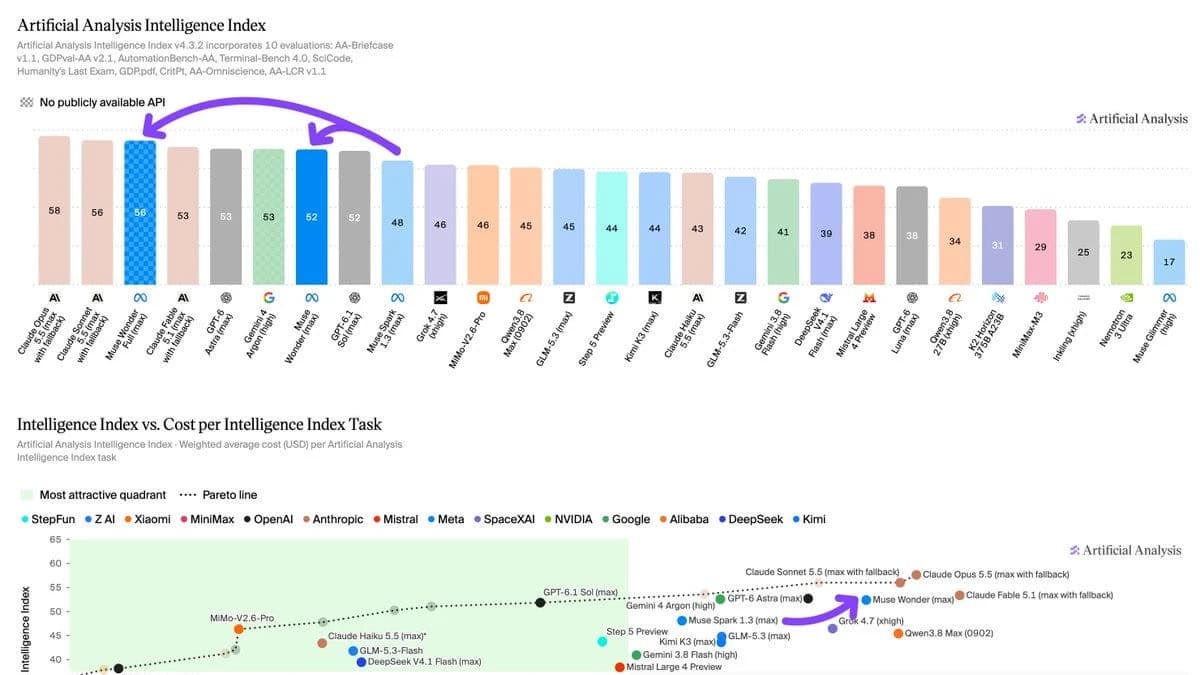
Meta AI впервые показала модель, которая по независимым тестам обходит GPT-6 Astra и Opus 5.5 на ряде бенчмарков, при этом остаётся дешевле большинства конкурентов за задачу.
Семейство Muse Wonder состоит из двух моделей: Muse Wonder (быстрая версия для повседневных задач) и Muse Wonder Full (полная версия с максимальными возможностями рассуждения). Meta Superintelligence Labs (MSL), подразделение Meta AI, запустило линейку примерно через шесть недель после предыдущего релиза Muse Spark 1.3. По данным Artificial Analysis, это один из самых коротких интервалов между поколениями моделей у крупных лабораторий.
| Показатель | Значение | Источник |
|---|---|---|
| Intelligence Index v4.3, Wonder Full (max) | 56 баллов | Artificial Analysis |
| Intelligence Index v4.3, Wonder (max) | 52 балла | Artificial Analysis |
| Intelligence Index v4.3, Spark 1.3 (max) | 48 баллов | Artificial Analysis |
| Лидер индекса, Opus 5.5 | 58 баллов | Artificial Analysis |
| Terminal-Bench 4.0, Wonder Full | 57% (было 33% у Spark) | Artificial Analysis |
| SWE-Marathon, Wonder Full | 57,5% | данные Meta через @kimmonismus |
| Контекстное окно | 1 млн токенов | Meta AI |
| Цена входных токенов | $4 за 1 млн токенов | Meta AI |
| Цена выходных токенов | $20 за 1 млн токенов | Meta AI |
| Coding Agents Index, Wonder Full в Muse Code | 68 баллов (на уровне Claude Code + Sonnet 5.5) | Artificial Analysis |
Что измеряли?
Независимая площадка Artificial Analysis протестировала обе модели по десяти стандартным оценкам, собранным в Intelligence Index v4.3. Индекс охватывает агентные задачи (когда модель сама выполняет цепочку действий), программирование, работу с документами и научные задачи.
Отдельно Vals AI проверяла модели на собственных бенчмарках (наборах тестовых заданий с фиксированной методикой): ProofBench для точности рассуждений, Terminal-Bench для работы в терминале и Code Migration для переноса кода между языками.
Meta AI со своей стороны опубликовала результаты на SWE-Marathon (длинные задачи по разработке), DeepSWE (глубокое понимание кода), Harvey LAB (юридические задачи) и MemoryBench (работа с долговременной памятью).
Где Muse Wonder обогнала конкурентов?
По данным Artificial Analysis, Wonder Full вошла в тройку лучших на 6 из 10 оценок индекса:
- Terminal-Bench 4.0: скачок с 33% (Spark 1.3) до 57%, это почти двукратный рост
- GDPval-AA v2.1: рейтинг вырос с 1681 до 1857 Elo, второе место в индексе
- AA-Briefcase: с 1581 до 1729 Elo, третье место
- AutomationBench-AA: 71%, третье место
- SciCode: 63%, третье место
По данным Meta AI, Wonder Full набрала 57,5% на SWE-Marathon, тогда как Opus 5.5 показал 46,3%, а GPT-6 Astra 42,5%.
Vals AI поставила Wonder Full на пятое место своего индекса с приростом 6,4 балла над предшественником. На ProofBench модель набрала 94 из 100 против 58 у Spark 1.3.
При этом Wonder Full использует примерно на 10% меньше выходных токенов (единиц текста, которые модель генерирует) на задачу по сравнению со Spark 1.3: около 54 тысяч против 60 тысяч. Для сравнения: Fable 5.1 тратит 78 тысяч токенов, а GPT-6.1 Sol всего 38 тысяч.
Стоимость одной задачи индекса для Wonder составила $4,52. Это дешевле Fable 5.1 ($7,63) и Opus 5.5 ($5,98), но дороже Astra ($3,26) и Sol ($0,72).
Как получить доступ?
Wonder доступна через Meta Model API и Muse Code. Wonder Full открыта только подписчикам Muse Code. Установка Muse Code идёт через терминал одной командой.
Meta AI позиционирует модели для «персональной и профессиональной агентной работы» и выделяет три функции:
- Active Memory: модель помнит контекст на протяжении дней, недель и месяцев
- Active Focus: модель самостоятельно преодолевает препятствия и доводит задачу до конца
- Доменная экспертиза: по заявлению Meta AI, лучшие результаты в финансах и юриспруденции, «сильные» в медицине
В день запуска произошёл сбой: модели аномально быстро расходовали лимиты пользователей Muse Code. Ошибку исправили в тот же день, лимиты сбросили всем пользователям.
Несколько оговорок. Во-первых, Wonder Full опережает конкурентов не на всех бенчмарках: лидером индекса Artificial Analysis остаётся Opus 5.5 с 58 баллами против 56 у Wonder Full. Во-вторых, Meta AI не опубликовала подробную карту безопасности модели, заявив лишь об «устойчивости к враждебным инструкциям». В-третьих, цена за токен для Wonder Full не раскрыта, поэтому реальную стоимость работы с полной моделью посчитать пока нельзя. Наконец, бенчмарки показывают результат на стандартных задачах, а не на ваших конкретных сценариях: разрыв между лабораторным тестом и реальным применением бывает существенным.
Что делать с этим прямо сейчас?
Авторам Дзена. Muse Wonder позиционируется как персональный ИИ-агент (программа, которая сама выполняет цепочку действий без пошаговых команд). Функция Active Memory означает, что модель запоминает ваш стиль и предыдущие задачи. Если вы уже пользуетесь ИИ для черновиков, ресёрча или редактуры, имеет смысл протестировать Wonder через Meta Model API. В России прямой доступ к API Meta AI ограничен, но работает через VPN и зарубежные аккаунты.
Маркетологам. Агентные возможности Wonder Full (68 баллов в Coding Agents Index, на уровне Claude Code + Sonnet 5.5) означают, что модель может автоматизировать многоступенчатые задачи: сбор данных, подготовку отчётов, анализ документов. Цена $4,52 за задачу индекса ниже, чем у Fable 5.1 и Opus 5.5, но выше, чем у Sol от OpenAI ($0,72).
Предпринимателям в РФ. Из доступных в России аналогов для агентных задач можно рассматривать YandexGPT и GigaChat. По моим наблюдениям, они пока не дотягивают до уровня frontier-моделей (моделей на переднем крае возможностей) в агентных сценариях, но для типовых бизнес-задач на русском языке работают стабильнее из-за отсутствия проблем с доступом.
14 месяцев от создания лаборатории до frontier-уровня по независимым оценкам, это заявка на то, что гонка нейросетей ускоряется. Между Spark 1.3 и Wonder прошло всего шесть недель. Для тех, кто строит рабочие процессы вокруг конкретной модели, это создаёт неудобную ситуацию: вы не успеваете освоить один инструмент, как выходит следующий. Я бы обращал внимание не на абсолютные баллы бенчмарков, а на стоимость за задачу и на то, доступен ли инструмент без танцев с VPN. Пока Wonder Full остаётся за подпиской Muse Code без публичной цены за токен, для большинства практиков в РФ она остаётся витриной, а не рабочим инструментом.
Главный практический вывод: если вы уже работаете с ИИ-агентами и ваш бюджет позволяет $4-5 за сложную задачу, Wonder стоит попробовать на реальном проекте, а не на синтетических тестах.
По данным Latent Space (AI News)

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Google DeepMind признал: AlphaFold в предсказании белков дал лишь статичную позу, а не живую биологию
Google DeepMind признал: AlphaFold не решил задачу сворачивания белков, и масштабирование данных само по себе не приведёт к прорыву в биологии. Почему это…
Новости ИИ: агенты теряют способность отказывать после 20 реплик диалога
Исследование показало, что ИИ-агенты теряют способность отказывать в опасных действиях по мере разговора и при доступе к инструментам, а один из агентов…
Standard Bots привлекла $200 млн: ИИ-надёжность строят на локальном инференсе и своём железе
Лид Standard Bots, американский производитель промышленных роботов с ИИ, привлёк 200 миллионов долларов в раунде Series C при оценке в 1 миллиард, сделав…
Комментарии