
mAP50 = 0,991 оказалась фикцией: как утечка данных обманывает компьютерное зрение в робототехнических системах
Компьютерное зрение выдаёт на валидации mAP50 = 0,991, но за этой цифрой может скрываться утечка данных, когда модель просто вспоминает то, что уже видела, а не распознаёт новое.
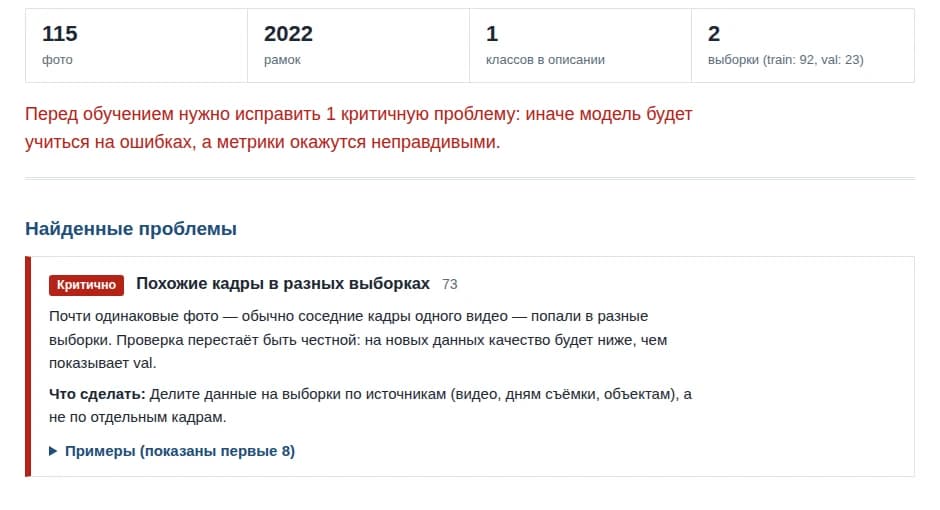
Метрика 0,991 выглядит безупречно, но если валидационные кадры почти совпадают с обучающими, она отвечает не на тот вопрос и бесполезна для реальной работы, в том числе для компьютерного зрения в робототехнических системах.
Проблему описал разработчик утилиты dataset-doctor на примере учебного датасета medical-pills из документации Ultralytics. Датасет содержит 115 фотографий таблеток (точнее, кадров одного видеоролика), разбитых на 92 обучающих и 23 валидационных. После дообучения YOLO11n за 22 минуты на процессоре Ryzen 7 метрика mAP50 (средняя точность при пороге пересечения 50%) показала 0,991. Выглядит как готовый детектор. Но проверка через dataset-doctor обнаружила, что у каждого из 23 валидационных кадров есть почти точная копия в обучающей выборке. Валидация измеряла не способность модели узнавать новые таблетки, а то, насколько хорошо она запомнила старые.
Зачем проверять метрики и кому это нужно?
mAP50 (mean Average Precision при IoU 50%, то есть средняя точность при минимальном перекрытии рамки с реальным объектом на 50%) это стандартная метрика качества в задачах детекции. Когда обучающие и валидационные данные пересекаются, метрика технически корректна, но ни о чём не говорит.
Для тех, кто строит компьютерное зрение в робототехнических системах, на производственных линиях, с камер дронов или регистраторов, это критично. Видеокадры соседних моментов почти идентичны. Случайное разбиение через стандартный train_test_split гарантирует утечку.
Что понадобится
- Python 3.8 или новее
- Установленная библиотека Ultralytics (для работы с YOLO)
- Утилита dataset-doctor (ставится одной командой из репозитория на GitHub)
- Любой датасет в формате YOLO (папки train и val с изображениями и разметкой)
- 10 минут на проверку до начала обучения
Пошаговая инструкция
- Установите dataset-doctor. Откройте терминал и выполните:
pip install git+https://github.com/8MVR3/dataset-doctor.git
- Запустите проверку на вашем датасете. Укажите путь к папке, где лежат подпапки train и val:
dataset-doctor datasets/medical-pills --out report.html
Утилита сгенерирует HTML-отчёт с перечнем найденных проблем и степенью их критичности.
-
Откройте отчёт и найдите секцию про дубликаты между выборками. Утилита использует dHash (разностный хеш, difference hash), алгоритм, который сжимает картинку до строки из 64 бит и сравнивает пиксельные переходы. Два кадра считаются почти копиями, если отличаются не больше чем на 6 бит из 64.
-
Оцените масштаб проблемы. В случае medical-pills отчёт показал 73 пары похожих кадров между train и val. Из 23 валидационных кадров у трёх расстояние до ближайшего обучающего равно нулю (полное совпадение хешей), у 17 отличие не больше 2 бит. Ни одного по-настоящему нового кадра в валидации нет.
-
Разберитесь в причинах. Если ваши данные взяты из видео, посмотрите на имена файлов. В medical-pills файлы назывались Frame_24, Frame_308 и так далее, номера шли через 4 без пропусков. Весь датасет оказался каждым четвёртым кадром одного ролика длиной около 460 кадров.
-
Исправьте разбиение. Если данные из одного видео, честное разделение на train и val невозможно в принципе: источник один. Для реальных проектов делите данные не по кадрам, а по сценам, роликам, локациям или дням съёмки. Каждая группа связанных кадров целиком уходит либо в train, либо в val.
-
Повторите обучение и сравните метрики. После честного разбиения mAP50 может упасть с 0,99 до 0,6 или 0,7. Это не провал, это реальная оценка того, как модель справится с данными, которых она не видела.
На датасете medical-pills после запуска dataset-doctor в отчёте появилась строка: «Похожие кадры в разных выборках: 73». Далее таблица показала, что Frame_28 из val совпадает с Frame_312 из train с расстоянием 0 бит, между ними 284 кадра видео. Frame_24 совпадает с Frame_308, Frame_40 с Frame_324. Сдвиг везде от 280 до 304 кадров. Гипотеза автора: одна сцена в ролике снята или смонтирована дважды. Визуально отличия между парами сводились к сдвигу камеры на пару пикселей и другому блику на фольге. Для детектора это одна и та же картинка. Обучение при этом шло стандартным скриптом без подкруток:
from ultralytics import YOLO
model = YOLO("yolo11n.pt")
model.train(data="medical-pills.yaml", epochs=60, imgsz=640, batch=16)
metrics = model.val()
Результат: mAP50 = 0,991, mAP50-95 = 0,797. Цифры честно посчитаны, но отвечают не на тот вопрос.
Случайное разбиение видеокадров. Стандартные функции вроде random.shuffle или train_test_split перемешивают кадры поштучно. Соседние кадры видео почти идентичны и неизбежно попадают в обе выборки.
Доверие к высокой метрике без проверки данных. Число 0,991 не «неправильное», оно технически корректно. Но оно отвечает на вопрос «насколько хорошо модель запомнила обучающую выборку», а не «что будет на фотографии другого блистера, при другом свете, с другого телефона».
Игнорирование источника данных. Если все фото из одного ролика, одного ракурса, одной сцены, то любое разбиение на train и val бессмысленно. Для честной валидации нужен другой источник.
Путаница между mAP50 и mAP50-95. Разница между ними (0,991 и 0,797 в данном случае) говорит о точности рамок, но обе метрики измерены на одних и тех же «утёкших» кадрах и одинаково бесполезны для прогноза.
Что с этим делать по ролям?
Автору на Дзене, который пишет про технологии или делает обзоры ИИ-инструментов: не публикуйте скриншот с mAP 0,99 как доказательство, что «детектор готов». Проверьте данные перед обучением, иначе рискуете дать читателям завышенные ожидания.
Маркетологу и продакт-менеджеру: если подрядчик показывает метрику 0,99 на компьютерном зрении, спросите, как делили данные на обучение и проверку. Попросите отчёт dataset-doctor или аналогичной утилиты. Утечка данных это не редкость, а норма для видеодатасетов без правильного разбиения.
Предпринимателю в РФ и СНГ: YOLO и dataset-doctor работают локально, без облака и без подписок. Для производственных задач (контроль качества на конвейере, подсчёт объектов с камеры) утечка между train и val означает, что модель в продакшене будет работать заметно хуже, чем на тестах. Проверка занимает 10 минут и спасает от переделки проекта.
Этот случай показывает простую вещь: метрика без контекста данных бесполезна. Я сам не раз видел, как люди (включая меня) радуются цифре 0,99 и не проверяют, на чём она получена. Автор dataset-doctor честно подчеркнул, что Ultralytics тут ни при чём: датасет medical-pills назван proof-of-concept и предназначен для демонстрации пайплайна, а не для боевого применения.
По моим наблюдениям, утечка данных между train и val встречается постоянно в проектах, где данные берут с камер видеонаблюдения, регистраторов, конвейерных линий. Особенно это касается компьютерного зрения в робототехнических системах, где камера снимает один и тот же участок с минимальными изменениями. Правило простое: делите данные не по кадрам, а по источникам. Один ролик, одна сцена, один день съёмки целиком уходит в одну выборку.
Честная оговорка: dataset-doctor проверяет визуальные дубликаты через dHash, но не ловит семантические утечки (например, одну и ту же деталь, снятую в разные дни с разных ракурсов). Для сложных случаев нужны дополнительные проверки.
Если вы работаете с видеоданными, запустите dataset-doctor до обучения, а не после. Десять минут проверки стоят дешевле, чем неделя отладки модели, которая «в тестах работала отлично, а в жизни промахивается мимо каждого второго объекта».
Научитесь проверять данные до обучения
В dzen.guru мы разбираем практические приёмы работы с нейросетями, от подготовки датасетов до оценки результатов. Без завышенных метрик.
Перейти в dzen.guru
Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
ИИ-программирование переносит нагрузку с написания кода на его проверку
Программист, который ещё вчера сам писал каждую строку кода, сегодня всё чаще описывает задачу словами и проверяет то, что за секунды сгенерировала нейросеть,…
Домашний сервер на RTX 4090 за 700 000 ₽: в 2–3 раза дешевле серверной платформы, но с оговорками
Почему это важно Сборка домашнего сервера из игровых комплектующих обходится в два-три раза дешевле серверной платформы с сопоставимой вычислительной мощностью…
DataDrops: бесплатная платформа для визуализации данных с кодом и контекстом
Визуализация данных для аналитика часто начинается с вдохновения: увидел сильный график, сохранил в закладки, а через две недели не можешь найти ни саму…
Комментарии