
LLM-шаблоны Карпаты получили формальную логику: выводы ИИ теперь можно проверить
Почему это важно Впервые LLM-шаблоны для «второго мозга» получили формальную логическую структуру, которая позволяет проверять выводы ИИ-агента на истинность,…
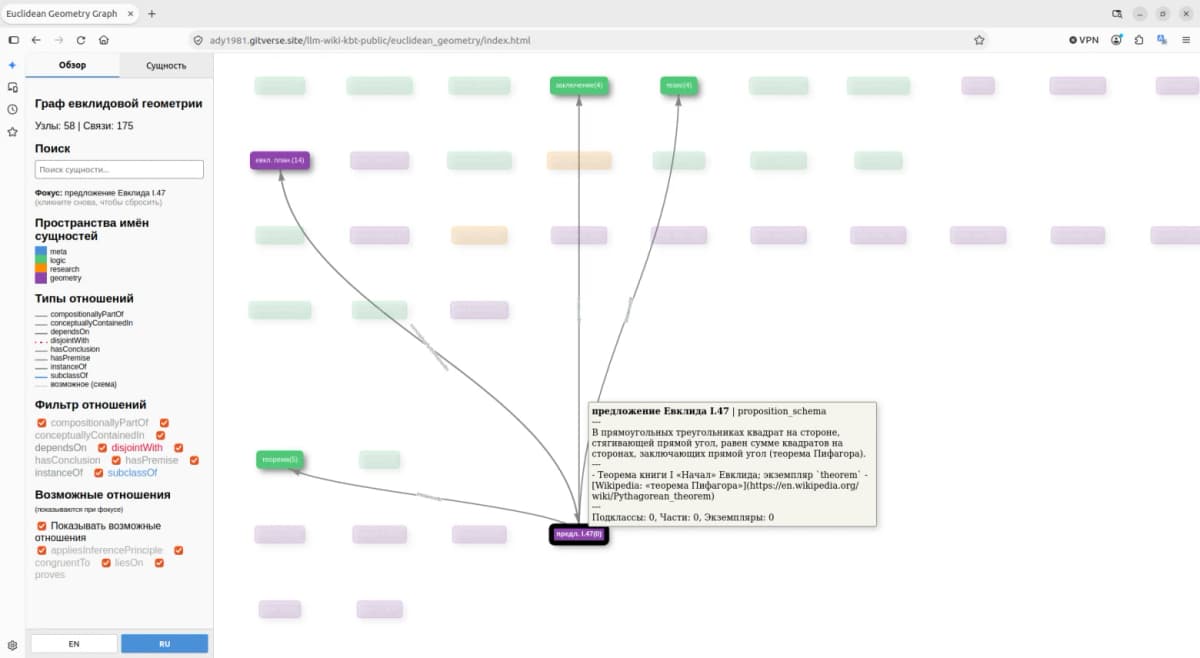
Впервые LLM-шаблоны для «второго мозга» получили формальную логическую структуру, которая позволяет проверять выводы ИИ-агента на истинность, а не просто доверять ему на слово.
Андрей Карпаты, один из ключевых исследователей в области нейросетей, предложил паттерн LLM Wiki, а два открытых проекта превратили его в готовые шаблоны: один для повседневных задач, второй для областей, где цена ошибки слишком высока.
Суть подхода: ИИ-агент (программа, которая сама выполняет цепочку действий по заданным правилам) больше не ищет информацию заново при каждом вопросе. Вместо этого он постоянно ведёт собственную вики: дополняет страницы, связывает их ссылками, отмечает противоречия и поддерживает общий обзор. Два репозитория на GitHub, llm-wiki-baseline и llm-wiki-kbt, реализуют этот паттерн с разной глубиной.
| Что | Когда | Кто выпустил | Цена |
|---|---|---|---|
| llm-wiki-baseline: шесть готовых шаблонов вики | 2026 | Открытый проект по паттерну Андрея Карпаты | Бесплатно, опенсорс |
| llm-wiki-kbt: реализация с формальной логикой и доказательными выводами | 2026 | Открытый проект, развивающий идею LLM Wiki | Бесплатно, опенсорс |
Что умеют LLM-шаблоны и чем различаются два проекта?
llm-wiki-baseline даёт шесть готовых стартовых наборов:
- Управление работой. Задачи, проекты, заметки по рабочим процессам.
- Личная и семейная жизнь. Медицинские анализы, интересы членов семьи, инвентаризация техники в доме, задания на выполнение.
- Управление проектом. Планы, роли, ресурсы.
- Управление небольшой компанией. Процессы, документы, контакты.
- Инструменты для частных инвестиций. Портфели, аналитика.
- Исследования. Источники, гипотезы, выводы.
Три слоя внутри каждого шаблона: папка raw/ хранит неизменяемые источники, wiki/ содержит страницы, которыми управляет агент, а файл AGENTS.md задаёт регламент работы.
Агент выполняет три операции: ingest (один новый источник каскадно обновляет от 10 до 15 страниц), query (ответ на вопрос по вики) и lint (периодическая проверка на противоречия, устаревшие утверждения и страницы без связей).
llm-wiki-kbt решает конкретные проблемы базовой версии:
- В baseline знание хранится как связанные текстовые страницы без формальной онтологии (строгого описания понятий и их отношений). Агент может «загаллюцинировать» (галлюцинация, когда ИИ уверенно выдумывает то, чего не было), и ложная информация попадёт в вики без способа это обнаружить.
- Все связи в baseline одного типа. В kbt появляются типизированные отношения: subclassOf (подкласс), partOf (часть целого), instanceOf (экземпляр класса), disjointWith (несовместимость) и другие.
- Каждая вики в kbt получает явно заданную перспективу рассмотрения: цель, правила, объём и точку зрения. Физик и системный администратор описывают один предмет по-разному, и это фиксируется в настройках.
- Консистентность (непротиворечивость данных) проверяют программные зонды lint, а не сама языковая модель.
Рабочая цель kbt: описать каждую сущность через существенные атрибуты, то есть свойства, без которых она перестаёт быть собой. Когда область описана так, агент способен делать дедуктивные выводы (от общего правила к частному случаю) с проверяемым основанием.
Как попробовать?
- Откройте GitHub-репозиторий llm-wiki-baseline (или llm-wiki-kbt, если нужна строгая логика). Скопируйте себе нужную папку с шаблоном вики.
- Откройте скопированную папку через OpenCode. Программа подхватит системный промпт (системный промпт, базовая инструкция, которая задаёт поведение модели) из файла AGENTS.md и начнёт управлять вики по правилам паттерна.
- Добавьте документ в папку raw/ (заметки, статьи, официальные документы, информацию из браузера) и дайте агенту команду ingest. Агент сам создаст нужные записи и выстроит связи. Файлы не в формате .md агент попробует преобразовать автоматически.
- Откройте эту же папку в Obsidian как vault (хранилище заметок): graph view покажет связи между страницами, а плагин Dataview прочитает метаданные из заголовков файлов.
Есть ли аналоги в России?
Прямого аналога LLM Wiki среди российских инструментов пока нет. YandexGPT и GigaChat умеют отвечать на вопросы по загруженным документам, но не ведут постоянную структурированную вики с проверкой противоречий. Для базовых задач (собрать заметки, задать вопрос по контексту) можно использовать эти модели. Для полноценной работы по паттерну LLM Wiki понадобится доступ к OpenCode или совместимому инструменту с поддержкой файла AGENTS.md.
Что делать с этим прямо сейчас, по ролям?
Автору Дзена. Шаблон «исследования» из baseline может стать вашим рабочим архивом: складываете в raw/ источники по теме канала, агент сам выстраивает структуру и находит пересечения между темами. Черновики статей получают фактическую базу, а не пересказ по памяти.
Маркетологу. Шаблон «управление проектом» или «небольшая компания» подходит для ведения базы знаний команды. Вместо разрозненных гугл-документов появляется единое место, где агент сам отслеживает устаревшие данные.
Предпринимателю в РФ. Шаблон «частные инвестиции» или «компания» позволяет вести структурированный учёт. Если работаете в области с высокой ценой ошибки (медицина, финансы, инженерия), берите llm-wiki-kbt: формальная логика не даст агенту подставить непроверенный вывод.
По моим наблюдениям, главная проблема «второго мозга» на базе ИИ не в том, чтобы его создать, а в том, чтобы он не врал через месяц активного использования. Baseline-версия LLM Wiki честно признаёт эту слабость и не пытается её скрыть. А kbt-версия предлагает конкретное решение: формальные схемы данных и программные проверки вместо надежды, что модель сама разберётся.
Оговорка: оба проекта требуют работы с командной строкой и OpenCode. Это не «нажал кнопку и готово». Для аудитории без технического опыта порог входа заметный.
Что сделать сегодня: откройте репозиторий llm-wiki-baseline, выберите один шаблон (например, «управление работой» или «семья»), скопируйте папку и загрузите в неё пять-десять документов, которые уже есть под рукой. Через час работы станет понятно, подходит ли вам этот формат.
Частые вопросы
Нужно ли платить за использование LLM-шаблонов?
Оба репозитория, llm-wiki-baseline и llm-wiki-kbt, распространяются бесплатно как открытые проекты. Расходы возможны только на саму языковую модель, которую вы подключите через OpenCode: если используете платный API (интерфейс для программного доступа к модели), оплата идёт по тарифам провайдера.
Чем kbt лучше baseline для обычного пользователя?
Если вы ведёте заметки о хобби или домашних делах, baseline достаточно. Kbt нужен там, где ошибка дорого стоит: медицинские данные, финансовые расчёты, инженерная документация. Разница в том, что kbt проверяет логическую непротиворечивость программными средствами, а не полагается на «здравый смысл» модели.
Можно ли использовать эти шаблоны с российскими моделями?
Паттерн LLM Wiki опирается на файл AGENTS.md с системным промптом. Теоретически его можно адаптировать под любую модель, которая умеет работать с файлами и выполнять инструкции. На практике автор проекта описывает работу через OpenCode, и совместимость с YandexGPT или GigaChat потребует ручной адаптации промптов и проверки, корректно ли модель выполняет операции ingest и lint.
Два открытых проекта дают конкретный инструмент: базовый для жизни и работы, строгий для областей, где нельзя ошибаться. Начните с пяти документов в папке raw/ и команды ingest, через час станет ясно, стоит ли перестраивать под это свою систему знаний.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Meta заблокировала 33,2 млн единиц контента: как работает ИИ-защита от абьюза детей
Meta за полгода заблокировала 33,2 млн единиц контента с насилием над детьми и впервые применила LLM для поиска скрытой рекламы, ведущей на нелегальные сайты.…
Google открыла бесплатный сервис для определения AI контента: миллион проверок в день
Google открыла для всех сайт, который проверяет, создано ли изображение, видео или аудио нейросетью, и теперь любой пользователь может провести определение AI…
Google создаёт ИИ платформу для игр
Почему это важно Google впервые выпустила платформу, где игру для браузера можно собрать текстовым промптом (текстовой командой на естественном языке) без…
Комментарии