
LLM-модели, что это и как FAIRouter сама выбирает лучшую из 428 вариантов
Когда перед вами десятки языковых моделей с разной ценой, скоростью и качеством, выбирать вручную каждый раз значит терять время и деньги: открытая библиотека FAIRouter берёт этот выбор на себя автоматически.
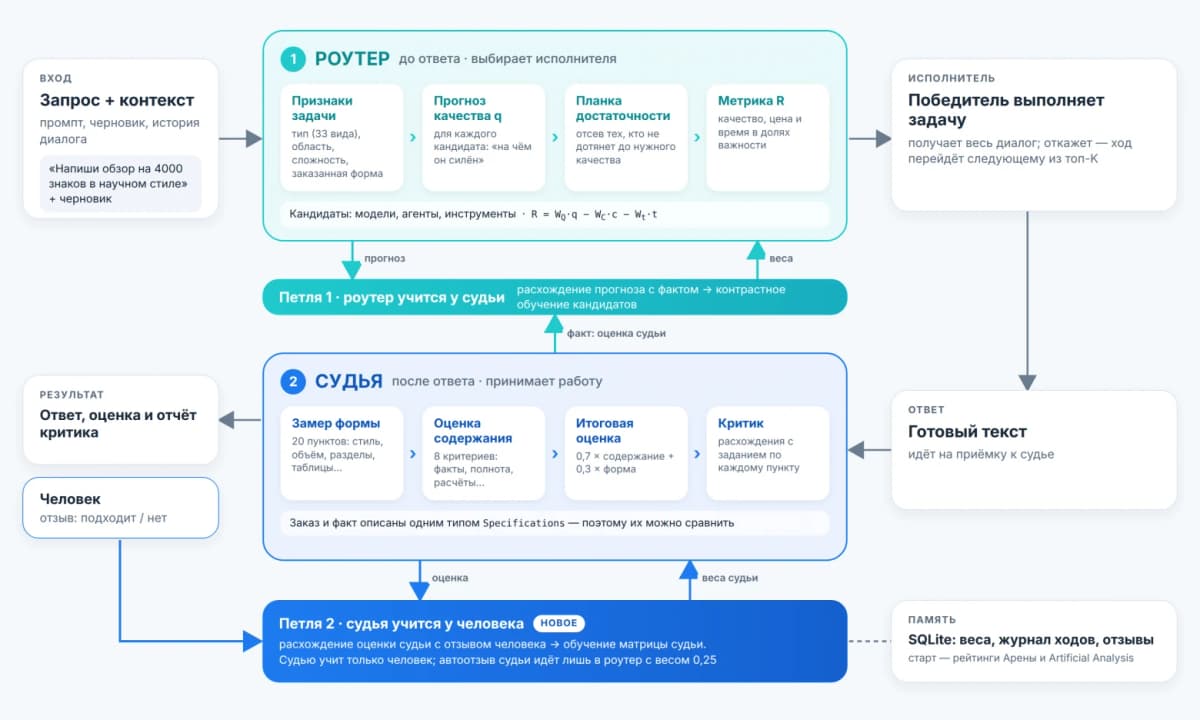
FAIRouter сама решает, какой LLM-модели (большой языковой модели, то есть нейросети, которая понимает и генерирует текст) отдать запрос, а потом проверяет качество ответа встроенным «судьёй», и всё это без ручного переключения между сервисами.
LLM-модели, что это такое на практике? Это нейросети вроде GPT, Claude, Gemini, DeepSeek, Llama, которые отвечают на текстовые запросы. Проблема в том, что одна модель хороша для креативных текстов, другая сильнее в коде, а цены между ними различаются в тысячу раз. По данным каталога OpenRouter, среди 428 моделей стоимость генерации варьируется от 0,03 до 25 долларов за миллион токенов (токен, это минимальная единица текста для модели, примерно три четверти слова). FAIRouter, открытая библиотека от команды MAS Fractal, автоматизирует этот выбор: анализирует задачу, прогнозирует качество, стоимость и скорость по каждой модели, а после ответа запускает встроенного критика, который проверяет результат. Библиотека распространяется под лицензией Apache 2.0 и доступна в двух реализациях: Python 3.11 и C# на .NET 10.
Что понадобится?
- Python 3.11 или .NET 10 (C#), в зависимости от того, в какой среде вы работаете
- API-ключ OpenRouter (или любого OpenAI-совместимого провайдера LLM-моделей)
- Доступ к GitHub для установки библиотеки
- Время на настройку: 10 минут на базовый запуск, ещё 15 минут на первый цикл обучения маршрутизатора (маршрутизатор, это механизм, который направляет ваш запрос к нужной модели)
- Минимум три модели-кандидата для маршрутизации, например: одна дорогая и точная, одна дешёвая и быстрая, одна средняя
Пошаговая инструкция
1. Установите библиотеку
Откройте терминал и выполните команду:
pip install "git+https://github.com/MASFractal/FAIRouter"
Для Python-версии файл, из которого вы делаете вызов, поместите в папку библиотеки FAIRouter/Python/.
2. Получите API-ключ
Зарегистрируйтесь на OpenRouter и создайте ключ. Привязываться именно к OpenRouter необязательно: FAIRouter работает с любым OpenAI-совместимым провайдером.
3. Инициализируйте маршрутизатор с набором моделей
Укажите модели, между которыми FAIRouter будет выбирать. Цены, размер контекстного окна и возможности библиотека подтягивает из каталога провайдера автоматически. Стартовую скорость берёт из замеров Artificial Analysis (данные есть по 147 моделям каталога), начальное качество по типам задач взято из датасетов разработчиков.
from fai_router import FaiRouter

router = FaiRouter.from_openrouter(
    api_key="ваш_ключ",
    model_ids=[
        "google/gemini-2.5-flash",
        "openai/gpt-4.1-mini",
        "anthropic/claude-haiku-4.5"
    ],
    database_path="fai-router.db",
)
4. Отправьте первый запрос
answer = router.ask("Напиши обзор методов кластеризации на 1500 знаков в научном стиле")
print(answer.winner, answer.score)   # какая модель ответила и оценка судьи
print(answer.critic)                  # расхождения с заданием по пунктам
Маршрутизатор сначала отсеивает модели, которые прогнозируемо не обеспечат нужное качество, а затем среди оставшихся ищет оптимального кандидата по комбинации качества, стоимости и времени.
5. Дайте обратную связь и обучите маршрутизатор
Если вас устроил ответ, подтвердите это. Если нет, поставьте низкую оценку. Затем запустите обучение:
router.feedback(answer.round_id, 1.0)   # 1.0 если ответ хорош
router.train(epochs=10)                  # обучение по журналу
router.save()                            # сохранение весов
С каждым циклом обратной связи маршрутизатор точнее подбирает модель именно под ваши задачи. Система учится на ваших оценках, какая модель лучше справляется с конкретными типами запросов.
6. Для диалогового режима используйте историю сообщений
Если вы работаете с черновиком или ведёте диалог, передавайте всю историю:
answer = router.ask_messages(messages)
Задание распознаётся по последней реплике, а исполнителю уходит полная история переписки.
Задача: автор Дзена пишет лонгрид и хочет, чтобы вступление было креативным, а фактчек по датам точным, при этом не переплачивая за простые запросы.
Что ввели: настроили FAIRouter с тремя моделями. Для креативного вступления отправили промпт (промпт, текстовый запрос к модели): «Напиши цепляющее вступление к статье о нейросетях в образовании, 300 слов, живой язык». Для проверки дат отправили: «Проверь, в каком году OpenAI выпустила GPT-3, ответ одной строкой».
Что получили: FAIRouter направила креативный запрос к Claude, а фактический к дешёвой Gemini Flash. Встроенный критик оценил оба ответа и указал расхождения с заданием. Автор получил два ответа без ручного переключения между моделями, при этом за простой фактчек заплатил в десятки раз меньше, чем если бы всё шло через дорогую модель.
Слишком мало моделей-кандидатов. Если указать только две модели, маршрутизатору не из чего выбирать. Начинайте минимум с трёх: дорогая и точная, дешёвая и быстрая, средняя.
Пропуск обратной связи. Без ваших оценок (команда feedback) маршрутизатор не обучается и работает только на стартовых данных. Первые 20 оценок критичны для качества подбора.
Ожидание идеала без обучения. FAIRouter не волшебная палочка «из коробки». Первые запросы могут уходить не к оптимальной модели. Прогон 10 эпох обучения после первых оценок заметно улучшает точность выбора.
Путаница с размещением файла. В Python-версии файл вызова должен лежать внутри папки библиотеки. Если файл лежит в другом месте, импорт не сработает.
Что делать с этим прямо сейчас, по ролям?
Автору Дзена: LLM-модели, что это для вас на практике? Это инструменты, которые пишут черновики, проверяют факты, генерируют заголовки. FAIRouter позволяет не разбираться, какая модель лучше для каждой задачи: описываете запрос, а маршрутизатор сам направляет его к подходящей нейросети. Экономия и на деньгах, и на переключении между вкладками.
Маркетологу: если вы используете LLM-модели для генерации рекламных текстов, описаний товаров, ответов клиентам, FAIRouter оптимизирует расходы. Простые шаблонные ответы уходят к дешёвым моделям, сложные креативные брифы к дорогим. Контроль бюджета без потери качества.
Предпринимателю в РФ и СНГ: библиотека работает с любым OpenAI-совместимым провайдером, то есть не привязана к одному сервису. Из доступных в РФ альтернатив можно подключить отечественные провайдеры, если они поддерживают совместимый API. Код открытый, разворачивается на вашем сервере, данные не уходят на сторону.
Я протестировал десятки подходов к выбору между моделями, и ручное переключение проигрывает автоматике уже при трёх разных типах задач в день. FAIRouter интересна тем, что встроенный критик не просто ставит оценку, а показывает конкретные расхождения ответа с заданием, по пунктам. Это редкость для открытых библиотек.
Честная оговорка: инструмент требует технической подготовки. Если вы никогда не работали с Python или терминалом, понадобится помощь. Библиотека молодая, документация пока ограничена репозиторием на GitHub. И ещё: качество маршрутизации напрямую зависит от того, насколько добросовестно вы даёте обратную связь в первые десятки запросов.
Попробуйте генерацию контента с нейросетями
В dzen.guru мы собрали инструменты, которые помогают авторам работать с ИИ без технического бэкграунда
Посмотреть инструментыОткрытый код и лицензия Apache 2.0 означают, что вы можете развернуть FAIRouter у себя, адаптировать под свои модели и не платить за саму маршрутизацию. Первый шаг: установите библиотеку, подключите три модели и прогоните десять запросов с обратной связью, после этого станет понятно, стоит ли перестраивать под неё рабочий процесс.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Microsoft маскирует дата центры под леса и сады: программа охватит 20+ площадок
Microsoft прячет свои дата центры в лесах и садах, маскируя многоэтажные серверные корпуса под природный ландшафт, чтобы погасить нарастающее недовольство…
Что такое галлюцинации нейросетей: люди спорят с врачами и официантами, доверяя ChatGPT
Madison, официантка из Нью-Йорка, теперь начинает каждый разговор с гостями с вопроса об аллергиях, потому что посетители всё чаще доверяют ChatGPT больше, чем…
Suno запустила генератор музыки с голосом: озвучка и саундтрек в одном запросе
Suno второго июня запустила публичную бету функции Speech, генератор музыки с голосом, который создаёт синтетическую озвучку и фоновую музыку в одном треке…
Комментарии