
Как я перестал воспринимать ИИ как человека: опыт сольной разработки двух пет-проектов
Андрей, продакт из российского банка, два месяца строил аналитический сайт по цифровым финансовым активам с помощью LLM (большой языковой модели, которая генерирует текст и код по запросу), общаясь с ней как с живой командой, и в итоге еле дотолкал до публикации урезанную статичную страницу вместо задуманного сервиса.
Ошибка Андрея типична: он тратил контекстное окно (объём текста, который модель «видит» за один сеанс) на шутки, «мозговые штурмы» и персонажей виртуальной команды, а модель воспринимала весь этот шум как равноценные данные и теряла фокус на реальной задаче.
Андрей опубликовал разбор на Хабре. Он работает с цифровым рублём и цифровыми финансовыми активами, а в свободное время пробовал так называемый вайбкодинг, генерацию кода через диалог с ИИ. Сначала попытался использовать Codex от OpenAI, но бесплатный тариф закончился быстро, а оплатить подписку из России не получилось из-за санкционных ограничений. Тогда он нашёл доступный в РФ аналог, купил годовую подписку Pro и взялся за проект.
Почему «команда» из ИИ не сработала?
Андрей выстроил процесс так, как привык работать с людьми. Назначил виртуальным «членам команды» имена и характеры. Проводил груминги (разбор задач перед спринтом), определял DOR и DOD (критерии готовности задачи к работе и критерии её завершения). Устраивал мозговые штурмы с «привлечением внешних экспертов», подключая другие LLM.
Проект быстро обрастал кодом, и казалось, что до готового продукта осталась пара итераций. Но каждое слово, каждая шутка, каждое абстрактное рассуждение оседало в контекстном окне модели. Когда Андрей просил поправить одну функцию, модель неожиданно переписывала архитектуру, потому что считала «второстепенные» сигналы такими же важными, как основную задачу.
Это и есть забивание контекста. Люди умеют фильтровать: пошутили на совещании, обсудили погоду, вернулись к делу. LLM так не умеет. Для неё всё, что попало в контекст, одинаково значимо. Когда окно переполняется, модель начинает путаться, противоречить себе и забывать цель.
Что понадобится
- Любой доступный в РФ ИИ-инструмент для генерации кода (Андрей использовал российский аналог Codex с подпиской Pro)
- Текстовый редактор для ведения отдельного файла с контекстом проекта
- Чёткое описание продукта: одна задача, один результат, без «наполеоновских планов»
- Время: 1 час на подготовку контекстного документа, далее работа сессиями по 30-60 минут
Пошаговая инструкция
-
Опишите продукт в одном абзаце. Без перечисления «грандиозных перспектив развития». Андрей хотел динамический парсинг, дриллинг по данным, регулярное обновление. В итоге выкинул всё и оставил статичный сайт, который «просто открывается и не вызывает у пользователя истерику». Начните с того минимума, который реально нужен.
-
Заведите отдельный файл с контекстом проекта. Вынесите туда структуру, стек, текущее состояние. Не держите это в чате: чат засоряется, и модель теряет фокус.
-
Не общайтесь с LLM как с человеком. Никаких шуток, персонажей, «атмосферы». Каждое лишнее слово в промпте (запросе к модели) занимает место в контекстном окне и мешает модели сосредоточиться на задаче.
-
Формулируйте запрос как техническое задание, а не как беседу. Вместо «давай обсудим, как лучше сделать парсинг» пишите конкретно:
Задача: написать функцию парсинга страницы [URL].
Входные данные: HTML-страница.
Выходные данные: JSON с полями [название, дата, сумма].
Ограничения: Python 3.11, библиотека requests + BeautifulSoup.
-
Делайте меньше итераций, но точнее. Андрей гонял десятки циклов «почти готово, ещё чуть-чуть». Каждый цикл раздувал контекст и уводил модель от цели. Лучше потратить 15 минут на точный промпт, чем час на переписку с уточнениями.
-
Используйте заглушки. Если функция пока не нужна, поставьте заглушку (пустую функцию с комментарием), а не просите модель «набросать черновик на будущее». Черновик осядет в контексте и начнёт влиять на следующие ответы.
-
Начинайте новый чат, когда задача сменилась. Контекст от предыдущей задачи мешает следующей. Перенесите в новый чат только файл с описанием проекта и конкретный запрос.
Андрей во втором проекте перестал создавать «виртуальную команду» и перешёл к коротким техническим запросам. Вместо сессии на 50 сообщений с обсуждениями и шутками он отправлял 3-5 точных промптов за сессию. Вместо «давай подумаем, какой фреймворк лучше подойдёт для нашего проекта, учитывая, что мы хотим масштабироваться» писал:
Выбери между Flask и FastAPI для REST API
с 5 эндпоинтами, без авторизации, деплой на VPS.
Критерии: скорость разработки, минимум зависимостей.
Ответ: таблица сравнения + рекомендация.
Модель отвечала по делу, не путалась в контексте и не пыталась переписывать архитектуру.
Антропоморфизация. Самая распространённая ловушка. Андрей признаёт: «со стороны это смотрелось странно, очень напоминало игру в стратегию с элементами РПГ». Модель не «вдохновляется» и не «понимает атмосферу». Она обрабатывает токены (минимальные единицы текста, на которые разбит ваш запрос).
Надежда на «ещё одну итерацию». Ощущение «почти готово, осталась пара правок» обманчиво. Каждая новая итерация раздувает контекст, и модель всё хуже держит фокус.
Экономия на описании задачи. Кажется, что быстрее объяснить «на пальцах». На деле размытый запрос порождает размытый ответ, и вы тратите больше времени на уточнения.
Смешение ролей в одном чате. Проектирование архитектуры, написание кода и отладка багов в одном диалоге, верный способ забить контекстное окно и получить кашу на выходе.
Что делать с этим прямо сейчас, по ролям
Автору Дзена. Принцип «не забивайте контекст» работает и при написании текстов. Если вы генерируете статью через ИИ, не ведите с моделью длинную беседу «а давай ещё вот так попробуем». Дайте структуру, тезисы и тон в одном промпте.
Маркетологу. Вайбкодинг выглядит как способ быстро собрать лендинг или MVP (минимальный работающий продукт) без разработчика. Опыт Андрея показывает: это реально, но только если вы сужаете задачу до минимума и не пытаетесь построить «платформу» в одном чате.
Предпринимателю в РФ. Codex от OpenAI из России недоступен по подписке напрямую. Андрей нашёл российский аналог и купил годовой Pro-план. Из доступных в РФ инструментов для генерации кода через диалог с ИИ можно рассмотреть GigaCode от Сбера или встроенные возможности YandexGPT, хотя функциональность у них пока скромнее.
История Андрея ценна не техническими деталями, а честным признанием: я разговаривал с LLM как с живым коллегой, и это сломало весь процесс. По моим наблюдениям, большинство тех, кто разочаровался в вайбкодинге, наступили на ту же граблю. Они не виноваты: интерфейс чата провоцирует на разговор, а не на команду. Но модель, это не коллега, который «поймёт из контекста». Это калькулятор с огромным полем ввода, и чем меньше мусора вы туда положите, тем точнее будет ответ. Честная оговорка: даже при идеальных промптах LLM галлюцинирует (уверенно выдумывает то, чего не было). Код надо проверять, особенно если вы не программист.
Главный вывод Андрея укладывается в одну фразу: ИИ не команда, а инструмент, и обращаться с ним нужно как с инструментом. Меньше итераций, точнее запрос, чище контекст. Не «почти готово, ещё чуть-чуть», а «одна задача, один промпт, один результат». Кто усвоит это до того, как сожжёт годовую подписку, сэкономит и деньги, и нервы.
Научитесь писать промпты, которые работают
В нашем гайде по промпт-инжинирингу (составлению точных запросов к ИИ) собраны шаблоны для авторов, маркетологов и предпринимателей
Читать гайд
Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
ИИ в производстве заборов: 636 позиций с убыточной ценой и 84% заявок, терявшихся до замера
Компания «Про-Лидер» пять недель подключала корпоративный Claude к своим пяти разрозненным системам учёта и в октябре 2026 года обнаружила, что 636 ценовых…
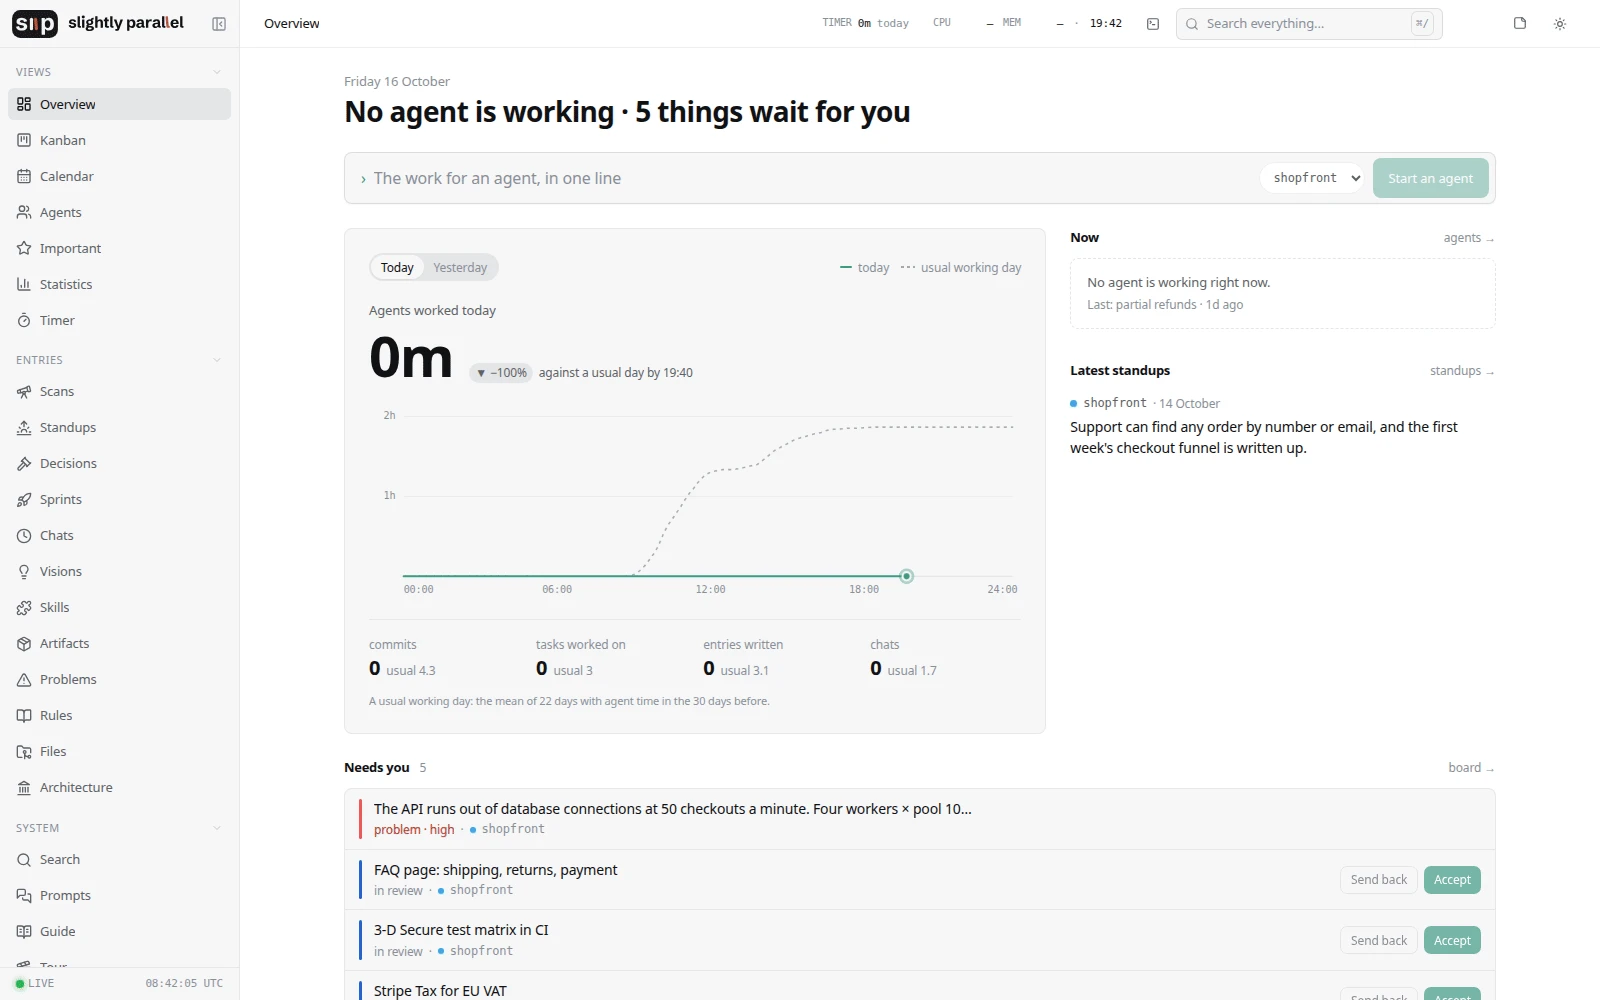
Что такое ИИ-агент без «пульта управления»: Slightly Parallel собирает все чаты в одну доску
Почему это важно Впервые появился опенсорс-инструмент, который собирает все чаты с ИИ-агентами в единую ленту и канбан-доску, причём работает локально и уже…
Обзор книги Inference Engineering: что происходит после обучения модели и как снизить счёт за GPU
Компания Кили и его книга «Inference Engineering» предлагают практическую карту для тех, кто уже обучил или выбрал языковую модель и теперь думает, как…
Комментарии