
Jev модель от экс-исследователя OpenAI: готовое решение за доли цента без генерации текста
Jev модель выдаёт готовое решение без единого слова текста, и это ломает привычную логику работы с нейросетями: вместо парсинга ответов программа сразу получает значение и степень уверенности модели за доли цента.
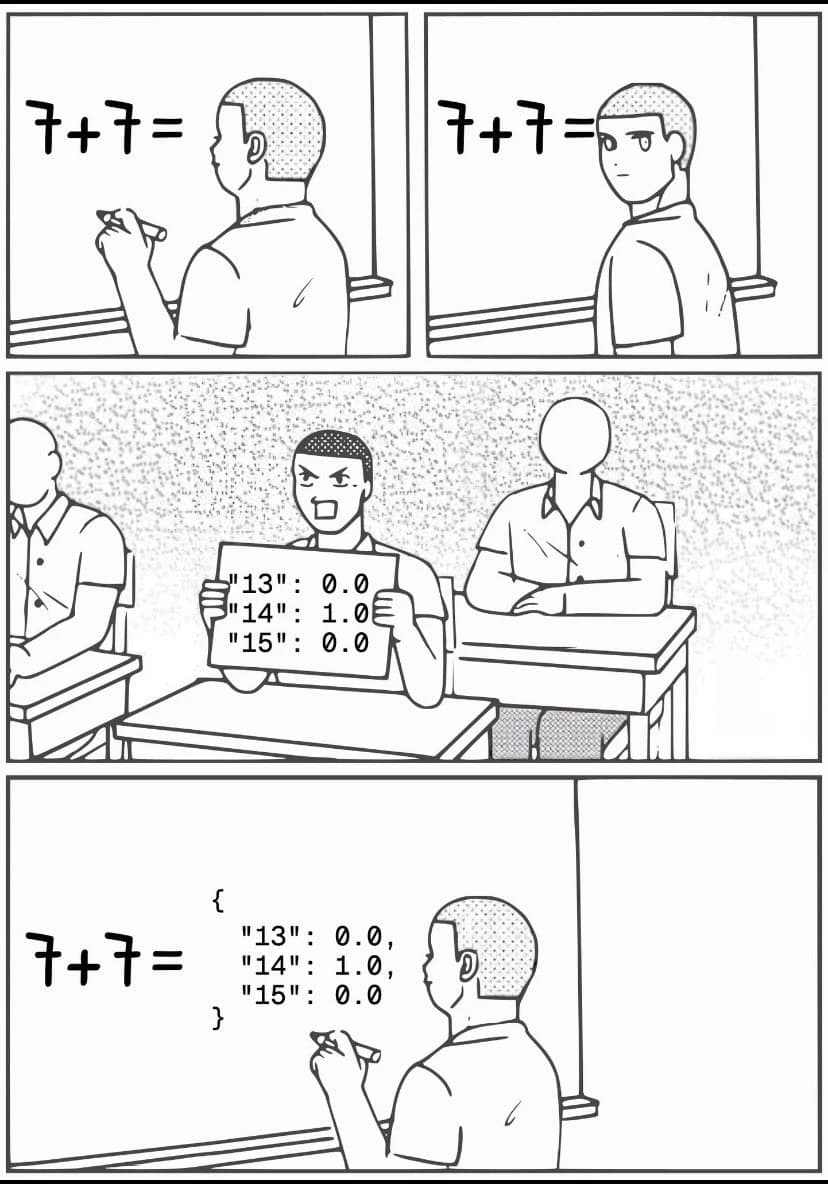
Впервые модель проектировалась не для общения с человеком, а для встраивания в код: разработчик передаёт контекст и варианты ответа, а на выходе получает одно значение с вероятностью, без генерации текста, без JSON, без парсинга.
Стартап TypeSafe AI, основанный бывшим исследователем OpenAI Диого Алмейдой, 15 сентября вышел из режима стелс и представил Jev. Алмейда участвовал в работах по InstructGPT и техническом отчёте GPT-4, а два года назад ушёл из OpenAI, чтобы строить модели для машинной автоматизации, а не для чатов. Источник: интервью TechCrunch.
| Что | Когда | Кто выпустил | Цена |
|---|---|---|---|
| Jev модель для принятия решений без текстового вывода | 15 сентября | TypeSafe AI (основатель Диого Алмейда, экс-OpenAI) | $0,042 за миллион входных токенов (токен, минимальная единица текста, которую обрабатывает модель); токены ответа бесплатны |
Зачем нужна модель, которая ничего не пишет?
Привычные модели вроде ChatGPT или Claude генерируют текст токен за токеном. Даже если программе нужен ответ «да» или «нет», большая языковая модель всё равно формирует строку, оборачивает её в JSON, а приложение потом разбирает этот JSON. Это дорого и медленно.
Jev модель работает иначе:
- Вход: неструктурированный контекст (текст письма, описание транзакции, история диалога) плюс набор допустимых значений, например
escalate = true / false. - Выход: одно значение и вероятность. Например,
true, 0.97. Без текста, без обёртки, без парсинга. - Параллельность: несколько решений модель оценивает одновременно, а не генерирует ответы последовательно.
TypeSafe называет такие модели System One Models, отсылая к «быстрой» системе мышления из книги Даниэля Канемана «Думай медленно, решай быстро» (Thinking, Fast and Slow). Условно: обычная LLM (большая языковая модель) просит «подумай и расскажи», а Jev получает варианты и выбирает.
Какие цифры называет сама компания?
По данным TypeSafe AI, задержка ответа составляет от 70 до 500 миллисекунд. В собственных тестах компания сообщала о разнице до 194 раз по скорости и до 445 раз по стоимости относительно больших языковых моделей.
Компания сама предупреждает: эти результаты получены на их внутренних сценариях и распространять их на любые задачи нельзя. Но порядок цифр объясняет, почему Jev модель привлекла внимание разработчиков.
Название тоже не случайное. Оно отсылает к экономисту Уильяму Стэнли Джевонсу и парадоксу Джевонса: когда ресурс становится дешевле, общий спрос на него не падает, а растёт. Логика TypeSafe похожа: если машинный интеллект станет на порядки дешевле, его начнут использовать там, где сегодня вызов LLM экономически бессмыслен.
Чего Jev не умеет?
Jev модель не напишет письмо, не создаст интерфейс, не объяснит квантовую механику. Область применения намного уже, чем у GPT или Claude: только выбор между заранее определёнными решениями.
Но именно в задачах классификации и маршрутизации (когда программа решает, куда передать запрос, подозрительна ли транзакция, нужен ли оператор) это ограничение превращается в преимущество: нет лишнего шага генерации, нет галлюцинаций (когда модель уверенно выдумывает то, чего не было), нет ошибок парсинга.
Как попробовать?
- Перейдите на сайт TypeSafe AI и зарегистрируйтесь для доступа к API (программному интерфейсу).
- Подготовьте задачу в формате «контекст + допустимые значения»: например, текст отзыва и варианты
positive / negative / neutral. - Отправьте запрос и получите значение с вероятностью. Парсить ничего не нужно: ответ сразу готов для кода.
Есть ли аналоги в России?
Прямого аналога Jev модели среди российских сервисов пока нет. YandexGPT и GigaChat, основные доступные в РФ модели, работают в формате генеративного чата: задаёте вопрос, получаете текстовый ответ, при необходимости парсите его.
| Параметр | Jev | YandexGPT / GigaChat |
|---|---|---|
| Формат ответа | Значение + вероятность, без текста | Текстовый ответ, часто нужен парсинг |
| Задачи | Классификация, маршрутизация, решения внутри кода | Генерация текста, ответы на вопросы, чат |
| Стоимость входных токенов | $0,042 за миллион (по данным TypeSafe) | Тарифы зависят от версии и подписки |
Для разработчиков из РФ, которые решают задачи классификации через YandexGPT, Jev может оказаться дешевле, но потребует обращения к зарубежному API. Доступность сервиса из России на момент публикации TypeSafe отдельно не комментировала.
Что делать с этим прямо сейчас?
Разработчику и техническому автору Дзена. Если вы используете GPT или Claude для простых классификаций внутри кода (спам или не спам, тональность отзыва, выбор следующего шага агента), посчитайте, сколько платите за генерацию текста, который потом выбрасываете. Jev модель убирает этот промежуточный слой.
Маркетологу. Антифрод, автоматическая модерация, скоринг лидов: везде, где решение бинарное или из короткого списка, вызов полноценной LLM избыточен. Экономия на инференсе (инференс, процесс, когда модель обрабатывает ваш запрос и выдаёт результат) может изменить юнит-экономику продукта.
Предпринимателю в РФ. Прямого российского аналога нет. Если ваш продукт зависит от массовых классификаций, протестируйте Jev на некритичных задачах и оцените задержку из вашего региона, прежде чем переносить рабочую нагрузку.
Jev модель не заменяет ChatGPT или Claude и не пытается этого делать. Но она точно попадает в больное место: разработчики годами оборачивают простые решения в дорогие текстовые вызовы и потом парсят ответы, которые им не нужны. По моим наблюдениям, до половины обращений к LLM в типичном агентном пайплайне (цепочке действий ИИ-агента) приходятся именно на маршрутизацию и классификацию, то есть на задачи, для которых генерация текста избыточна.
Оговорка: все цифры скорости и стоимости пока только от самой TypeSafe, независимых бенчмарков мы не видели. Если вы встраиваете ИИ в код, попробуйте Jev на одной задаче классификации и сравните стоимость и латентность (время ответа) с тем, что платите сейчас. Результат скажет больше любого пресс-релиза.
Частые вопросы
Jev модель заменяет ChatGPT?
Нет. Jev не генерирует текст и не ведёт диалог. Она решает узкие задачи выбора: спам или не спам, какой инструмент вызвать, передавать ли запрос оператору. Для написания текстов, кода, писем по-прежнему нужны генеративные модели.
Можно ли использовать Jev из России?
TypeSafe AI отдельно не комментировала доступность сервиса из РФ. API работает через интернет, но стоит проверить задержку и возможные ограничения на своей инфраструктуре, прежде чем переносить рабочие задачи.
За счёт чего Jev дешевле обычных моделей?
Jev не генерирует текст токен за токеном, а сразу оценивает вероятность каждого из заданных вариантов. Это убирает самый дорогой этап работы языковой модели, последовательную генерацию, и позволяет обрабатывать несколько решений параллельно. Отсюда заявленная разница в скорости и цене.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Meta Muse открыла бета-доступ через промпт: аватар, шопинг и агент на Mac
Почему это важно Meta впервые набирает тестеров нового ИИ-приложения не через закрытые формы, а через простой промпт (текстовую команду) внутри самого…
Робот Optimus от Tesla: рабочие Fremont отказываются обучать свою замену
Робот Optimus от Tesla столкнулся с двумя барьерами одновременно: сборочная линия не справляется с точностью компонентов нового V3, а часть рабочих…
Meta Muse снижает настороженность милотой: зачем компании ваша привязанность к маскоту
make the medicine go down? So I signed up and let Muse connect to my email. That's how it "gets to know you" — which is a cute way to say a large language…
Комментарии