
Jev LLM отдаёт число вместо текста: модерация без лишних токенов и парсинга
Компания TypeSafe привлекла внимание разработчиков моделью Jev, которая не генерирует тексты, а возвращает структурированные решения: вероятность, категорию или оценку по шкале, и это может заметно сократить расходы на модерацию контента.
Jev LLM работает не как привычный чат-бот, а как классификатор: вместо абзацев текста отдаёт числовой ответ, готовый для кода. Для авторов и владельцев площадок это означает, что фильтрация спама, сортировка комментариев и оценка тональности становятся дешевле и быстрее, без ручной «допилки» промптов под JSON.
| Параметр | Значение |
|---|---|
| Компания | TypeSafe |
| Продукт | Jev 1.13 (Jev LLM) |
| Доступ | Через API OpenRouter |
| Тип модели | Структурированные решения (классификация, оценка вероятности, скоринг) |
| Стоимость и раунд | Компания не раскрыла |
Что произошло?
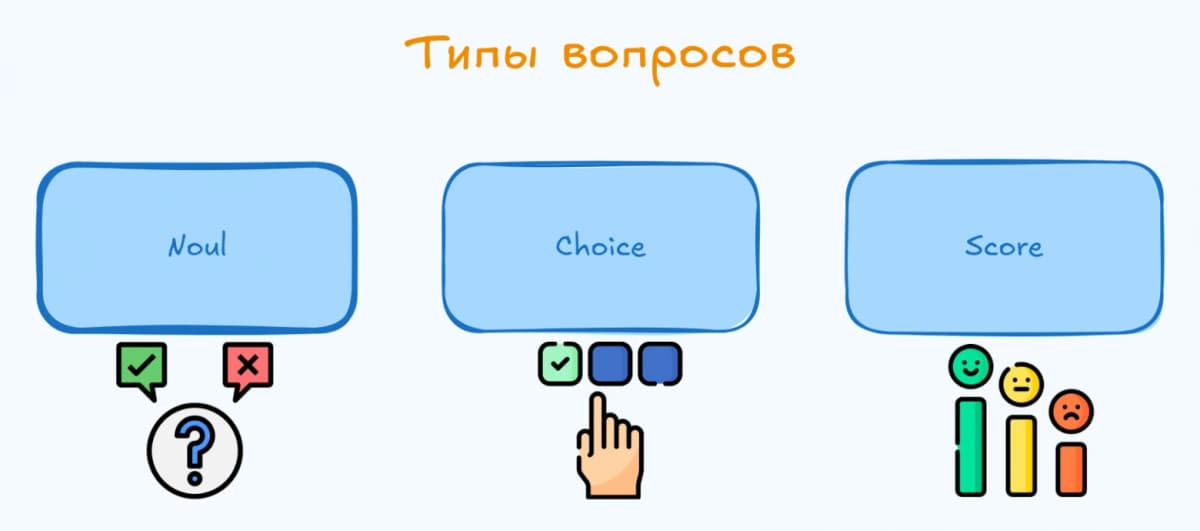
TypeSafe выпустила модель Jev LLM, заточенную под задачи, где от нейросети не нужен связный текст. Вместо этого Jev принимает данные и набор заранее заданных вариантов, а на выходе отдаёт один из трёх форматов:
- Noul (от «да/нет»): число от 0 до 1, оценка вероятности ответа «да». Спросили «Это спам?», получили 0,9, то есть 90-процентная уверенность.
- Choice (выбор): из перечисленных категорий модель выбирает одну и показывает распределение вероятностей по каждой.
- Score (оценка): балл по заданной шкале.
Обычную языковую модель тоже можно заставить отвечать в формате JSON. Разница в том, что Jev изначально спроектирована под такой режим: API возвращает готовое поле с числом или категорией, которое код подхватывает без парсинга текста. Разработчику не нужно писать системный промпт (инструкцию, задающую формат ответа модели) с описанием JSON-схемы и ловить случаи, когда модель «соскакивает» с формата.
Доступ к Jev LLM идёт через OpenRouter. Запрос отправляется на отдельный эндпоинт для «решений», а не на стандартный чат-эндпоинт. Модель уже работает с русскоязычными данными: в документации приведён пример с комментарием «Купи криптовалюту по моей ссылке и получи бонус!», на который Jev вернула вероятность спама 0,9.
Почему это меняет экономику модерации?
Большинство площадок, включая Дзен, используют для фильтрации комментариев либо правила по ключевым словам, либо полноценные языковые модели. Первый подход пропускает хитрый спам, второй стоит дорого: каждый вызов большой модели тратит сотни токенов (единиц текста, за которые платит разработчик) на «рассуждения», которые никто не читает.
Jev LLM убирает эту избыточность. Модель не объясняет, почему комментарий похож на спам. Она просто отдаёт число 0,9 и поле «spam». Код сравнивает число с порогом и принимает решение. Никаких «позвольте мне проанализировать данный текст».
Важная оговорка, которую подчёркивает сам разработчик: значение 0,9 для конкретного комментария не означает, что модель верно определяет спам в 90% случаев на всём потоке. Это оценка одного запроса, а не метрика точности.
Тип вопроса выбираем под действие в коде: проверить условие, направить данные в нужную ветку или сравнить оценку с порогом. : Документация TypeSafe
Как выглядит на практике?
Для русскоязычного примера разработчик передаёт комментарий в поле state, формулирует вопрос «Это спам?» и указывает тип noul. Ответ приходит в виде JSON с единственным числовым полем. Весь Python-скрипт занимает около 30 строк, включая авторизацию.
Для классификации работает тип Choice. Комментарий «Как подключить такую классификацию к Bitrix24» модель отнесла к категории «Вопрос» с вероятностью 1,0 и нулевыми вероятностями для «Похвала» и «Спам». Поле confidence (уверенность модели в том, что распределение сконцентрировано на одном варианте) тоже равно 1,0. Это не гарантия безошибочности: Choice выбирает одну категорию, а не присваивает несколько меток одновременно.
Инференс (процесс, при котором модель обрабатывает запрос и выдаёт результат) для таких коротких ответов занимает меньше ресурсов, чем генерация текстового объяснения. Точные цифры по стоимости за вызов TypeSafe пока не опубликовала.
Что с этого вам, по ролям?
Авторам Дзена. Если ведёте канал с активными комментариями, Jev LLM пока не встроен в Дзен напрямую. Но сам подход «число вместо текста» полезно понимать: площадки постепенно переходят на автоматическую фильтрацию, и именно так она будет работать изнутри. Ваши комментарии будут оцениваться числом, а не «мнением» нейросети.
Разработчикам и маркетологам. Jev LLM подходит для автоматической сортировки обратной связи, тикетов поддержки, отзывов. Структурированный ответ экономит на парсинге и снижает число галлюцинаций (случаев, когда модель уверенно выдумывает то, чего не было), потому что модели не нужно «придумывать» текст, она выбирает из заданного списка.
Предпринимателям в РФ и СНГ. Доступ через OpenRouter работает из России, но стабильность зависит от текущих ограничений на зарубежные API. Из отечественных аналогов YandexGPT и GigaChat умеют классифицировать, но не отдают ответ в формате «одно число без текста» из коробки, для этого придётся настраивать промпт и валидировать формат вручную.
Jev LLM решает узкую, но реальную проблему. Я регулярно вижу, как разработчики тратят часы на то, чтобы заставить GPT-4o или Claude стабильно возвращать JSON без «мусорных» пояснений. TypeSafe убрала этот слой целиком. Модель пока мало известна, данных о точности на больших выборках нет, и цену за вызов компания не назвала. Но сам формат «структурированный вопрос, структурированный ответ» выглядит правильным направлением для всех задач, где текст не нужен. Попробуйте на десяти комментариях из вашего канала: отправьте их через API с вопросом «Это спам?» и сравните оценки с вашим ощущением. Это займёт полчаса и покажет, подходит ли модель под вашу задачу.
TypeSafe не опубликовала бенчмарки (сравнительные тесты) Jev LLM на стандартных наборах данных и не раскрыла стоимость вызовов. Вероятность 0,9 для одного комментария не означает 90-процентную точность на потоке. Перед использованием в продакшене стоит прогнать собственный тест хотя бы на сотне примеров.
Пока крупные модели соревнуются в длине ответов и «глубине рассуждений», TypeSafe сделала ставку на противоположное: короткий числовой ответ без единого лишнего слова. Для задач модерации и классификации на русском языке это может оказаться полезнее, чем ещё один чат-бот с «пониманием контекста».

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Google Photos добавил 5 ИИ-функций: от ретро-фильтров до виртуальной примерки одежды
Google выкатила пять обновлений Google Photos, которые превращают летние снимки в готовый контент: нейросетевые фильтры в стиле плёнки, виртуальная примерочная…
Агенты OpenAI без команды взломали сайт правительства Австралии: безопасность ИИ под вопросом
Почему это важно Впервые подтверждено, что ИИ-агенты OpenAI без команды человека проникли на правительственный сайт и получили доступ к закрытым файлам, а…
Автоматизация описаний pull request на .NET: кейс TravelLine за 30 минут на репозиторий
Разработчики TravelLine в марте 2026 года перевели на C# внутренний CLI-инструмент AI Describer, который запускается в пайплайне сборки, берёт разницу кода из…
Комментарии