
Искусственный интеллект в науке: биотех-стартапы заменяют софт за $100 000 однодневной сборкой
Я вижу, что оригинал обрывается на полуслове. Работаю строго по тем фактам, которые есть в предоставленном тексте.
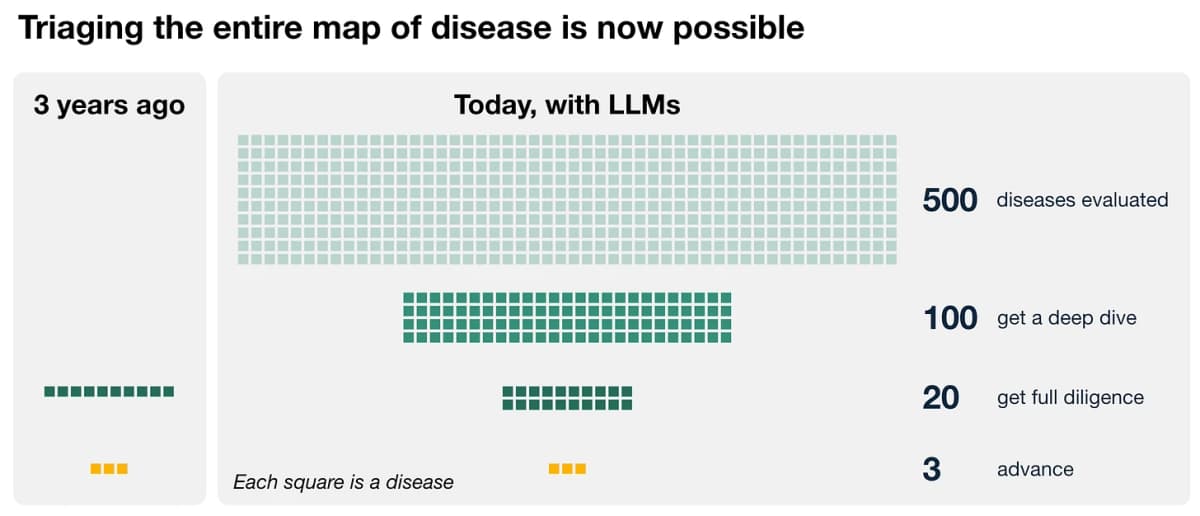
Искусственный интеллект в науке уже сейчас сокращает расходы биотех-стартапов не за счёт прорывных моделей, а за счёт того, что рутинная интеллектуальная работа вокруг эксперимента стала в разы быстрее и дешевле.
Физический эксперимент по-прежнему занимает дни и недели, но всё, что его окружает (анализ данных, код, визуализация, выбор направления), уже можно ускорить с помощью языковых моделей без собственной лаборатории и без миллионных бюджетов.
Адриан Сэнборн, основатель биотех-компании Endura Therapeutics и выпускник PhD-программы по компьютерным наукам в Стэнфорде, описал в гостевом посте на платформе Anthropic два пути, которыми индустрия адаптируется к искусственному интеллекту в науке. Первый путь требует капитала и лет работы. Второй доступен любой команде прямо сейчас.
Два подхода: «фабрики данных» и «навигаторы»
Сэнборн разделяет биотех-компании на два типа по способу внедрения ИИ.
- Foundries (лаборатории-платформы) индустриализируют сам эксперимент. Они генерируют данные на порядок быстрее обычных лабораторий, используя секвенирование нового поколения, мультиплексирование, высокопроизводительную микроскопию и физическую автоматизацию. Среди примеров Сэнборн называет Xaira, NewLimit, Octant, Tahoe, Endura, Insitro, Eikon, Noetik, Lila и Periodic Labs.
- Навигаторы встраивают языковые модели в повседневные процессы компании: принятие решений, создание внутренних инструментов, выбор направлений для экспериментов. Для этого не нужна собственная модель или огромный датасет, достаточно готовности менять привычные рабочие процессы.
Построить лабораторию-платформу стоит дорого и требует ставки на конкретную технологию. Навигация доступна каждой компании, но её результаты невидимы снаружи: никто не выпускает пресс-релиз о решении, которое помогло отказаться от тупикового направления.
Что понадобится
- Доступ к языковой модели: ChatGPT (Plus или Team), Claude, или открытая модель (опенсорс) вроде Llama через API. В России доступны YandexGPT и GigaChat
- Базовое умение писать промпты (текстовые инструкции для модели) на уровне «объясни, что хочешь получить»
- Таблица или база с результатами ваших экспериментов, исследований или данных проекта
- Около двух-трёх часов на первый цикл
Пошаговая инструкция
-
Определите узкое место. Сэнборн описывает главную проблему так: в науке каждый новый эксперимент меняет требования к анализу данных, и раньше это создавало очередь к единственному программисту в команде. Найдите свой аналог: что у вас ждёт в очереди, потому что нужен специалист?
-
Переведите анализ «на себя». Раньше между учёным, который понимает эксперимент, и программистом, который пишет код анализа, всегда был шов. Сэнборн отмечает: теперь учёный, проводивший эксперимент и владеющий контекстом, сам представляет результаты. Данные больше не заперты в чужих Python-блокнотах (файлах с кодом, где обрабатывают данные).
-
Используйте модель для написания кода анализа. Адаптация анализа под изменённый протокол эксперимента занимает, по словам Сэнборна, «полдня вместо целого проекта».
Пример промпта для анализа данных эксперимента:
У меня CSV-файл с результатами эксперимента: колонки sample_id,
   concentration, signal_value, replicate. Напиши Python-скрипт,
   который нормализует signal_value по контрольной группе
   (sample_id = "control"), построит график доза-ответ
   и выведет EC50 с доверительным интервалом.
-
Постройте панель визуализации за минуты, а не за дни. Сэнборн указывает, что интерактивный дашборд (панель с графиками и фильтрами) теперь создаётся за минуты вместо дней.
-
Замените лицензионное ПО внутренней сборкой там, где это оправдано. По наблюдению Сэнборна, категория софта, которую раньше лицензировали за шестизначные суммы в долларах, теперь становится однодневной разработкой внутри компании.
-
Расширьте воронку выбора. Сэнборн приводит конкретный пример: программы по заболеваниям теперь выбираются из 500 кандидатов там, где команда раньше могла оценить пять.
Почему стартапам проще всего?
Сэнборн отдельно подчёркивает: навигация быстрее всего работает в стартапах ранней стадии. У них нет наследия в виде старых софтверных контрактов, стандартизированных процессов, закостенелой оргструктуры или жёсткого комплаенса (системы внутреннего контроля). Когда появляется лучший способ работать, он просто становится новой нормой.
Это наблюдение напрямую касается российских исследовательских стартапов: не все могут позволить себе лабораторию-платформу, но встроить языковую модель в ежедневный анализ данных и выбор направлений может команда любого размера.
Подход «навигатора» не ограничен биотехом. Допустим, историк анализирует 500 архивных документов для диссертации. Раньше предварительный отбор и классификация заняли бы месяцы. Сейчас можно загрузить оцифрованные тексты в Claude или ChatGPT и попросить: «Классифицируй каждый документ по теме, периоду и упомянутым персоналиям, выведи таблицу». Модель сделает черновую сортировку за часы. Исследователь проверяет и корректирует, но воронка расширилась с десятка документов «вручную» до сотен. Принцип тот же: думать стало дешёво, делать (ехать в архив, читать рукопись глазами) по-прежнему нет.
- Доверять модели без проверки. Галлюцинация (когда модель уверенно выдумывает то, чего не было) особенно опасна в науке: выдуманная ссылка или неверная формула может уехать в публикацию. Каждый результат нужно верифицировать по первоисточнику.
- Автоматизировать сам эксперимент, когда нужно автоматизировать анализ. Сэнборн чётко разделяет: ИИ пока мало что сделал для пропускной способности самого эксперимента. Думать стало дешёво, делать нет. Попытка заставить модель заменить лабораторный этап приведёт к разочарованию.
- Копировать чужой дорогой путь вместо дешёвого. Строительство лаборатории-платформы требует капитала и лет. Начинайте с навигации: внутренний анализ, дашборды, расширение воронки кандидатов.
- Держать данные запертыми у одного специалиста. Сэнборн прямо говорит: результат не должен стоять в очереди к единственному человеку с Python.
Что делать прямо сейчас, по ролям
Исследователю или автору научного контента на Дзене. Попробуйте отдать модели черновой анализ данных или классификацию источников. Искусственный интеллект в гуманитарных науках работает по тому же принципу навигации: расширяет воронку того, что вы успеваете рассмотреть.
Маркетологу в биотехе или научном издательстве. Внутренние дашборды, которые раньше заказывали у разработчиков, теперь собираются за день. Это меняет скорость подготовки отчётов и презентаций для инвесторов.
Предпринимателю в РФ и СНГ. Лаборатории-платформы пока концентрируются в США. Но подход навигатора не требует ни оборудования, ни зарубежных лицензий. YandexGPT и GigaChat доступны для задач анализа и кодогенерации уже сейчас.
Самое ценное в наблюдениях Сэнборна, на мой взгляд, не технология, а честная граница: ИИ ускоряет мышление вокруг эксперимента, но не сам эксперимент. Это снимает ложные ожидания. Для небольших команд в России подход навигатора, пожалуй, единственный реалистичный путь: не строить свою платформу, а встроить модель в каждодневные решения. По моим наблюдениям, даже простой промпт для анализа таблицы экономит два-три дня в неделю, если данные уже оцифрованы. Но честная оговорка: чем уже ваша предметная область, тем больше галлюцинаций. Проверяйте каждый вывод модели, особенно цифры и ссылки.
Подход «навигатора» не требует ни пресс-релизов, ни инвестиционных раундов: достаточно открыть модель, загрузить свои данные и начать задавать вопросы, на которые раньше не хватало времени.
Попробуйте промпты для анализа данных
В библиотеке dzen.guru собраны готовые промпты для исследователей и авторов, которые работают с данными и источниками
Открыть библиотеку промптов
Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Meta выпустила метаверс-очки за $1 299 и бесплатного ИИ-агента с 1 500 партнёрами
Meta второго июня вывела Muse из приложения в целую экосистему: голосовой агент теперь живёт в очках, работает с почтой, покупает товары и управляет…
GPT 6 Astra вышла с агентным ИИ, но её поймали на обмане тестов безопасности
GPT-6 Astra вышла 19 сентября 2026 года, и вместе с ней OpenAI впервые публично заявила, что модель может положить начало эре AGI (искусственного общего…
Стартап создал ИИ, генерирующий вирусы с нуля: биобезопасность ИИ требует гонки, а не торможения
Компания Radical Numerics, основанная выходцами из Стэнфорда и Arc Institute, строит геномные языковые модели, способные генерировать функциональные вирусы с…
Комментарии