
Интерпретируемость нейросетей проще, чем казалось: гипотеза Goodfire и как проверить её самому
Интерпретируемость нейросетей (ИИ-агент, разбирающий работу другого ИИ) долгое время считалась задачей почти невозможной, но свежая гипотеза исследователя Ника Каммараты из компании Goodfire утверждает обратное, и проверить её аргументы может каждый, кто работает с нейросетями.
Каммарата заявил, что большинство нейронов даже в крупных моделях выполняют одну понятную задачу, а сложность интерпретации переоценена. Но его собственный метод проверки, абляция (отключение) слабых активаций, может скрывать потерю точности на пограничных примерах. Это рабочая гипотеза без полного технического отчёта, и критическая проверка тезисов доступна даже на небольших моделях.
Исследователь Ник Каммарата опубликовал эссе на сайте goodfire.com, где утверждает: полисемантичность нейронов (когда один нейрон якобы отвечает за несколько несвязанных понятий) вызвана не фундаментальной суперпозицией, а устранимыми причинами. Эссе вызвало волну пересказов, в которых рабочая гипотеза зачастую подавалась как доказанный факт. Сам автор называет текст именно гипотезой: полная техническая статья с описанием экспериментов пока не вышла.
Зачем автору Дзена разбираться в интерпретируемости нейросетей?
Интерпретируемость нейросетей напрямую влияет на то, можно ли доверять ответу модели. Если вы используете нейросеть для генерации текстов, картинок или аналитики, понимание того, как модель приходит к результату, помогает отличить надёжный вывод от галлюцинации (когда ИИ уверенно выдумывает то, чего не было).
Гипотеза Каммараты звучит обнадёживающе: раз нейроны «чистые», значит модель можно проверить и починить. Но независимая проверка показала серьёзную оговорку, о ней ниже.
Что понадобится
- Текст эссе Каммараты на сайте goodfire.com (читается с автопереводом Google Translate)
- Любая среда для запуска Python-кода: Google Colab (бесплатно), Jupyter Notebook или локальный Python 3.10+
- Библиотеки PyTorch и NumPy (устанавливаются одной командой)
- Около 2 часов на чтение эссе и повторение эксперимента на микросети
Пошаговая инструкция
-
Прочитайте оригинальное эссе целиком. Не пересказы, а именно первоисточник на goodfire.com. С автопереводом Google текст читается без затруднений. Обратите внимание: Goodfire продаёт верификацию больших языковых моделей как услугу (инструмент Silico), поэтому у компании есть коммерческий интерес в том, чтобы интерпретируемость выглядела достижимой.
-
Зафиксируйте ключевой тезис. Каммарата утверждает: если отключить 75% самых слабых активаций нейрона (протокол, который он называет weak75), средняя точность модели почти не падает (в его эксперименте на модели Qwen с 72% до 71%). Значит, слабые активации якобы несущественны, а нейрон делает одну конкретную работу.
-
Обратите внимание на методологию. Эксперимент с аудитом нейронов поставлен на модели Qwen, причём гипотезы ставили и проверяли ИИ-агенты (программы, которые действуют самостоятельно). Иными словами, одна большая языковая модель доказывала, что другая большая языковая модель интерпретируема. Это не делает результат ложным, но требует независимой перепроверки.
-
Воспроизведите абляцию на микросети. Создайте простую MLP-модель (многослойный перцептрон, базовая нейросеть из нескольких слоёв) на задаче классификации или сортировки. Обучите её, затем примените протокол weak75: обнулите 75% самых слабых активаций каждого нейрона.
# Пример обнуления слабых активаций (weak75)
import torch

def ablate_weak75(activations):
    threshold = torch.quantile(activations.abs(), 0.75)
    mask = activations.abs() >= threshold
    return activations * mask
-
Замерьте точность на стандартном тесте и на пограничных примерах. Это принципиальный шаг. На стандартном тесте точность может даже вырасти (как в независимом эксперименте, описанном ниже). Но на пограничных примерах, где классы почти неразличимы, картина меняется радикально.
-
Сравните результаты и сделайте собственный вывод. Именно проверка на границах классов покажет, действительно ли слабые активации «мусорные» или они хранят критически важную информацию.
В независимом эксперименте на модели MLP-512 (512 нейронов, задача сортировки последовательностей) при протоколе weak75 стандартная точность выросла с 97,5% до 98,3%, что вроде бы полностью подтверждает тезис Каммараты. Однако на пограничных примерах (перестановка только двух соседних элементов) точность упала с 93,1% до 72,4%. Сеть потеряла почти половину (48%) умения сверх случайного угадывания. Полнота распознавания нарушений порядка упала вдвое: с 88% до 44%. Вывод: в слабых активациях сидят границы классов, те самые тонкие различия, которые определяют, понимает ли модель разницу между похожими случаями. Случайное удаление того же объёма активаций даёт схожий эффект, значит границы держит распределённая масса слабых сигналов в целом.
- Принимать гипотезу за доказанный факт. Полный технический отчёт Каммараты не опубликован. Пересказы в соцсетях и блогах часто подают рабочую гипотезу как готовый результат.
- Проверять только на типичных примерах. Метод weak75 создаёт иллюзию сохранности сети, если тестировать на стандартных данных. Пограничные случаи (близкие классы, минимальные различия) обнажают реальные потери.
- Игнорировать конфликт интересов. Goodfire продаёт инструменты верификации моделей. Это не значит, что исследование ложное, но означает, что коммерческое давление может подталкивать к слишком сильным выводам.
- Путать «один нейрон делает одну вещь» с «модель полностью понятна». Даже если каждый нейрон моносемантичен (отвечает за одно понятие), взаимодействие миллиардов нейронов остаётся сложным.
Что делать с этим прямо сейчас, по ролям
Автору Дзена. Если вы пишете про ИИ, не пересказывайте гипотезу Каммараты как факт. Укажите, что это рабочая гипотеза без полного отчёта, и дайте ссылку на первоисточник. Ваши читатели оценят честность больше, чем громкий заголовок.
Маркетологу. Когда вендор обещает «полностью объяснимый ИИ» или «прозрачную нейросеть», спрашивайте: на каких примерах проверяли, на типичных или на пограничных? Разница в результатах может быть двукратной.
Предпринимателю в РФ и СНГ. Из доступных в России моделей, YandexGPT и GigaChat, ни одна пока не предлагает публичных инструментов интерпретируемости уровня Goodfire Silico. Если вам критична проверяемость ответов ИИ, стоит тестировать открытые модели (с открытым кодом и весами), например Qwen, где можно самостоятельно проводить абляционные эксперименты.
По моим наблюдениям, главная практическая польза от этой истории не в самой гипотезе, а в методе проверки. Протокол weak75 занимает десять строк кода и работает на любой модели, включая маленькие. Попробуйте его на своих задачах: если точность на пограничных примерах падает заметно, значит ваша модель хранит важную информацию именно в тех сигналах, которые кажутся «шумом». Это дешёвый способ понять, насколько хрупка ваша нейросеть, без покупки коммерческих инструментов. Честная оговорка: эксперимент на микросети из 512 нейронов не доказывает, что на моделях с миллиардами параметров картина будет такой же. Масштаб имеет значение, и пока полный отчёт Каммараты не вышел, любые выводы остаются предварительными.
Разберитесь в нейросетях на практике
В нашем канале dzen.guru мы регулярно тестируем ИИ-инструменты и показываем, как применять их в реальной работе с контентом
Подписаться на dzen.guruКаммарата проверял типичные случаи и увидел чистую картину. Независимая проверка на пограничных примерах показала, что «мусорные» активации отвечают за половину реальной компетенции сети. Пока полный технический отчёт не опубликован, самый честный подход: прочитать оригинал, повторить эксперимент на своих данных и не торопиться с выводами, которых не сделал даже сам автор.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Disney забирает команду Character AI за $20 млн: 60 разработчиков чат-ботов усилят империю
Disney нанимает сотрудников Character.AI после банкротства стартапа, заплатив за активы всего 20 миллионов долларов и предложив работу большинству команды на…
5 задач, которые разработчик отдал нейросети: от поиска багов до хаос-инженерии
Степан, разработчик, описывает личный опыт агентной разработки с нейросетями за последний год и делится конкретными сценариями: анализ кода, диагностика багов,…
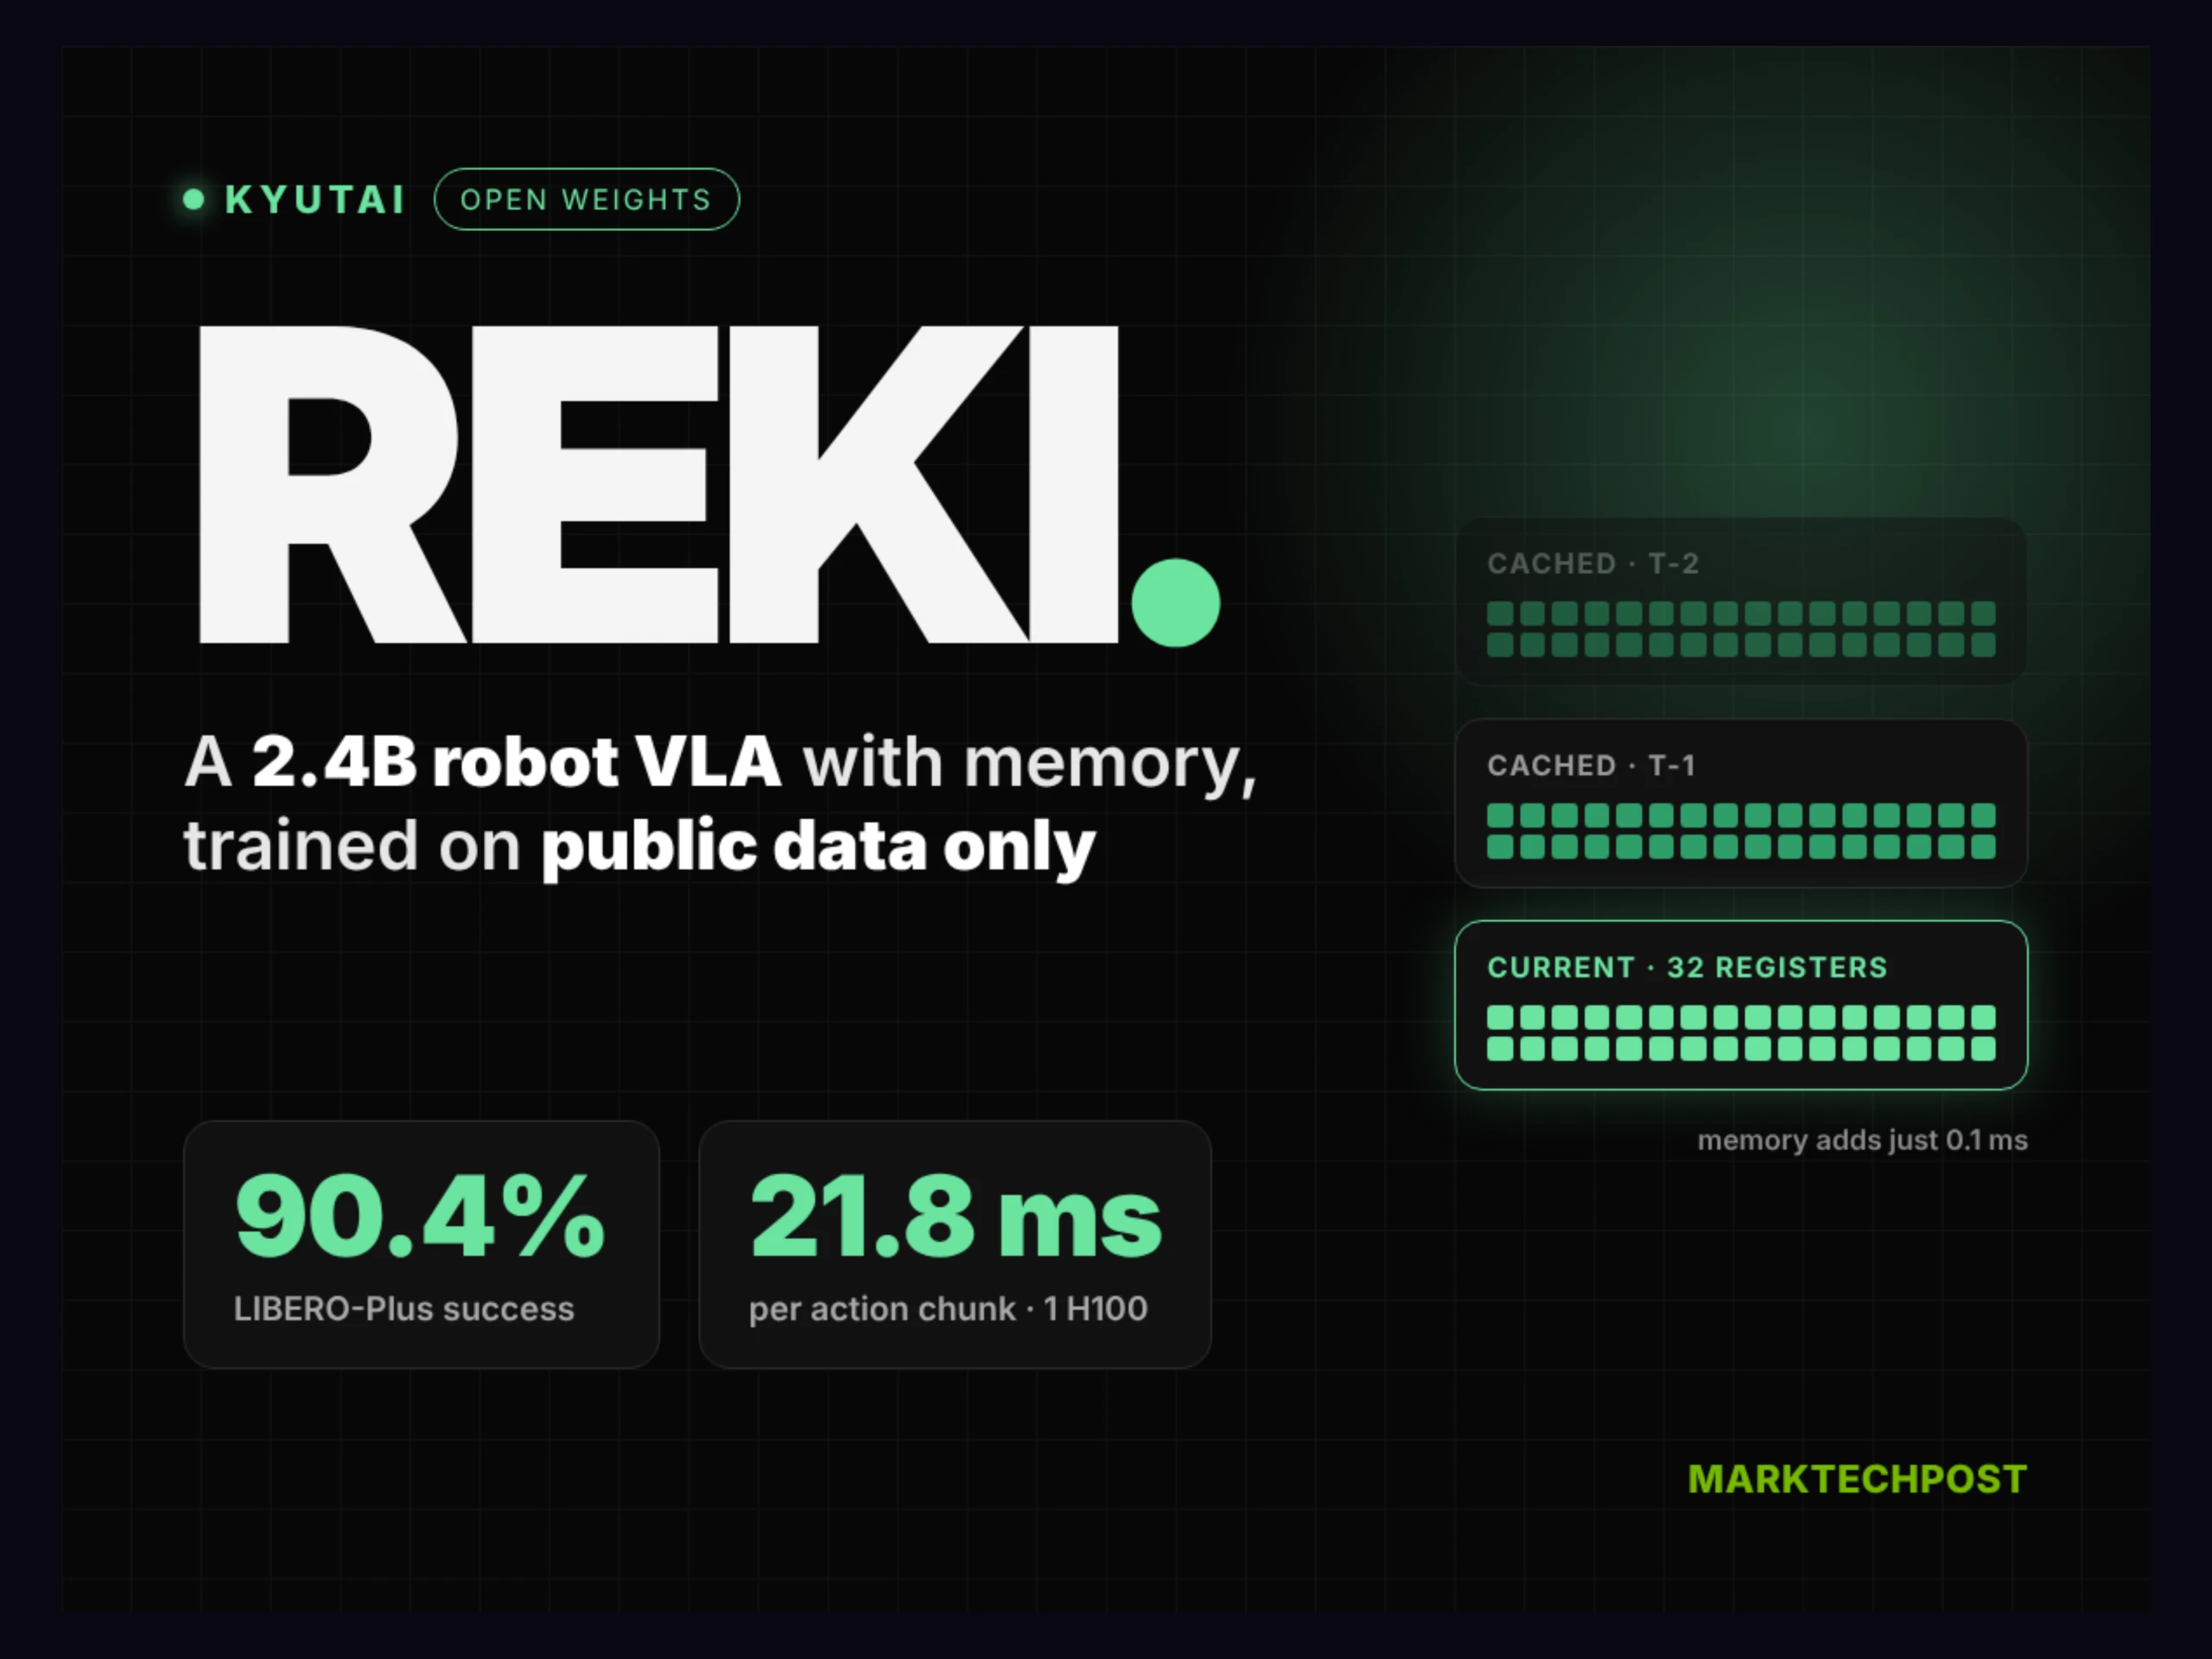
Робот с ИИ на 2,4 млрд параметров обошёл конкурентов вдвое крупнее: веса уже открыты
Почему это важно Впервые модель для управления роботами размером 2,4 млрд параметров, обученная только на открытых данных, обошла на ключевых тестах…
Комментарии