
ИИ-агенты для здоровья: как связать Apple Health, парсер и Claude в один дневник
Apple Health хранит данные в закрытой экосистеме, но отдаёт их тремя способами.
Ручной экспорт. Настройки → Здоровье → Экспортировать медданные. Выгружается ZIP с XML всех записей. Файл бывает большим, у меня около 300 МБ за несколько лет.
Ярлыки (Shortcuts). Через приложение «Команды» можно запросить конкретный тип данных за период и сохранить результат в файл. Подходит, когда нужны только тренировки за последнюю неделю.
Сторонние приложения. Health Auto Export и подобные утилиты могут выгружать данные автоматически в CSV или JSON. Удобно, но каждое такое приложение получает доступ ко всей медицинской истории.
Для моей системы хватает ручного экспорта раз в одну‑две недели. Если частота вырастет, перейду на Shortcuts.
Как парсер обрабатывает XML
Apple Health отдаёт каждую тренировку как элемент <Workout> с атрибутами: тип, дата начала, длительность, дистанция, активная энергия. Пульс хранится отдельно, в <HeartRateStatistics> или в отдельных <Record> с типом HKQuantityTypeIdentifierHeartRate.
Парсер делает четыре вещи:
- Находит тренировки за нужный период.
- Извлекает поля: тип, дата, длительность, дистанция, средний и максимальный пульс, активные калории.
- Нормализует единицы. Apple хранит дистанцию в километрах или милях в зависимости от настроек. Парсер приводит всё к километрам и минутам.
- Генерирует
source_record_id— уникальный ключ записи, чтобы при повторном импорте не создать дубль.
Ключ дубликата я строю из sourceName + startDate + workoutActivityType. Если файл с таким ключом уже существует, парсер дополняет пустые поля, но не трогает заполненные вручную.
import xml.etree.ElementTree as ET
from pathlib import Path
import hashlib, json

def parse_workouts(export_path: str, since: str):
    tree = ET.parse(Path(export_path) / "export.xml")
    root = tree.getroot()
    workouts = []
    for w in root.iter("Workout"):
        if w.get("startDate", "") >= since:
            uid = hashlib.md5(
                f'{w.get("sourceName")}{w.get("startDate")}{w.get("workoutActivityType")}'
                .encode()
            ).hexdigest()[:12]
            workouts.append({
                "source_record_id": uid,
                "workout_type": w.get("workoutActivityType"),
                "workout_date": w.get("startDate")[:10],
                "workout_time": w.get("startDate")[11:16],
                "duration_min": round(float(w.get("duration", 0))),
                "distance_km": round(float(w.get("totalDistance", 0)), 2),
                "active_kcal": round(float(w.get("totalEnergyBurned", 0))),
            })
    return workouts
Скрипт минимальный. Пульс из <HeartRateStatistics> можно добавить вторым проходом по <WorkoutStatistics> внутри каждого <Workout>.
Как агент обрабатывает ввод
Агент — это системный промпт (постоянная инструкция, которую модель получает до вашего сообщения) плюс доступ к файлам Obsidian. Я использую Claude с подключённой папкой через MCP.
Задача агента — превратить короткое сообщение в структурированную запись. Вот как выглядит типичный обмен:
Я пишу:
Пробежал 3 км, колено ноет после второго километра, пульс не смотрел
Агент находит сегодняшний файл тренировки (или создаёт новый по шаблону), заполняет:
distance_km: 3pain_level: 1- В секцию «Факт» добавляет: «Бег 3 км. Боль в колене после 2-го км.»
- Исходное сообщение сохраняет в секцию «Сырой ввод».
Агент не заполняет поля, которых нет в сообщении. Пульс остаётся пустым до импорта из Apple Health.
Системный промпт агента
Ты — ассистент по ведению дневника тренировок в Obsidian.

Правила:

1. Не давай медицинских рекомендаций. Не интерпретируй боль.
2. Если поле не упомянуто в сообщении, оставь его пустым.
3. Не путай «не записано» с «нет». Пустое поле ≠ 0.
4. Сохраняй исходный текст пользователя без изменений.
5. При конфликте между ручной записью и импортом спроси.
6. Недельную сводку готовь только по запросу.
Агент не принимает решений о нагрузке. Он может показать, что за неделю пульс рос при той же дистанции, но вывод делает человек.
Недельная сводка
Раз в неделю я прошу агента собрать итог. Запрос простой:
Собери сводку за эту неделю
Агент проходит по файлам тренировок, берёт заполненные поля и возвращает таблицу:
| Дата | Тип | Дистанция | Ср. пульс | Боль | Заметка |
|---|---|---|---|---|---|
| 07-14 | Бег | 2.1 км | 131 | 0 | Лёгкий темп |
| 07-15 | Бег | 3.0 км | — | 1 | Колено после 2 км |
| 07-17 | Подтяг. | — | — | 0 | 5×8, последний подход тяжёлый |
Под таблицей агент добавляет наблюдения без оценок: «Дистанция выросла на 0.9 км, данных о пульсе за 15-е нет, боль появилась впервые за неделю».
Решение принимаю я. В данном случае: не увеличивать дистанцию, пока колено не перестанет напоминать о себе два занятия подряд.
Почему агент не должен давать советы
В системном промпте я явно запретил медицинские рекомендации. Причин три.
Языковая модель не имеет доступа к полной клинической картине. Она видит только то, что я записал. А я записываю не всё.
Галлюцинация (когда модель уверенно выдаёт несуществующий факт) в контексте здоровья опаснее, чем в любом другом. «Снизь нагрузку на 20%» звучит разумно, но без знания анамнеза может быть и слишком много, и слишком мало.
Ответственность. Если агент посоветовал, а я послушал и стало хуже — виноват я, но ощущение будет другим. Чёткая граница «агент показывает, человек решает» убирает эту ловушку.
Что дальше
Сейчас система работает для бега и силовых. Следующий шаг — добавить сон. Apple Watch записывает фазы сна, и было бы полезно видеть качество сна рядом с нагрузкой предыдущего дня.
Второе — автоматизировать импорт через Shortcuts, чтобы не делать ручной экспорт. Пока это не критично при частоте раз в две недели.
Третье — попробовать ту же схему для анализов. Структура та же: шаблон с YAML-полями, агент для ввода, запрет на интерпретацию результатов.
Система намеренно простая. В ней нет машинного обучения, нейросетевых моделей или предиктивной аналитики. Это текстовые файлы, парсер и языковая модель, которая помогает их заполнять и читать. Вся ценность — в том, что план, факт и контекст лежат рядом.
Исходники парсера, шаблоны Obsidian и системный промпт агента я выложу в репозиторий, когда допишу документацию. Подписывайтесь, чтобы не пропустить.
Источник: https://thisnot.blog/posts/health-tracking-agent

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Google разворачивает ИИ в медицине Сингапура: $7 млн на науку и ИИ-коуч для жителей
Google на саммите Google for Health Summit объявила о развёртывании передового ИИ во всей системе здравоохранения Сингапура, где старение населения…
Google расширяет рекламу в ИИ-поиске на весь мир: рост поиска замедлился до 12%
Google на квартальной отчётной конференции Alphabet объявила, что выводит рекламу в ИИ-поиске за пределы США, и сделала это на фоне замедления роста поисковой…
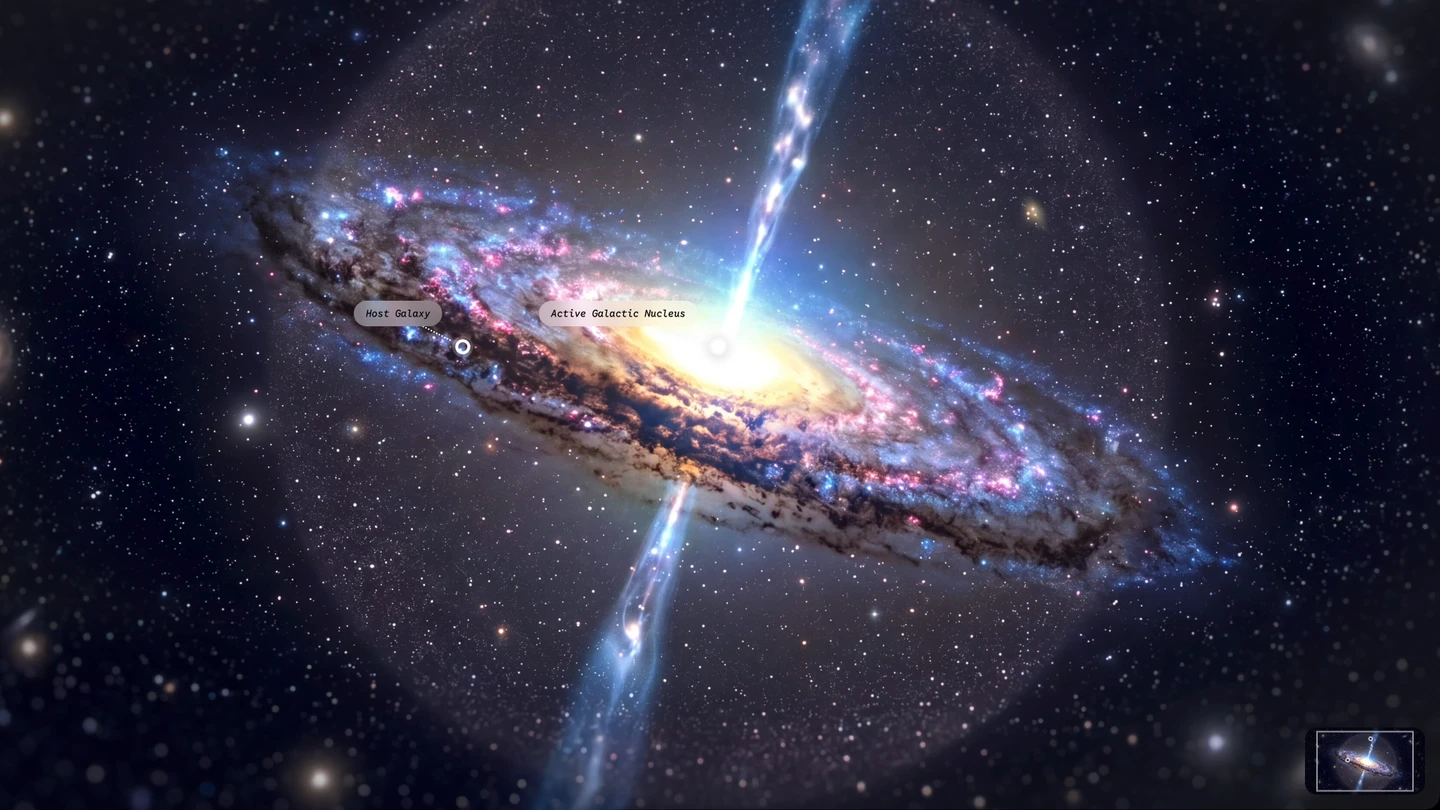
Gemini открыл интерактивные сцены для всех: 6 языков, русского среди них нет
Чат-бот Gemini открыл библиотеку погружений в темы, интерактивных сцен от атомов до дальнего космоса, и запустил её сразу для всех пользователей, хотя русского…
Комментарии