
Haiku поставила PASS и нашла существенную ошибку: как мы разбирали отчёт ревью
Когда вы доверяете ИИ-ревьюеру проверку своих текстов, модель может одновременно поставить вердикт «всё в порядке» и тут же указать на серьёзную ошибку в том же отчёте.
Haiku поставила PASS и нашла существенную ошибку в одном и том же отчёте. Если вы строите редакционный конвейер с ИИ-проверкой, такой разбор покажет, почему нельзя доверять ни вердикту целиком, ни отдельному замечанию, не сверив их друг с другом и с исходником.
Этот разбор появился из реальной сессии: при вычитке десяти статей для блога модель anthropic/claude-haiku-5.5 (закрытая модель (closed-source), работающая через маршрутизатор OpenRouter) выдала отчёт, где итоговый вердикт PASS соседствовал с замечанием уровня major. Системный промпт (system prompt, набор правил, по которым модель формирует ответ) требовал считать фактические ошибки и смысловые противоречия блокирующими. Значит, PASS и major в одном документе друг другу противоречат. Разбираемся, как именно мы это проверяли и что из этого взять в свой процесс.
Что понадобится
- Доступ к любой проверяющей модели (Haiku, GPT-4o, GigaChat или YandexGPT подойдут для аналогичного конвейера).
- Исходный текст и его отредактированная версия, оба файла в сохранности.
- Системный промпт с правилами проверки и градацией серьёзности замечаний.
- Формат отчёта, где модель возвращает вердикт, уровень серьёзности каждого замечания и точные цитаты из проверяемого текста.
- Около 30 минут на ручную сверку одного отчёта.
Пошаговая инструкция
-
Получите отчёт и сразу проверьте согласованность вердикта с замечаниями. Если вердикт PASS, а хотя бы одно замечание имеет уровень major или blocker, перед вами противоречие. Не принимайте ни то, ни другое на веру.
-
Откройте замечание и найдите цитату в исходном файле. Модель может ссылаться на фрагмент, которого в тексте нет. В нашем случае Haiku предложила убрать экранирование (обратные слеши перед кавычками) в строке. Но в исходном Markdown обратных слешей не было: они появлялись только в JSON-обёртке при передаче. Замечание описывало артефакт формата, а не содержание статьи.
-
Проверьте, ту ли версию файла описывает замечание. В черновике кандидату советовали задавать вопросы работодателю и ссылались на статью о скрининге. Но связанная статья рассказывала о вопросах рекрутера кандидату, то есть роли были перепутаны. Мы исправили описание ссылки. Haiku заметила смену ролей и предложила вернуть исходник. Частично замечание было полезным: при нашей правке действительно потерялся совет кандидату самому задавать вопросы. Но возврат всей фразы восстановил бы неверное описание ссылки.
-
Дайте модели недостающий контекст и перепроверьте. Полного текста связанного материала модель сначала не получила, только название и адрес. Мы добавили текст статьи и сохранили обе мысли: кандидат уточняет задачи роли, а отдельная статья помогает подготовиться к вопросам рекрутера. Повторная проверка подтвердила читаемость и сохранность смысла. Итоговый вердикт стал RISK с необязательными замечаниями.
-
Примите полезные правки, отклоните ложные, задокументируйте решение. Полезные замечания тоже были. Вместо «Само число можно не выносить…» написали «Итоговую цифру стажа можно не выносить…». В статье о наставничестве переставили абзацы: сначала сбор фактов, затем подготовка истории для интервью. Изменённые статьи проверили повторно, исходники сохранили.
-
Добавьте автоматический сигнал для будущих отчётов. Правило простое:
Если вердикт == PASS и любое замечание имеет severity == "major" или "blocker":
    пометить отчёт флагом CONFLICT → ручной разбор обязателен
Такой сигнал обнаружит противоречивый отчёт, но сам по себе не установит, есть ли ошибка в статье. Замечание тоже нуждается в проверке.
Чек-лист сверки для каждого замечания
Четыре вопроса, которые мы задавали по каждому пункту отчёта:
- Ту ли версию файла описывает замечание?
- Существует ли цитата в исходнике?
- Сохраняет ли предложенная правка условия и роли участников?
- Согласуется ли общий вердикт с содержанием замечаний?
Если хотя бы на один вопрос ответ «нет», замечание уходит на ручную проверку. Автоматическое принятие исключено.
Фрагмент отчёта, который мы получили:
{
  "verdict": "PASS",
  "meaning_preserved": true,
  "issues": [{"severity": "major"}]
}
В соседнем замечании модель написала: «это существенное искажение совета». Вердикт PASS при наличии major нарушает собственные правила отчёта. Мы не стали ни слепо принимать PASS, ни слепо откатывать правку. Вместо этого прошли чек-лист, нашли, что замечание частично верное (потерян совет кандидату), но предложенный откат целиком восстановил бы неверное описание ссылки. Решение: дополнить контекст модели и переписать абзац, сохранив обе мысли.
Слепое доверие вердикту. PASS не означает «ошибок нет». Это означает, что модель по своей логике решила пропустить текст, но её же замечания могут этому противоречить. Подробную градацию уровней серьёзности в нашем случае мы не задавали, и модель интерпретировала границу сама.
Слепое доверие замечанию. Замечание про экранирование кавычек описывало артефакт JSON-обёртки, а не содержимое файла. Если бы мы приняли его автоматически, в тексте появилась бы бессмысленная правка.
Отсутствие контекста. Модель не получила полный текст связанной статьи и оценила правку без понимания, о чём там речь. Добавление контекста изменило и замечание, и вердикт.
Попытка обобщить на всю модель. Это разбор одной сессии. Частоту ошибок Haiku и качество относительно других проверяющих моделей мы не измеряли. Не стройте выводы о надёжности модели по одному случаю.
Что делать с этим прямо сейчас?
Автору на Дзене. Если вы прогоняете черновик через ИИ-проверку, не принимайте итоговый ярлык как финальное решение. Откройте каждое замечание, найдите цитату в своём тексте, задайте четыре вопроса из чек-листа выше.
Маркетологу и редактору. Добавьте в конвейер автоматический флаг конфликта: вердикт PASS плюс замечание уровня major или blocker равно обязательный ручной разбор. Это не заменяет редактора, но экономит время на сортировке.
Предпринимателю в РФ. Haiku доступна через OpenRouter. Из российских аналогов для подобного конвейера подойдут YandexGPT и GigaChat, принцип сверки вердикта с замечаниями работает с любой моделью.
По моему опыту, главная ловушка не в том, что модель ошибается, а в том, что она ошибается уверенно и внутренне противоречиво. PASS в заголовке отчёта успокаивает, а major в теле замечания тревожит, и автор выбирает то, что удобнее. Мы проверяли десять статей в этой сессии, и полезные правки действительно были: уточнение формулировок, перестановка абзацев в логичном порядке. Но каждая из них потребовала ручной сверки. Пока ни одна модель не умеет гарантированно согласовывать собственный вердикт с собственными замечаниями. Используйте ИИ-проверку как второго читателя, а не как финального редактора.
Попробуйте ИИ-инструменты dzen.guru
Мы собираем практики работы с ИИ для авторов и редакторов. Проверьте, какие инструменты помогут вашему контенту.
Перейти к инструментамПротиворечивый отчёт не повод отказываться от ИИ-проверки. Это повод выстроить процесс так, чтобы ни один вердикт не проходил без сверки с замечаниями и исходником. Чек-лист из четырёх вопросов занимает пять минут на статью и ловит именно те случаи, где модель уверенно противоречит сама себе.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
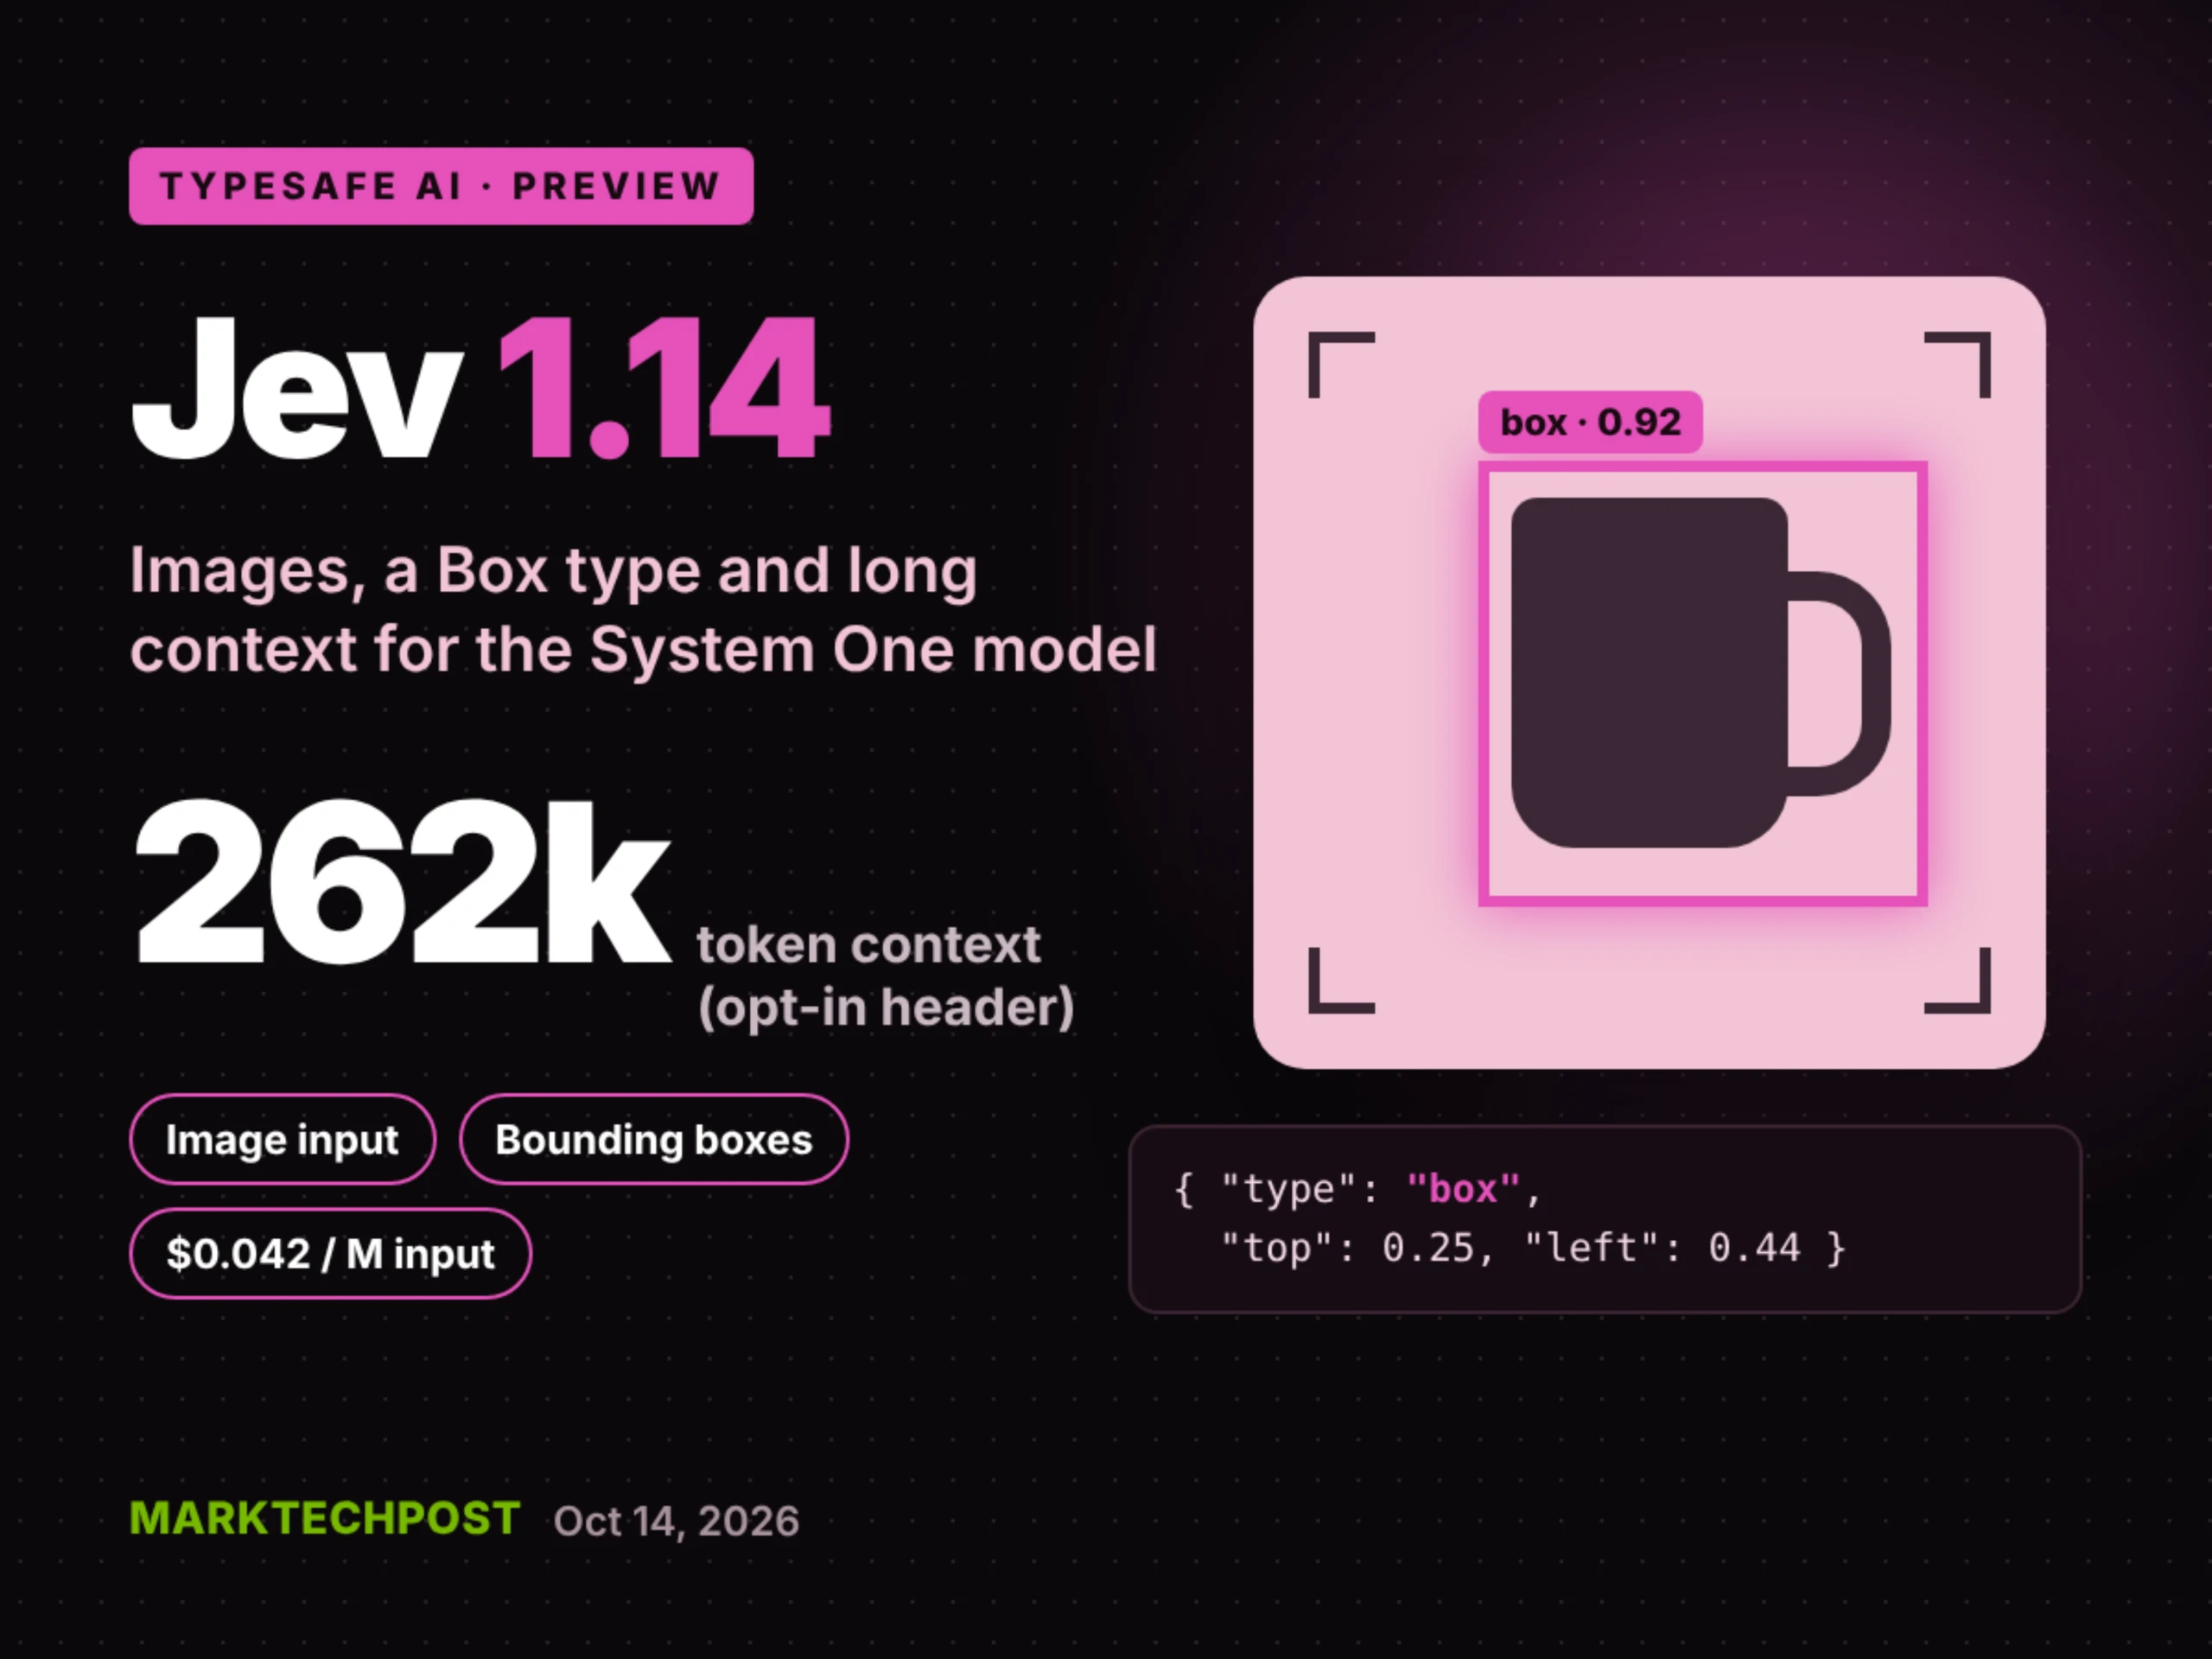
TypeSafe AI releases Jev 1.14 with images, Box type and 262k context: все три функции пока не для продакшена
TypeSafe AI выпустила Jev 1.14, обновление своей модели принятия решений System One, которое впервые добавляет работу с изображениями, новый тип ответа Box и…
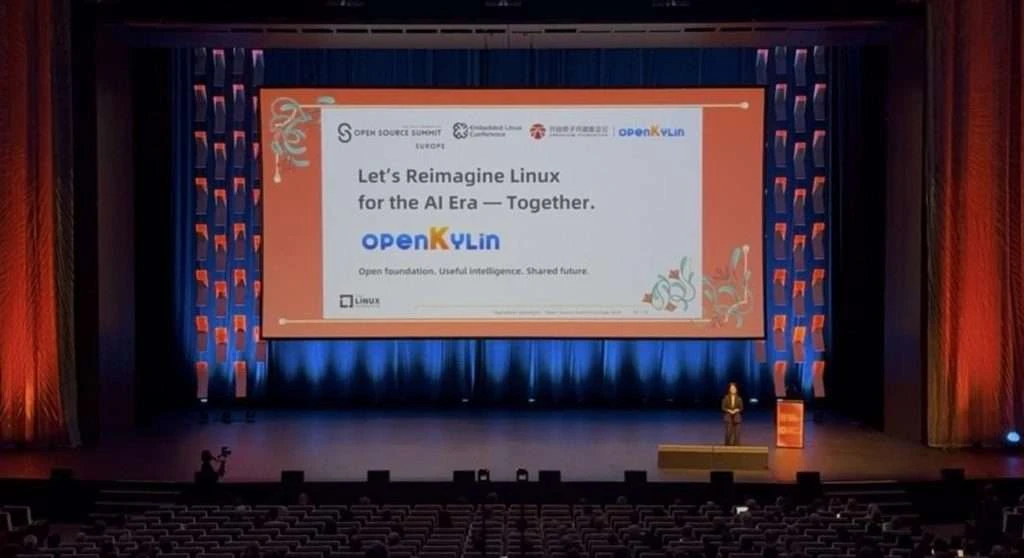
openKylin представила видение переосмысления Linux в эпоху ИИ на Open Source Summit Europe 2026
Почему это важно Впервые крупное опенсорс-сообщество предложило трёхуровневую архитектуру, которая встраивает ИИ прямо в ядро операционной системы, а не…
Что такое ИИ-агент без объективной метрики: 700 млрд токенов чуть не ушли в мусор
Мы с сообществом три месяца управляли автономными ИИ-агентами, которые декомпилировали популярный шутер от первого лица, и потратили на это от 600 до 700…
Комментарии