
Google DeepMind учит нейросети на лету: EvoLib обходится без разметки и машинного обучения в классическом виде
Архетектура новости для H1 «Эволюционное обучение нейросетей и машинное обучение» — строю по плану.
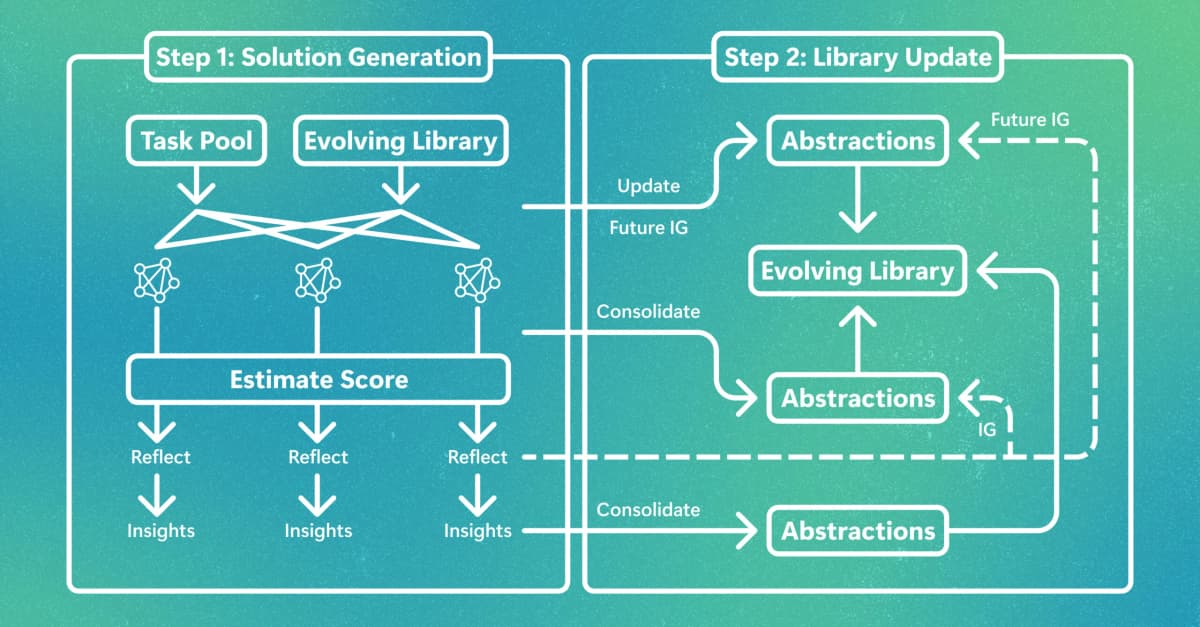
Google DeepMind представила EvoLib, фреймворк, который позволяет языковым моделям учиться на собственном опыте прямо во время работы, без дообучения (обучения модели на новых примерах) и без внешней разметки данных.
EvoLib не требует обновления весов модели и работает с любыми закрытыми моделями через API, а значит, авторы и предприниматели из РФ и СНГ могут применять самообучение даже к тем нейросетям, к «начинке» которых у них нет доступа.
Фреймворк описан в свежей научной статье «Test-Time Learning with an Evolving Library» от команды Google DeepMind. Авторы предлагают альтернативу классической памяти ИИ-агентов (программ, которые действуют самостоятельно): вместо хранения сырых логов и диалогов EvoLib превращает накопленный опыт в библиотеку переиспользуемых навыков и выводов, которая постоянно уточняется.
Для тех, кто изучает машинное обучение, это заметный сдвиг: модель улучшает результаты без классического цикла «собрать данные, разметить, переобучить».
| Что | Когда | Кто выпустил | Цена |
|---|---|---|---|
| EvoLib, фреймворк обучения на опыте во время инференса (работы модели с запросами) | Дата публикации в статье не указана, препринт доступен сейчас | Google DeepMind | Не раскрыта, фреймворк описан в открытой научной статье |
Что умеет EvoLib и чем отличается от обычной памяти?
- Самообучение без разметки. Модели не нужны заранее подготовленные правильные ответы или внешняя обратная связь. EvoLib извлекает уроки из собственных попыток: удачные решения превращаются в навыки, ошибки становятся предостережениями.
- Консолидация знаний. Когда появляется новый навык, фреймворк ищет похожие записи в библиотеке и объединяет их в более общую, переиспользуемую единицу. По аналогии: вместо десяти записок «как решить уравнение такого-то вида» остаётся одна стратегия, применимая ко всему классу задач.
- Взвешивание по долгосрочной пользе. Каждая единица знаний получает вес, который растёт не только за сиюминутную полезность, а за вклад в качество будущих задач. Знание, которое помогает чаще, «всплывает» выше.
- Перенос между задачами. Навыки, выработанные на математических задачах, могут помочь при написании кода, и наоборот. Библиотека становится универсальнее с каждым новым заданием.
- Работа с закрытыми моделями. EvoLib не требует доступа к весам, то есть подходит к любым API-моделям (закрытым моделям, доступным только через программный интерфейс). Для пользователей в РФ и СНГ это критично: дообучение закрытой модели через API невозможно, а EvoLib обходит это ограничение.
Какие результаты показали тесты?
Команда DeepMind проверила EvoLib на трёх типах задач:
- математические рассуждения,
- генерация кода с ограничениями по эффективности,
- долгосрочное принятие решений в интерактивной среде.
Во всех трёх сценариях EvoLib превзошла лучшие подходы на основе извлечения из памяти и другие абстрактные механизмы памяти, при этом использовала токены (единицы текста, которыми модель оперирует) экономнее.
Отдельный эксперимент показал устойчивость к порядку задач. В реальной работе ИИ-агент получает запросы вперемешку: сначала текст, потом код, потом анализ данных. EvoLib сохраняла стабильный прирост качества независимо от последовательности, что говорит о практической применимости вне лабораторных условий.
Как попробовать?
- Найдите статью «Test-Time Learning with an Evolving Library» на сайте Google DeepMind или в научных репозиториях. О публичном коде или API на момент публикации статьи не сообщалось.
- Если вы работаете с API-моделями (GPT, Claude, GigaChat), изучите описанную архитектуру: консолидация, взвешивание, извлечение навыков. Принципы можно реализовать самостоятельно поверх любого чат-API, даже до выхода официального кода.
- Для понимания основ машинного обучения, на которых построен подход, полезен учебник «Глубокое обучение» С. Николенко и соавторов (в сети часто ищут как «машинное обучение основы Николенко PDF»). Он даёт базу для понимания, почему обучение без обновления весов модели является нетривиальной задачей.
Сравнение с тем, что доступно в России
| Параметр | EvoLib (Google DeepMind) | YandexGPT / GigaChat |
|---|---|---|
| Самообучение на опыте без дообучения | Да, ключевая функция | Нет публичных аналогов этого механизма |
| Работа через API без доступа к весам | Да | Обе модели доступны через API, но без встроенного аналога EvoLib |
| Память между сессиями | Эволюционирующая библиотека навыков | Ограниченная контекстная память, без переноса между задачами |
| Доступность в РФ | Сам фреймворк описан в статье, но запуска продукта пока нет | Полностью доступны |
Ни YandexGPT, ни GigaChat пока не предлагают механизма, аналогичного EvoLib. Но принцип «извлекать навыки из прошлых сессий и переиспользовать» можно имитировать вручную: сохранять удачные промпты (текстовые инструкции для модели), группировать их по задачам и подавать как контекст в новых сессиях.
Что делать с этим прямо сейчас, по ролям
Автору Дзена. Если вы используете нейросеть для генерации текстов, заведите файл «что сработало»: удачные промпты, форматы, формулировки. Подавайте лучшие примеры в контекст следующего запроса. Это ручной аналог того, что EvoLib делает автоматически.
Маркетологу. Следите за появлением открытого кода EvoLib. Когда он станет доступен, агентные системы на API смогут дообучаться на истории ваших рекламных кампаний без отправки данных на серверы модели.
Предпринимателю в РФ и СНГ. EvoLib работает поверх любого API, включая локальные развёртывания открытых моделей. Это значит, что при ограниченном доступе к западным сервисам можно построить самообучающуюся систему на опенсорс-модели (модели с открытым кодом), развёрнутой на своём сервере.
На мой взгляд, EvoLib решает правильную проблему. Память ИИ-агентов сегодня напоминает захламлённый рабочий стол: всё сохранено, но ничего не найти в нужный момент. Подход DeepMind превращает этот хаос в структурированную библиотеку, которая ещё и обновляется сама.
Оговорка: пока это научная статья, а не готовый продукт. Публичного кода и документации для разработчиков на момент публикации нет. Между статьёй и рабочим инструментом может пройти месяцы.
Что сделать сегодня: прочитайте статью (даже по диагонали, раздел «How EvoLib Works»), попробуйте вручную применить принцип консолидации к своим промптам, объедините три похожих удачных инструкции в одну универсальную и проверьте, улучшится ли результат.
Частые вопросы
Нужно ли разбираться в программировании, чтобы использовать EvoLib?
Для полноценного внедрения понадобятся базовые навыки работы с API. Но сам принцип, извлекать из опыта переиспользуемые навыки и обновлять их, можно применять вручную в любом чат-интерфейсе, просто сохраняя и группируя удачные промпты.
Заменяет ли EvoLib дообучение?
Не заменяет, а дополняет. Дообучение меняет саму модель под конкретную задачу. EvoLib оставляет модель нетронутой и работает «снаружи», обогащая контекст накопленными знаниями. Для задач, где дообучение невозможно (закрытые API-модели), EvoLib становится единственным способом систематически улучшать результат.
Где почитать основы машинного обучения, чтобы понять контекст?
Хорошая отправная точка для русскоязычного читателя: учебник Николенко, Кадурина и Архангельской «Глубокое обучение» (часто ищут как «машинное обучение основы Николенко PDF»). Книга объясняет, как модели обучаются, что такое веса и почему обновление весов стоит дорого, а именно эту проблему EvoLib обходит.
Подход Google DeepMind ставит конкретный вопрос перед всей индустрией: зачем хранить тысячи логов, если можно хранить десяток отточенных навыков, которые растут вместе с агентом.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Редактор aiedit прячет код от ИИ-агента построчно: файлы-исключения Cline не защищали
Автор открытого редактора кода aiedit научил его прятать от ИИ-модели отдельные строки проекта на фоне отказа Cline от файлов-исключений, которые, по признанию…
Экс-директор Meta AI Пател бросил вызов Microsoft Office и Google Workspace втроём
Рохит Пател, бывший директор Meta Superintelligence Labs, после восьми лет в Meta запустил стартап Ndoc, единое рабочее пространство на ИИ вместо Microsoft…
Хакеры требуют от японской GMO $50 млн: утечка данных задела рабочие столы трейдеров
Японская GMO Internet расследует утечку данных из облачных рабочих столов Onamae для биржевых трейдеров. Это случилось через неделю после того, как её же…
Комментарии