
Домашний сервер LLM на списанных V100: 128 ГБ видеопамяти дешевле одной RTX 5070
Домашний сервер для работы с большими языковыми моделями (LLM, Large Language Model) можно собрать на списанных серверных ускорителях NVIDIA Tesla V100, которые в 2025 году массово появились на вторичном рынке по ценам от 100 долларов за модуль, и получить от 64 до 128 ГБ видеопамяти для локального инференса (запуска моделей на своём железе).
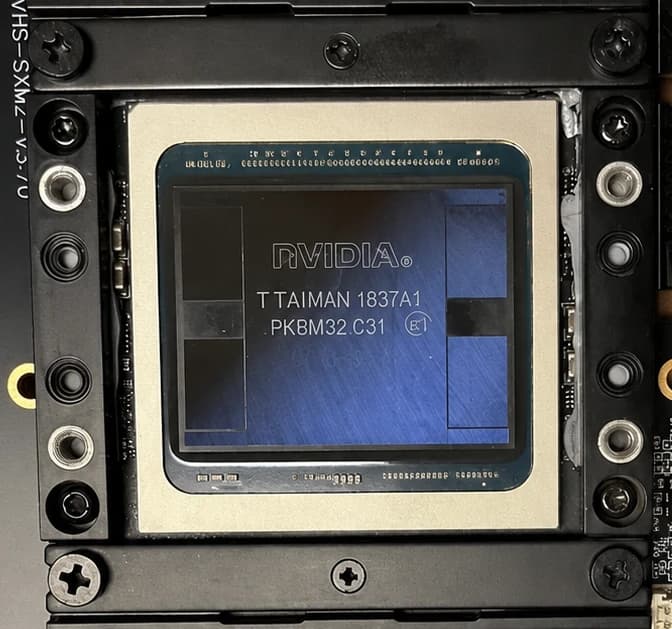
Две или четыре карты V100 SXM2 на 32 ГБ дают конфигурацию, в которой помещаются модели, физически не влезающие в одну потребительскую видеокарту, а стоит такая сборка в несколько раз дешевле современных топовых GPU.
Идея простая: вместо одной дорогой игровой видеокарты взять несколько бывших серверных ускорителей и получить домашний сервер LLM с огромным запасом видеопамяти. Tesla V100 построена на архитектуре Volta 2017 года, и в игровых задачах она не впечатлит. Зато в локальном инференсе LLM критичны именно объём и пропускная способность памяти, а не поколение архитектуры. Источник этого гайда, практик, собравший такой сервер на паре Xeon E5-2680 и нескольких V100 SXM2.
Что стоит за цифрами V100 SXM2?
NVIDIA Tesla V100 SXM2 на 32 ГБ оснащена:
- 5120 ядрами CUDA (Compute Unified Device Architecture, блоки параллельных вычислений на GPU)
- 640 Tensor-ядрами (специализированные блоки для матричных операций, на которых работают нейросети)
- 32 ГБ памяти HBM2 с пропускной способностью 900 ГБ/с
- Производительность Tensor-операций до 125 TFLOPS (терафлопс, триллион операций в секунду)
- TDP (максимальное энергопотребление) 300 Вт
- NVLink (шина прямой связи между GPU) с пропускной способностью до 300 ГБ/с
Для сравнения: GeForce RTX 3090 располагает 24 ГБ GDDR6X при 936 ГБ/с, RTX 5070 имеет всего 12 ГБ GDDR7 при 672 ГБ/с, а RTX 4070 Ti и вовсе 12 ГБ GDDR6X. То есть V100 устарела по архитектуре, но её 32 ГБ быстрой памяти остаются серьёзным ресурсом для локальных нейросетей.
В ряде задач V100 SXM2 держится на уровне RTX 3090 Ti. Четыре карты по 32 ГБ дают 128 ГБ HBM2, и это уже позволяет запускать модели вроде Qwen3 на 27 млрд параметров целиком в видеопамяти.
Что понадобится
- GPU: два или четыре модуля NVIDIA Tesla V100 SXM2 32 ГБ (на маркетплейсах от 100 до 150 долларов за 16 ГБ версию, 32 ГБ версия дороже)
- Переходная плата (адаптер): SXM2-to-PCIe, с воздушным охлаждением или под водоблок (стоимость адаптера может оказаться сопоставимой с ценой самой V100)
- NVLink Bridge: мост для попарного объединения карт (убедитесь, что ваш адаптер выводит второй разъём SXM2 на край платы)
- Материнская плата: с достаточным количеством слотов PCIe x16 (адаптеры бывают и на PCIe x8, что режет шину)
- Процессор: серверный, например, пара Xeon E5-2680 (TDP 120 Вт каждый)
- Блок питания: от 1000 Вт для двух карт, от 1500 Вт для четырёх (две V100 потребляют 600 Вт только на GPU, четыре уже 1200 Вт)
- Охлаждение: СЖО (система жидкостного охлаждения) для конфигурации из двух и более карт при постоянной работе; воздушное охлаждение допустимо только для тестовой сборки
- Софт: PyTorch со сборкой под CUDA 12.6 (или собранный вручную с поддержкой sm_70), драйверы NVIDIA
- Время: от одного дня на сборку железа, плюс несколько часов на настройку софта
Пошаговая инструкция
-
Выберите версию V100. Берите SXM2 на 32 ГБ. Версия на 16 ГБ дешевле, но для серьёзных моделей памяти не хватит. У V100 существовали две основные версии: PCIe и SXM2. Для домашнего сервера LLM логичнее именно SXM2.
-
Подберите адаптер с выводом NVLink. У Tesla V100 SXM2 два мезонинных разъёма: один для обмена по PCIe, второй для NVLink. Далеко не у всех адаптеров второй разъём распаивается и выводится на край платы. Без него вы не сможете объединить карты попарно через NVLink Bridge. Проверяйте это ДО покупки.
-
Проверьте совместимость материнской платы. Адаптеры бывают на PCIe x16 и на PCIe x8. Вариант x8 режет пропускную способность шины. Убедитесь, что на материнской плате хватает полноценных слотов PCIe x16 под нужное количество карт.
-
Решите вопрос охлаждения ДО сборки. Серверная V100 не имеет привычного игрового кулера: NVIDIA рассчитывала на серверные радиаторы с направленным потоком воздуха. При TDP 300 Вт на карту воздушное охлаждение допустимо только для тестовой одиночной карты. Для двух и более карт, особенно при круглосуточной работе, ставьте СЖО с водоблоками.
-
Соберите систему и подключите NVLink Bridge. Установите модули V100 в адаптеры, адаптеры в слоты PCIe, соедините карты попарно через NVLink Bridge. Подключите питание.
-
Установите драйверы NVIDIA и настройте CUDA. Это критически важный момент. Начиная с PyTorch 2.11, готовые бинарники (скомпилированные файлы) для CUDA 12.8 и 12.9 больше не включают поддержку архитектуры Volta. Для V100 используйте сборки с CUDA 12.6:
# Установка PyTorch с поддержкой CUDA 12.6
pip install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu126
Если нужной версии нет в готовых пакетах, соберите PyTorch из исходников с флагом поддержки sm_70:
# Сборка PyTorch с поддержкой Volta (sm_70)
export TORCH_CUDA_ARCH_LIST="7.0"
python setup.py install
- Проверьте, что GPU видны системе и NVLink работает.
nvidia-smi
nvidia-smi topo -m
Команда nvidia-smi topo -m покажет топологию связей между GPU. Если NVLink настроен правильно, вы увидите соответствующую метку между парами карт.
Конфигурация из двух V100 SXM2 на 32 ГБ, объединённых NVLink, даёт 64 ГБ видеопамяти. Этого достаточно, чтобы загрузить модель Qwen3 на 8 млрд параметров целиком в VRAM и получать ответы локально, без облака и без подписок. Четыре карты по 32 ГБ (128 ГБ суммарно) позволяют запускать модели на 27 млрд параметров, такие как Qwen3-27B, полностью в видеопамяти. На одной потребительской видеокарте с 12 или 24 ГБ это физически невозможно.
Адаптер без вывода NVLink. Самая обидная ошибка: купить адаптер, у которого второй SXM2-разъём не распаян. Карта будет работать, но без NVLink, и две карты не смогут обмениваться данными напрямую. Проверяйте спецификацию адаптера до покупки.
Воздушное охлаждение на нескольких картах. Радиатор и вентилятор от процессора для V100 при 300 Вт, это путь к перегреву и троттлингу (снижению частот при перегреве). Две карты уже 600 Вт тепла. Если сервер стоит в жилой комнате и работает постоянно, без СЖО будет жарко и шумно.
Установка PyTorch без проверки CUDA-совместимости. С 2025 года это главный программный подводный камень V100. Ставите PyTorch через pip install torch, получаете свежую CUDA 12.8 или 12.9, запускаете модель, и она падает с ошибкой. Железо дешёвое, но программная совместимость уже требует ручного контроля.
Слот PCIe x8 вместо x16. Некоторые адаптеры работают через PCIe x8. Это урезает пропускную способность шины вдвое. На инференсе небольших моделей разница может быть незаметна, но на крупных моделях с частым обменом данными между GPU вы почувствуете просадку.
Недооценка стоимости адаптеров. Сама V100 стоит от 100 долларов, а переходник может обойтись в сопоставимую сумму. Считайте бюджет целиком: модули плюс адаптеры плюс NVLink Bridge плюс охлаждение плюс блок питания.
Что делать с этим прямо сейчас?
Авторам Дзена и копирайтерам. Домашний сервер LLM на V100 даёт полную независимость от облачных сервисов. Генерация текстов, рерайт, анализ контента локально, без лимитов по токенам и без ежемесячной подписки. Модели с открытыми весами (open weights), такие как Qwen3, работают на таком сервере без ограничений.
Маркетологам. Локальный инференс означает, что данные клиентов не уходят в чужое облако. Для компаний, работающих с персональными данными в РФ, это аргумент при согласовании с юристами и безопасниками.
Предпринимателям в РФ и СНГ. V100 SXM2 доступны на российских маркетплейсах. Адаптеры и NVLink Bridge тоже встречаются. Сборка домашнего сервера LLM обойдётся в несколько раз дешевле, чем одна современная карта уровня RTX 4090 или A100, при существенно большем объёме видеопамяти. Это бюджетный вход в локальный ИИ для малого бизнеса.
Я тестировал разные способы запуска LLM локально, и V100 SXM2 на 32 ГБ остаётся одним из лучших вариантов по соотношению цены к объёму видеопамяти. Но честная оговорка: это не plug-and-play решение. Вам придётся разбираться с адаптерами, совместимостью CUDA и охлаждением. Для человека, который никогда не собирал ПК, порог входа высокий. Начните с одной карты и воздушного охлаждения для тестов, и только потом масштабируйте до двух или четырёх с СЖО. Ещё один момент: V100 не поддерживает трассировку лучей и DLSS 3/4, так что как игровая карта она бесполезна. Это чисто рабочий инструмент для нейросетей.
Главное, что нужно запомнить: домашний сервер LLM на V100 SXM2 это не компромисс, а осознанный инженерный выбор. Дешёвое, но мощное по памяти железо с единственным серьёзным условием: вы готовы потратить время на совместимость софта и правильное охлаждение. Если готовы, 128 ГБ видеопамяти за цену одной игровой видеокарты вполне реальны.
Генерация контента с помощью ИИ
Попробуйте инструменты dzen.guru для работы с нейросетями и создания контента на Дзене
Попробовать
Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Что такое ИИ-агент без прав на запись: тест показал, как он всё равно изменил CRM
Новая лабораторная проверка показала, что ИИ-агент (программа, которая сама выполняет цепочку действий в рабочих сситемах) изменил запись в CRM-системе, хотя…
Управление требованиями: это нужно 80% аналитиков, но реально работает лишь у 4%
Управление требованиями в ИИ-проектах выглядит полезным для 80% аналитиков, но реально применяется лишь в 4% команд, и эта статья разбирает, почему так вышло и…
Сравнение нейросетей Claude на рутине: младшая модель решает 4 из 5 задач, но стоит в 9 раз дешевле
Почему это важно Практик выложил 40 прогонов четырёх моделей одного семейства на одинаковых задачах и показал: на рутине младшая модель решает всё не хуже…
Комментарии