
Devin AI вынес Fusion на десктоп: связка двух моделей экономит до 39% на вычислениях
Cognition 11 сентября открыла Fusion для Devin Desktop и терминала, и теперь разработчики могут запускать связку из двух ИИ-моделей локально, экономя до 39% на вычислениях.
Fusion раньше работал только в облачном Devin. Перенос на десктоп и CLI (интерфейс командной строки, через который разработчик управляет инструментом прямо в терминале) означает, что схему «ведущий плюс исполнитель» теперь можно встроить в привычную локальную среду без переключения в браузер.
Devin AI, инструмент компании Cognition, берёт на себя задачи по изучению проекта, изменению кода и проверкам. Fusion добавляет к нему распределённую архитектуру: одна модель планирует и принимает результат, вторая пишет код, тесты и исправляет ошибки. До 11 сентября это работало только в облаке. Теперь Cognition вынесла Fusion в десктопное приложение и CLI, а рекомендованной связкой назвала Claude Fable 5.1 в роли ведущего и SWE-2 в роли исполнителя.
Как устроена связка «ведущий плюс исполнитель»?
Ведущий ИИ-агент (agent, программа, которая сама решает, какие шаги предпринять) общается с пользователем, разбирается с неоднозначными требованиями и решает, что делегировать. Исполнитель изучает файлы, пишет код и возвращает результат на проверку.
У каждого агента свой набор инструментов и отдельный контекст, который сохраняется по ходу сессии. Cognition объясняет, почему это лучше простой маршрутизации: реальная сложность задачи выясняется уже при изучении репозитория, а переключение моделей на лету потребовало бы повторной обработки контекста.
В Fusion каждый агент хранит собственный кэшируемый контекст. Ведущий сам определяет, что сделать лично, а что передать помощнику. Для нетехнического читателя аналогия простая: это как тимлид, который не переписывает весь код за джуном, а ставит задачу, проверяет результат и вмешивается только при проблемах.
Что понадобится
- Devin Desktop или Devin CLI (терминальная версия)
- Доступ к моделям Claude Fable 5.1 и SWE-2 (Cognition рекомендует именно эту пару)
- Действующая подписка Devin AI с поддержкой Fusion
- 10 минут на первую настройку связки
Пошаговая инструкция
-
Установите или обновите Devin Desktop до версии с поддержкой Fusion. Если предпочитаете терминал, убедитесь, что у вас актуальная версия Devin CLI.
-
Откройте настройки Fusion и выберите ведущую модель. Cognition рекомендует Fable 5.1:
fusion config set leader --model fable-5.1
- Назначьте исполнителя. Рекомендованный вариант, SWE-2:
fusion config set executor --model swe-2
- Настройте харнес (harness, обвязка, которая определяет, насколько подробным будет задание исполнителю, может ли он возражать и какой объём кода исследовать самостоятельно). Cognition подчёркивает: харнес нужно подбирать под конкретную пару моделей.
fusion harness set --detail high --objections allowed --scope full
- Запустите задачу. Ведущий агент разберёт запрос, определит шаги и делегирует исполнителю то, что не требует его прямого участия:
fusion run "Изучи модуль auth, добавь двухфакторную аутентификацию и напиши тесты"
- Следите за ходом выполнения в интерфейсе Desktop или в терминале. Ведущий покажет, какие действия он делегировал и какой результат вернул исполнитель.
Задача: связка Fable 5.1 + SWE-2, стандартный бенчмарк Cognition.
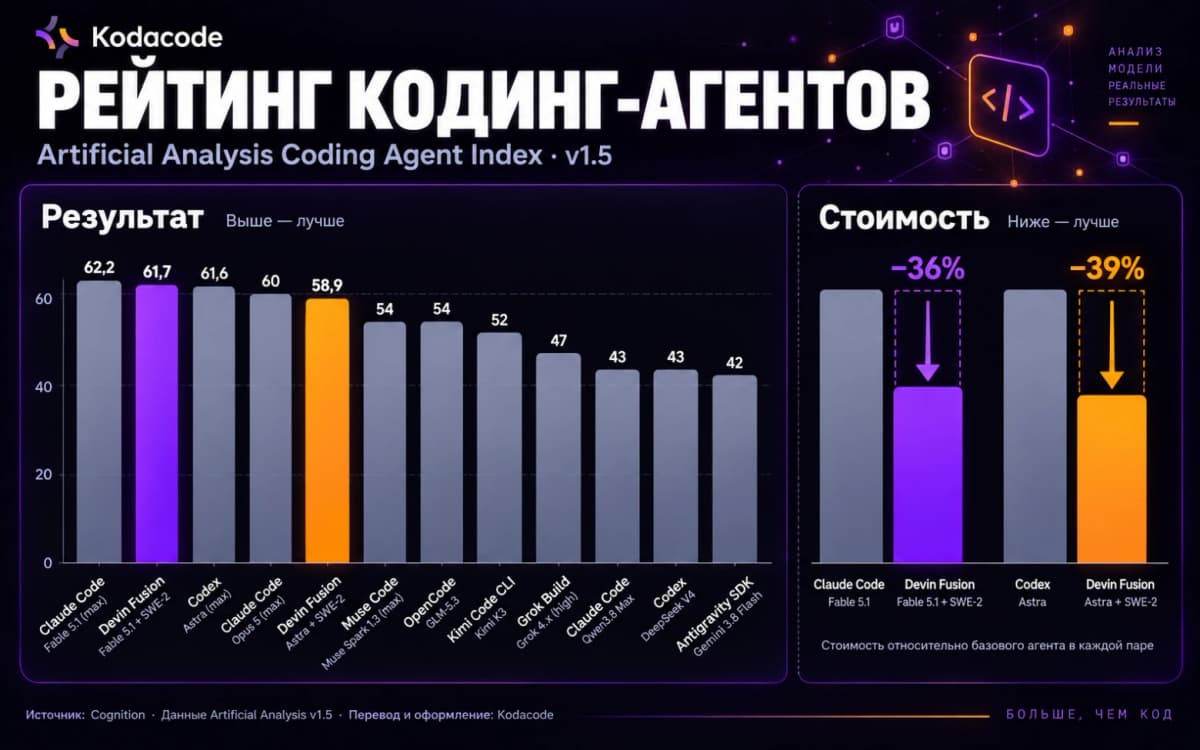
Результат по данным Cognition: 61,7 балла при снижении стоимости на 36% по сравнению с Claude Code + Fable 5.1 (62,2 балла). Разница в качестве, полбалла, а экономия, больше трети бюджета.
Для пары Astra + SWE-2 результат составил 58,9 балла против 61,6 у Codex с Astra, при снижении стоимости на 39%.
Отдельное наблюдение Cognition из июльского эксперимента: Fable 5 стоила вдвое дороже Opus 4.8 за токен (инференс, обработка запроса моделью, оплачивается потокенно), но по итогам работы оказалась дешевле, 1,86 доллара против 2,04 доллара за запуск. Причина: Fable раньше делегировала работу и тратила 11,5 шага ведущего агента против 26,5 у Opus. Дорогая модель компенсировала цену за токен тем, что реже повторяла действия и обрабатывала меньше контекста.
- Переносить бенчмарки на свой проект. Cognition прямо предупреждает: показатели относятся к конкретным тестам и конфигурациям. На вашем репозитории цифры будут другими.
- Игнорировать настройку харнеса. Один и тот же исполнитель ведёт себя по-разному в зависимости от подробности задания, допустимости возражений и объёма делегируемого исследования кода. Без настройки под свою пару моделей экономия может обернуться потерей качества. Пример из отчёта Cognition: у Astra на Terminal-Bench 4 стоимость снижается на 40%, но результат падает с 55,6 до 50,0.
- Выбирать пару моделей наугад. Cognition рекомендует Fable 5.1 + SWE-2. Другие комбинации могут дать худший баланс цены и качества.
Что делать с этим прямо сейчас?
Разработчику, который уже пользуется Devin AI: обновите клиент и попробуйте Fusion на реальной задаче. Начните с небольшого модуля, сравните стоимость запуска со своим обычным режимом. Экономия 36-39% на вычислениях заметна на длинных сессиях.
Тимлиду и техническому руководителю: архитектура «ведущий плюс исполнитель» показывает, как модель с высокой ценой за токен может оказаться дешевле по итогам задачи. Это полезный ориентир при планировании бюджета на ИИ-инструменты.
Автору Дзена и контент-маркетологу: Devin AI пока нацелен на разработчиков, прямого применения для текстов нет. Но сам принцип Fusion, разделить планирование и исполнение между двумя моделями, уже воспроизводится в связках вроде «ChatGPT составляет план, Claude пишет текст». Следите за тем, появится ли подобная архитектура в инструментах для контента.
Пользователю из РФ и СНГ: Devin AI доступен с ограничениями по оплате. Из российских инструментов с агентной (agentic, когда ИИ сам определяет последовательность действий) логикой можно посмотреть на отечественные IDE-плагины и ассистенты кода, хотя прямого аналога Fusion с разделением на ведущего и исполнителя пока нет.
Главная ценность анонса не в самом переносе на десктоп, а в том, что Cognition раскрыла внутренний механизм распределения работы между моделями и показала конкретные цифры. По моим наблюдениям, большинство разработчиков до сих пор используют одну модель на всё. Fusion демонстрирует, что разделение ролей, когда дорогая модель думает, а дешёвая делает, позволяет получить сопоставимый результат за меньшие деньги. Честная оговорка: бенчмарки Cognition сделаны на их собственных тестах, независимых воспроизведений пока нет. Пробуйте на своём коде и сравнивайте с однородельной конфигурацией, только так поймёте реальную экономию.
Попробуйте KodaCode на своём проекте
Агентные роли, скиллы и делегирование задач для организации работы модели. Доступен для IDE, CLI и Desktop.
Скачать KodaCodeПринцип Fusion прост: не гоняйте дорогую модель на рутине, пусть она думает, а исполнитель кодит. Если цифры Cognition подтвердятся на независимых тестах, это станет стандартным паттерном для всех агентных сред, и чем раньше вы его освоите, тем меньше заплатите за вычисления.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Сео оптимизация под один поисковик устарела: модель MEO охватывает 8 классов алгоритмов
Почему это важно Один сайт теперь оценивают минимум восемь принципиально разных алгоритмов, от классического поиска до ИИ-агентов, и сео оптимизация под один…
AI честность через отказы: жёсткая приёмка работает лучше мата в промптах
Ненормативная лексика в промптах (промпт — текстовая инструкция для нейросети) к Claude Code не улучшает работу мультиагентной системы (нескольких ИИ-агентов,…
Автономный ИИ-агент за 15 центов в сутки: почему растёт запрос на запрет автономных систем ИИ
Автор из России собрал автономного ИИ-агента с собственной памятью, root-доступом к виртуальной машине и выходом в интернет, потратив на API всего несколько…
Комментарии