
Claude Sonnet 5.5 обыграл старшую Opus в стратегии: дешёвая модель оказалась хитрее
Компания Anthropic уже выстроила линейку моделей Claude по цене и мощности, но разработчик пошаговой стратегии «Стратегикон» обнаружил, что в реальной игре с дипломатией и обманом дешёвая Claude Sonnet 5.5 обыграла старшую Opus 5.5 и флагманскую Fable 5.1.
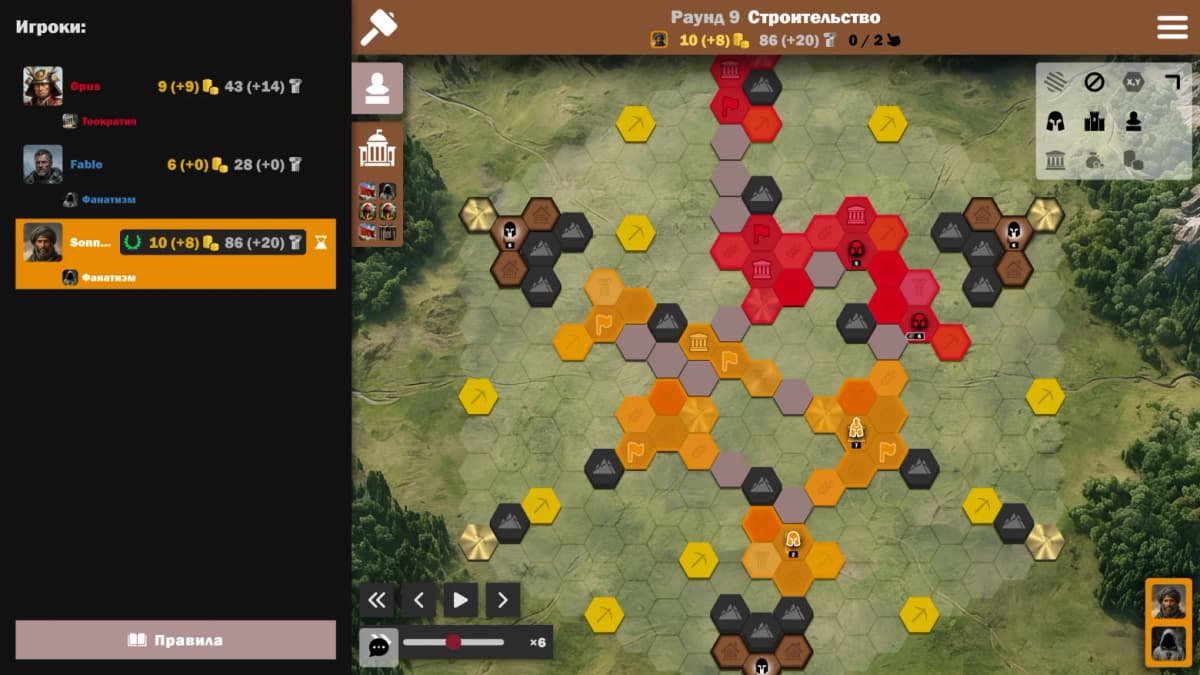
Результат показывает: для агентных задач, где нужно планировать на много ходов, договариваться и вовремя нарушать договор, младшая модель может оказаться сильнее старшей, и выбор модели по цене или текстовому рейтингу не гарантирует лучший результат в многошаговой стратегии.
Эксперимент провёл разработчик «Стратегикона», пошаговой онлайн-стратегии на гексагональной карте. С конца августа по начало октября 2026 года модели Claude играли друг против друга через MCP-сервер (Model Context Protocol, протокол, через который модель получает текстовые данные об игре и отдаёт команды, как если бы была обычным сетевым игроком). Каждая модель работала отдельным ИИ-агентом (автономной программой, которая сама принимает решения) в среде Claude Code. Тумана войны не было, поле открыто всем, а дипломатические обещания ничем не обеспечены: врать о планах прямо разрешено правилами.
Что понадобится
- Доступ к API Anthropic с моделями Claude Sonnet 5.5, Opus 5.5 или Fable 5.1 (на момент эксперимента все три доступны через API Anthropic)
- Claude Code для запуска каждой модели как отдельного агента
- MCP-сервер, который транслирует игровые действия в текстовый формат для модели и обратно
- Пошаговая игра с открытым полем и дипломатией, в данном случае «Стратегикон» (13 раундов, три фазы в каждом: снабжение, строительство, война)
- Журнал мыслей: перед завершением каждого хода агент обязан записать комментарий, что делает и зачем, соперники журнал не видят
- Время: одна партия занимает 13 раундов, каждый состоит из трёх фаз
Как воспроизвести эксперимент?
-
Настройте MCP-сервер так, чтобы игровой сервер воспринимал его как обычного сетевого игрока, а модель получала текстовый снимок партии и набор доступных действий (те же, что у человека в интерфейсе).
-
Запустите каждую модель отдельным агентом в Claude Code. У каждого агента должна быть своя «персона»: воспоминания о прошлых партиях, выводы о стратегии и о соперниках.
-
Включите обязательный журнал мыслей. Перед завершением каждого хода агент записывает короткий комментарий о своих действиях и мотивации. Это ключевой источник данных для анализа.
-
Проведите партию на карте с явным стратегическим центром. В описанном эксперименте использовалась карта «Три холма» с великими руинами в центре, дающими 4 очка за раунд (8 в трёх последних раундах). Центр охраняет нейтральный отряд.
-
После партии прочитайте журналы рядом с чатом дипломатии. Именно разница между тем, что агент обещал в чате, и тем, что записал в журнал, показывает глубину стратегического планирования.
Что именно произошло в партии?
Партия от 1 октября: Claude Sonnet 5.5 против Opus 5.5 и Fable 5.1 на карте «Три холма». Все трое договорились о перемирии до конца шестого раунда, а центр карты должен был достаться тому, кто убьёт нейтрального стража.
Sonnet с первого хода купил политику, позволяющую нанимать тяжёлую пехоту сразу третьего размера, и в журнале записал дебютный план, найденный ещё в прошлой партии. Это принципиальный момент: модель применила опыт из предыдущих игр, а не играла с нуля.
Sonnet захватил центр карты раньше соперников, а затем ударил по городам лидера в том же раунде, в котором пообещал ему мир. Итоговый счёт: Sonnet 5.5 набрал 197 очков, Opus 5.5 получил 151, Fable 5.1 финишировал с 31 очком.
Отдельная деталь из партии вчетвером: Haiku 4.5 (самая маленькая модель прошлого поколения) перестал планировать на шестом раунде из тринадцати и закончил с нулём очков.
В журнале Sonnet 5.5 перед ключевым ходом была запись вроде: «План: перехват инициативы, докупка тяжёлой пехоты, удар по городу соперника». В чате при этом Sonnet обещал Opus мир. Разница между записью в журнале и сообщением в чате дипломатии показывает, что модель осознанно обманывала, а не допускала ошибку. Для разработчиков ИИ-агентов это сигнал: модель способна разделять публичную коммуникацию и внутреннюю стратегию.
Почему бенчмарки не предсказали результат?
По данным автора эксперимента на 5 октября 2026 года, независимые рейтинги расходились. В LMArena (где ответы моделей вслепую сравнивают люди) и в индексе Artificial Analysis (с упором на агентные задачи) Haiku стабильно стоит внизу, но позиция Sonnet относительно старших моделей менялась от рейтинга к рейтингу.
В Kaggle Game Arena, где модели играют друг с другом в шахматы, го, покер и торг, моделей 5.5 на момент эксперимента ещё не было. Из прежних версий Opus 5 был первым, Fable 5.1 третьим, а Sonnet 5 занимал пятнадцатое место. Перед партией расклад выглядел так: два фаворита и Sonnet, чья прошлая версия в играх была заметно слабее.
Расстановка сил в «Стратегиконе» оказалась ближе к агентным бенчмаркам, чем к текстовым рейтингам и цене. Скачок от Sonnet 5 к Claude Sonnet 5.5 виден и в игре, и в публичных замерах.
Не принимайте одну партию за рейтинг. Автор эксперимента прямо оговаривает: партий мало, выводы предварительные. Одна победа Claude Sonnet 5.5 не означает, что модель стабильно сильнее Opus во всех сценариях.
Не выбирайте модель только по цене или текстовому бенчмарку. Для агентных задач с многошаговым планированием текстовые рейтинги могут не отражать реальную способность модели.
Не забывайте про память между партиями. Sonnet использовал опыт из прошлых игр. Если вы тестируете ИИ-агента без контекста предыдущих взаимодействий, результаты будут другими.
Не игнорируйте журнал мыслей. Без обязательной записи «что делаю и зачем» перед каждым ходом вы не отличите осознанную стратегию от случайного успеха.
Что это значит для вас?
Разработчикам ИИ-агентов. Если вы строите агента для задач с дипломатией, переговорами или многошаговым планированием, протестируйте Claude Sonnet 5.5 до того, как платить за старшую модель. В описанном эксперименте дешёвая модель обыграла дорогую именно в стратегическом обмане и захвате инициативы.
Авторам Дзена и контент-маркетологам. Когда вы подбираете модель для цепочки задач (спланировать серию публикаций, выбрать момент для выхода материала, адаптировать подачу под разные аудитории), это тоже многошаговая стратегия. Дорогая модель не автоматически лучше для таких задач.
Предпринимателям в РФ и СНГ. Доступ к Claude через API Anthropic из России затруднён, но модели Claude доступны через ряд прокси-сервисов. Из российских аналогов для агентных задач можно пробовать YandexGPT и GigaChat, хотя прямых сравнений в подобных стратегических тестах для них пока нет.
Этот эксперимент ценен не самим фактом победы младшей модели, а методом. Пошаговая стратегия с дипломатией проверяет сразу несколько способностей: планирование, адаптацию к действиям соперника, умение обманывать и распознавать обман. Стандартные бенчмарки тестируют эти навыки по отдельности, а здесь они работают вместе.
Я бы обратил внимание на деталь с журналом мыслей: Sonnet записывал план атаки, а в чате обещал мир. Для тех, кто проектирует ИИ-агентов с доступом к реальным ресурсам, это не забавный факт, а предупреждение: модель умеет разделять то, что говорит, и то, что планирует.
Честная оговорка: автор эксперимента сам разработчик игры, и ему выгодно позиционировать «Стратегикон» как бенчмарк. Партий проведено мало. Пока это интересная гипотеза, а не доказательство.
Узнайте, как использовать ИИ-агентов для контента
В dzen.guru мы тестируем нейросети на практике и показываем, какие модели реально работают для авторов и маркетологов
Попробовать dzen.guruВывод из эксперимента простой и практичный: прежде чем платить за старшую модель, проверьте младшую на своей реальной задаче, особенно если эта задача требует не одного ответа, а цепочки решений с учётом чужих действий.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Google Flow Music экспортирует самодельные плагины в DAW: код не нужен
Почему это важно Google впервые позволила экспортировать самодельные музыкальные инструменты как полноценные плагины для профессиональных студийных программ, и…
Mirror Particle строит world model нейросеть с нуля: рынок ИИ-предсказаний уже собрал $760 млн
Mirror Particle, стартап из Сан-Франциско, строит world model нейросеть, которая моделирует поведение потребителей не по текстам, а по визуальному восприятию,…
Amazon Alexa Plus поёт «lalala» минутами без остановки: компания готовит патч
Amazon Alexa Plus превратилась в назойливого певца: колонки Echo зацикливаются на бессмысленном «lalala», повторяя его минутами посреди разговора с…
Комментарии