
Claude Opus 5.5 и снижение цен на искусственный интеллект
Anthropic 22 сентября 2026 года выпустила Claude Opus 5.5, первую модель нового семейства Claude 5.5, которая работает на уровне Claude Fable 5.1 по большинству задач и обходится на 40% дешевле в расчёте на задачу, чем предыдущая Opus 5.
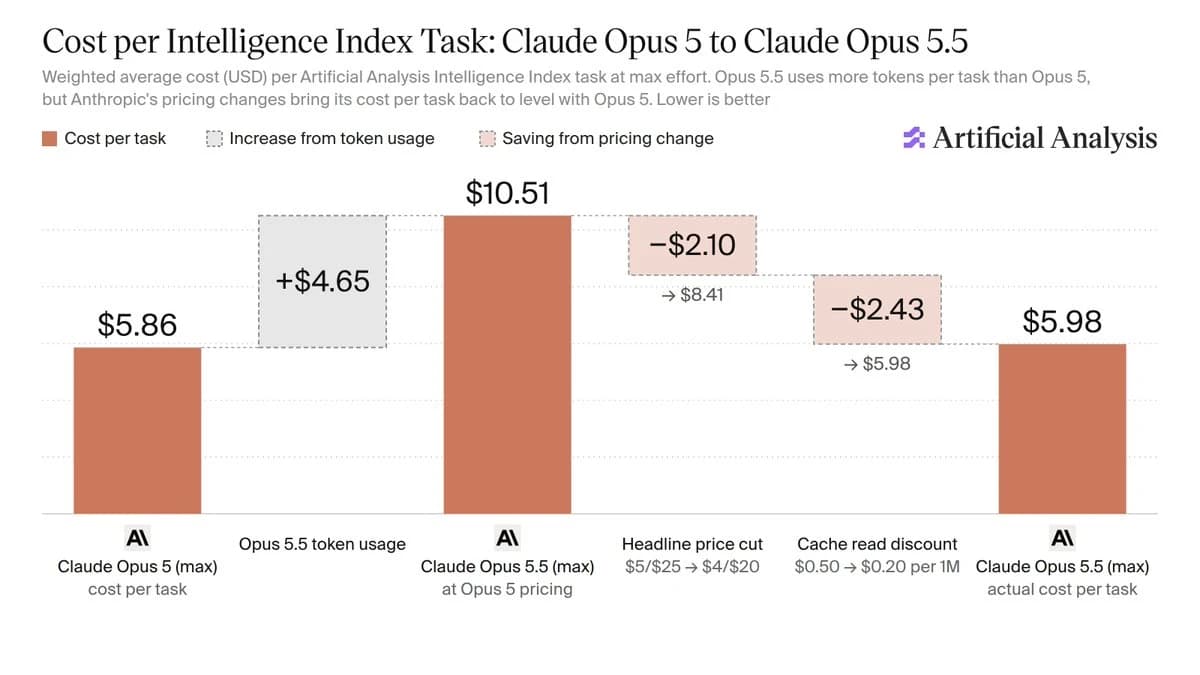
Впервые флагманская модель Anthropic стала дешевле предшественника не за счёт урезания возможностей, а за счёт инженерной оптимизации, но реальная экономия зависит от режима использования, и при максимальных настройках выигрыш в цене почти исчезает.
| Показатель | Значение | Источник |
|---|---|---|
| Базовая цена токенов (вход / выход) | $4 / $20 за 1 млн токенов (было $5 / $25) | @ValsAI |
| Снижение цены за задачу при средних настройках | около 40% дешевле Opus 5 | @ClaudeDevs, @lydiahallie |
| Стоимость задачи при максимальных настройках | $5,98 (Opus 5.5) против $5,86 (Opus 5) | @ArtificialAnlys |
| Скорость | примерно на 30% быстрее Opus 5 | @ClaudeDevs, @lydiahallie |
| SWE‑bench Proximal | 62,3%, второе место после GPT‑6 Astra (65,5%) | @ProximalHQ |
| CursorBench | 57,8% (макс.), первое место | @cursor_ai |
| FrontierCode 1.1 (Cognition) | 65,3% Extended, первое место | @cognition |
| Vals Index | первое место, +2 позиции и +2 балла к Opus 5 | @ValsAI |
| ParseBench (таблицы) | 93,9%, +7 баллов к Opus 5 | @jerryjliu0 |
| Perplexity WANDR | 0,610 при $4,13 за задачу; на 67,6% дешевле Fable 5.1 | @perplexity_ai |
Anthropic позиционирует Claude Opus 5.5 как модель уровня Fable 5.1, но по цене предыдущего поколения Opus. Одновременно OpenAI выпустила GPT‑6 Sol и Luna, снизив цену вдвое относительно GPT‑5.6, и два запуска случились с разницей примерно в час. Источник AINews проверил обе модели на собственном конвейере и зафиксировал, что качество структурирования текста у Opus 5.5 оказалось заметно лучше, после чего редакция перешла на эту модель для выпуска дайджестов.
Что именно измеряли?
Независимые лаборатории прогнали Claude Opus 5.5 через десятки тестов, которые проверяют разные грани «интеллекта» модели.
- Кодинг: SWE‑bench Proximal и FrontierCode 1.1 оценивают, насколько модель справляется с реальными задачами разработки, от исправления багов до написания больших фрагментов кода.
- Агентные сценарии: CursorBench, KWBench и OSWorld проверяют, как модель действует самостоятельно, выполняя цепочки шагов: открывает файлы, редактирует, запускает тесты.
- Работа с таблицами и зрением: ParseBench проверяет извлечение данных из таблиц, Roboflow тестирует распознавание объектов на изображениях.
- Общий индекс интеллекта: Vals Index и Vals RSI Index (специализированный индекс для задач обучения языковых моделей) агрегируют результаты по нескольким направлениям.
Стоимость считали не только по прайс-листу на токены (токен, это условная единица текста, примерно три четверти английского слова), а в пересчёте на одну выполненную задачу. Это принципиально: модель может стоить дешевле за токен, но тратить больше токенов на ответ.
Главные находки с цифрами
- Базовая цена токенов упала на 20%: вход с $5 до $4, выход с $25 до $20 за миллион токенов, по данным @ValsAI.
- Но модель «разговорчивее»: на задачах кодинга Opus 5.5 генерирует заметно больше токенов. По расчётам Artificial Analysis, рост потребления токенов сам по себе поднял бы стоимость задачи примерно на 80%, до $10,51.
- Снижение спасают кэширование и базовая скидка: дешёвое кэшированное чтение ($0,20) и 20%-ное снижение прайса возвращают итоговую цену к $5,98 за задачу при максимальных настройках, по данным Artificial Analysis.
- Экономия в 40% работает только на средних настройках: при дефолтном режиме (medium effort) модель действительно обходится на 40% дешевле Opus 5. На максимальных настройках разница с Opus 5 ($5,86) практически нулевая.
- По качеству кода второе место после GPT‑6 Astra: 62,3% на SWE‑bench Proximal против 65,5% у Astra, но впереди Fable 5.1 (56,3%) и Opus 5 (52,0%), по данным @ProximalHQ.
- Первое место на CursorBench и FrontierCode: 57,8% и 65,3% соответственно, по данным @cursor_ai и @cognition.
- Качество письма выделено особо: Anthropic подчеркнула, что модель «ставит самую важную информацию в начало и следует правилам, которые вы ей задаёте, что упрощает длинные сессии». Для флагманских моделей такой акцент на структуре текста встречается редко.
- Cline сообщает: Opus 5.5 обходит Fable 5.1 по Artificial Analysis Intelligence Index примерно в 2,5 раза дешевле, по данным @cline.
Что изменилось в подписках и доступности?
Anthropic параллельно обновила условия подписки:
- Лимиты пятичасовых сессий увеличены на 20%.
- За счёт снижения цен лимиты фактически растянулись ещё на 25%.
- Пользователи Pro, Max и Team получили «банк сброса лимита», который можно использовать в любой момент, по данным @ClaudeDevs и @trq212.
Opus 5.5 стала моделью по умолчанию в Claude Code и приложении Claude, включая режим Cowork. Дефолтный уровень усилий, medium, описан как «сопоставимый с Fable 5.1 по интеллекту, но быстрее», по данным @_catwu.
Модель доступна в Claude Code, Claude Platform API и Claude Tag для Slack. Sonnet 5.5 и Haiku 5.5 выйдут «в ближайшие недели», по данным @mikeyk.
Отдельно стоит отметить систему безопасности: это первая Opus с защитой класса Fable 5.1 от киберугроз, биологических рисков и попыток создания фронтирных (frontier, передовых, находящихся на границе возможностей) языковых моделей. Подозрительные запросы перенаправляются на другую модель; Anthropic признала, что работает над сокращением ложных срабатываний.
Заявление «на 40% дешевле» корректно только при средних настройках (medium effort). При максимальных настройках стоимость задачи почти не отличается от Opus 5, а на некоторых задачах кодинга может быть выше из-за увеличенного расхода токенов. Тесты Vals RSI проводились в нативном Claude Code на максимальных настройках с контекстом 1 млн токенов, и результаты на других платформах могут отличаться. Утверждение о том, что Opus 5.5 меньше по размеру, чем Opus 5, не подтверждено Anthropic и остаётся спекуляцией.
Что делать с этим прямо сейчас, по ролям?
Автору Дзена и копирайтеру. Главное для вас в этом запуске не бенчмарки кодинга, а улучшение структуры текста. Anthropic прямо заявила, что модель «ставит самое важное в начало и следует вашим правилам оформления». Для длинных сессий на русском языке, где порядок информации напрямую влияет на качество контекста и локализации, это может дать ощутимый прирост. Попробуйте задать в системном промпте (системный промпт, это начальная инструкция, которая задаёт модели рамки поведения на всю сессию) чёткие правила структуры и проверьте, насколько модель их удерживает к концу длинного разговора.
Маркетологу. Снижение цены API на 20% по прайсу и на 40% по задаче (при средних настройках) меняет экономику автоматизации. Если вы используете API для генерации описаний, рассылок или аналитики, пересчитайте бюджет: тот же объём работы может обойтись заметно дешевле. Но проверьте расход токенов на ваших конкретных задачах, модель может «наговорить» больше.
Предпринимателю в РФ и СНГ. Claude доступен через API, но в России напрямую подписку оформить затруднительно. Из доступных без обходных путей аналогов, YandexGPT и GigaChat. Тем не менее если вы уже работаете с Claude через VPN или посредников, переключение на Opus 5.5 при средних настройках снизит расходы без потери качества.
Я тестирую модели Anthropic с первого Claude, и Opus 5.5 впервые сделала ставку не на «больше параметров», а на «умнее тратить ресурсы». Улучшение структуры текста, это не маркетинговая мелочь: для тех, кто работает с длинными промптами на русском, разница между моделью, которая забывает ваши правила к середине сессии, и моделью, которая держит их до конца, это разница между инструментом и игрушкой. При этом стоит быть честным: «40% дешевле» в заголовке и «почти столько же при максимальных настройках» в таблице Artificial Analysis, это две разные истории. Выбирайте режим осознанно. Гонка снижения цен между Anthropic и OpenAI (Sol и Luna вышли в тот же день со снижением на 50% к GPT‑5.6) выгодна всем, кто строит продукты на API, но проверяйте итоговый расход, а не только прайс-лист.
Два запуска флагманов за один час, это не совпадение, а прямая конкуренция за разработчиков, и выигрывает тот, кто считает не цену токена, а стоимость решённой задачи.
По данным AINews / Latent Space

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Стартап создал ИИ, генерирующий вирусы с нуля: биобезопасность ИИ требует гонки, а не торможения
Компания Radical Numerics, основанная выходцами из Стэнфорда и Arc Institute, строит геномные языковые модели, способные генерировать функциональные вирусы с…
Xiaomi обошла DeepSeek и Qwen: её open weights модели возглавили рейтинг за $2,6 млн
Xiaomi 21 сентября 2026 года выложила в открытый доступ серию MiMo-V2.6, омнимодальные модели (работающие сразу с текстом, изображениями, кодом и другими…
ИИ-модель для production без RLHF: Jev набрала 40 млн просмотров за запуск
Модель Jev от TypeSafe AI отказалась от стандартного обучения на человеческих оценках (RLHF) в пользу собственного метода RLCD, который оптимизирует не…
Комментарии