
Claude Code AI и Claude AI ищут в вебе по-разному: что это значит для вашего сайта
Когда разработчик, автор или владелец сайта слышит «оптимизируйте контент под Claude», он не знает главного: Claude и Claude Code обращаются к вебу по-разному, цитируют по-разному и даже боты у них разные.
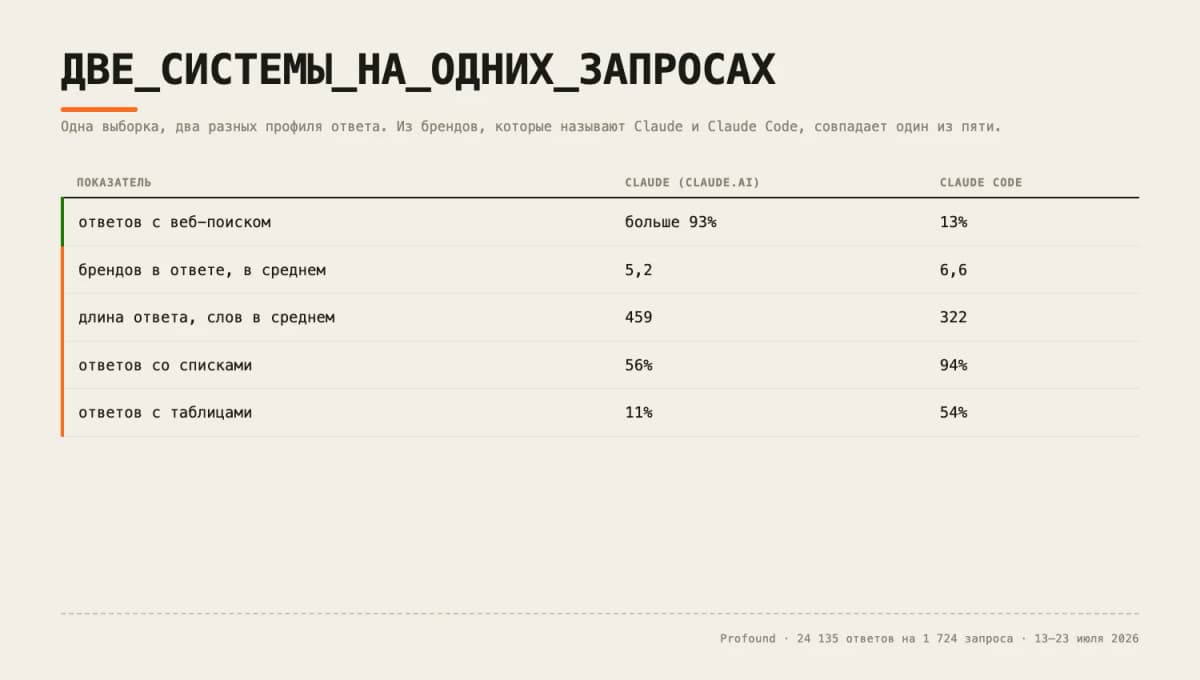
Документация Anthropic описывает два отдельных пути: Claude AI ищет в вебе почти в каждом ответе и отдаёт точную цитату с адресом, а Claude Code AI открывает страницы редко и чаще всего пересказывает их вспомогательной моделью, теряя детали намеренно.
Исследовательская компания Profound сняла 24 135 ответов на 1 724 запроса из 11 категорий с 13 по 23 июля 2026 года и опубликовала разбор «Claude and Claude Code are distinct answer engines» 24 августа 2026 года. Answer engine (система, которая отвечает вместо выдачи ссылок) у Claude и Claude Code работает настолько по-разному, что показатели разошлись почти по каждому параметру. Ниже собраны конкретные параметры из документации Anthropic и открытых исследований, которые нужны веб-мастеру и разработчику API прямо сейчас.
Что понадобится
- Доступ к документации Anthropic: platform.claude.com, code.claude.com, support.claude.com
- Доступ к серверным логам вашего сайта (access-log)
- Файл robots.txt с правом редактирования
- Базовое знание Python, если планируете парсить ответы Messages API
- 30 минут на настройку и проверку
Как Claude AI ищет в вебе и цитирует источник?
В выборке Profound приложение claude.ai вызывало веб-поиск более чем в 93% ответов. Это цифра одной выборки: другое исследование, с другим набором запросов и другим методом подсчёта, даёт для Claude AI 36,6%.
По документации Messages API модель сама решает, нужен ли поиск для конкретного вопроса. Для владельца сайта критичен один параметр: разработчик приложения на API может ограничить поиск списком разрешённых доменов (allowed_domains) или запрещённых (blocked_domains). Если ваш домен не в списке разрешённых, такое приложение ваш сайт не найдёт, как бы хорошо он ни был написан.
Найденные страницы приходят отдельным блоком web_search_tool_result, это список с адресом и заголовком каждой страницы. В тексте ответа Claude AI расставляет цитаты типа web_search_result_location. Каждая цитата содержит:
url, адрес страницыtitle, заголовок- зашифрованный указатель на источник
cited_text, кусок процитированного текста до 150 символов
Поля url, title и cited_text в токенах (единицах тарификации, по которым считается стоимость запроса) не учитываются.
Готовый код для парсинга цитат из ответа Claude API
Следующая функция на Python разбирает уже полученный ответ Messages API и собирает уникальные цитаты. Ни одного сетевого запроса она не делает.
def extract_cited_urls(response_content):
    """Уникальные цитаты web_search_result_location
    из response.content ответа Messages API."""
    seen = set()
    citations = []
    for block in response_content:
        for c in block.get("citations") or []:
            if c.get("type") != "web_search_result_location":
                continue
            url = c.get("url")
            if not url or url in seen:
                continue
            seen.add(url)
            citations.append({
                "url": url,
                "title": c.get("title", ""),
                "cited_text": c.get("cited_text", ""),
            })
    return citations
Функция проходит по блокам response.content, вытаскивает из них цитаты веб-поиска и отбрасывает повторы одного адреса. Если страница есть в блоке результатов, но её url отсутствует среди цитат, поиск нашёл страницу, но в текст ответа она не попала.
У Messages API есть второй инструмент, web fetch tool, который забирает содержимое страницы по адресу. По документации он открывает только те адреса, которые уже встречались в разговоре: в сообщении пользователя или в результатах прошлого поиска. Ссылку, которую модель сочинила сама, инструмент не откроет. JavaScript он не выполняет, для страниц, собираемых браузером, у Anthropic есть отдельный browser use tool.
Куда приходятся цитаты Claude AI?
Компания OtterlyAI подсчитала распределение: 379 321 цитата по 16 406 доменам за июнь 2026 года, запросы из сегментов SaaS и tech.
- Сайты брендов и продуктов собрали 64,0% цитат
- Новости и медиа получили 14,9%
- На топ-10 доменов пришлось 9,5% всех цитат, на топ-500 уже 59,9%
- 32,9% доменов процитированы ровно один раз
Claude Code AI открывает страницы иначе
Claude Code AI ищет в вебе заметно реже: в той же выборке Profound веб-поиск сработал лишь в 13% ответов. Поиск здесь один инструмент, WebSearch, и по справочнику инструментов Claude Code его разрешают или запрещают целиком, без правил для отдельных доменов.
Страницу Claude Code AI открывает инструментом WebFetch. До основной модели содержимое, как правило, доходит уже переработанным. По справочнику, WebFetch получает адрес и промпт (текстовую инструкцию) с описанием того, что нужно извлечь. Страницу по этому промпту читает вспомогательная модель поменьше, и основная модель получает её ответ, а не исходную страницу. Длинные страницы перед обработкой обрезаются до фиксированного числа символов. Документация прямо называет инструмент lossy by design: детали он теряет намеренно.
Исключение описано в стороннем разборе кода Claude Code AI от января 2026 года. HTML переводится в Markdown библиотекой Turndown, а пересказ пропускается при двух условиях сразу:
- Домен входит в зашитый список из примерно 80 сайтов документации (Python Docs, MDN, React, Kubernetes, AWS)
- Страница отдаётся как
text/markdownкороче примерно 100 тысяч символов
Обычный сайт в этот список не входит. Его страницу Claude Code AI получает пересказом, в каком бы формате она ни была. Anthropic список не публикует, и он может измениться с любым обновлением.
Допустим, вы разработчик и строите приложение на Messages API. Вызвали Claude AI с включённым веб-поиском, получили ответ. Прогоняете response.content через функцию extract_cited_urls и получаете список словарей: адрес, заголовок и процитированный фрагмент до 150 символов для каждого уникального источника. Если хотите узнать, какие страницы поиск нашёл, но модель не процитировала, сравните адреса из web_search_tool_result с адресами из цитат: разница покажет страницы, которые модель сочла нерелевантными для ответа.
Не путайте allowed_domains и blocked_domains: эти параметры задаёт разработчик приложения на стороне API, а не владелец сайта. Вы не можете «попросить» Claude AI искать только у вас. Вторая ошибка: считать, что формат llms.txt автоматически улучшит попадание в цитаты Claude Code AI. Страницу обычного сайта Claude Code AI всё равно пересказывает вспомогательной моделью, и формат файла на это не влияет, если домен не в зашитом списке документаций. Третья: переносить статистику Profound и OtterlyAI на любой сайт. Выборка Profound, по их собственному замечанию, вероятно, смещена к SaaS и технологическим компаниям. Для интернет-магазина или медицинского сайта цифры могут отличаться радикально.
Что делать с этим прямо сейчас, по ролям?
Веб-мастеру и владельцу сайта. Проверьте access-логи на обращения ботов Anthropic. Определите, какие боты заходят: Claude AI и Claude Code AI используют разные user-agent. Настройте robots.txt под те боты, которые хотите пустить или закрыть.
Разработчику API. Используйте функцию extract_cited_urls для парсинга цитат из ответов Messages API. Помните про параметры allowed_domains и blocked_domains, если строите приложение с ограниченной областью поиска. Учитывайте, что cited_text обрезается до 150 символов.
Автору и контент-маркетологу. Для попадания в цитаты Claude AI важнее всего оказаться на домене, который не заблокирован в конкретном приложении. Формат и структура страницы имеют значение, но если приложение фильтрует домены через allowed_domains, качество текста не поможет. Из доступных в РФ инструментов проверки видимости сайта для ИИ-систем пока нет прямых аналогов OtterlyAI.
Я разобрал документацию Anthropic целиком, и главный вывод неутешительный для тех, кто ищет простой рецепт. Claude AI и Claude Code AI, это два разных потока с разной механикой поиска, цитирования и обработки страниц. «Оптимизировать сайт под Claude» как единый совет не работает: нужно понимать, через какой именно инструмент к вам приходят. По моим наблюдениям, большинство советов на рынке смешивают оба инструмента в один, и это вводит в заблуждение. Честная оговорка: своих прогонов под эту статью я не делал, картина собрана по документации и открытым исследованиям Profound и OtterlyAI. Цифры выборок могут не отражать ситуацию для вашего конкретного сайта.
Два инструмента Anthropic живут в одном бренде, но ведут себя как разные поисковые системы. Разработчику API стоит начать с парсинга цитат, веб-мастеру с проверки логов, а автору с простого вопроса: через какой именно Claude на мой сайт вообще заходят.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
ИИ-агенты для обучения в ретейле: пошаговая сборка бота, который заменит наставника
Компании в ретейле всё чаще используют ИИ-агентов (программы, которые сами ведут диалог с сотрудником, отвечают на вопросы и проверяют знания) для обучения…
Как искусственный интеллект влияет на психологическую безопасность
Компания Microsoft, согласно данным McKinsey, сотрудники с опытом закупки внешних услуг на 58% эффективнее осваивают ИИ, и это число задаёт рамку для всего,…
Виртуальный сотрудник без пересертификации: архитектура PES разделяет личность и действия ИИ
Допустим, вы подключили ИИ-агента к финансовому отделу, а через неделю захотели сделать его тон мягче или добавить новую инструкцию, и выяснили, что любое…
Комментарии