
Что такое ИИ-агент и как отлаживать его по шагам, экономя токены
Почему это важно Впервые опубликована пошаговая методика отладки многоэтапных ИИ-агентов, которая позволяет находить ошибку в конкретном звене цепочки, а не…
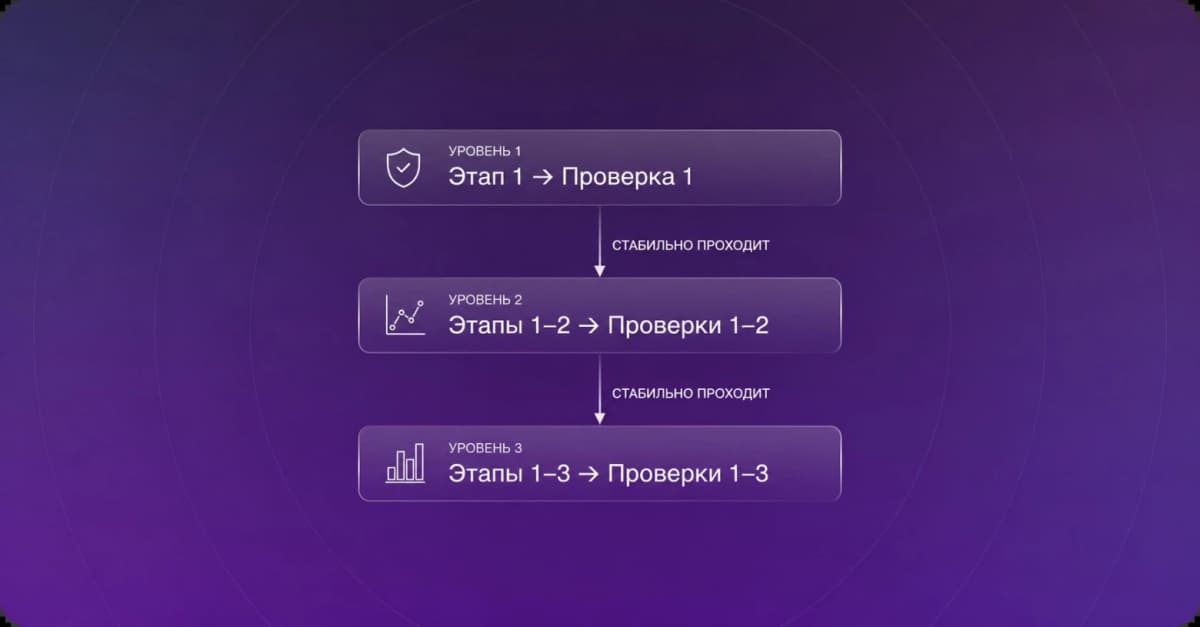
Впервые опубликована пошаговая методика отладки многоэтапных ИИ-агентов, которая позволяет находить ошибку в конкретном звене цепочки, а не гадать по финальному ответу, и при этом тратить токены только на тестируемый участок.
Если вы слышали про ИИ-агентов, но не понимали, как их контролировать, когда они ошибаются, этот материал закрывает пробел. Команда инженеров описала реальный кейс: агентный воркфлоу (цепочка шагов, где каждый ИИ-агент передаёт результат следующему) расследовал инциденты в IT-инфраструктуре и выдавал неверные ответы, а понять, на каком именно шаге всё ломалось, было невозможно.
Решение нашли в принципе поэтапной отладки аппаратуры: включаешь один этап, проверяешь его по заранее заданному критерию, убеждаешься в стабильности и только тогда подключаешь следующий.
| Что | Когда | Кто описал методику | Цена |
|---|---|---|---|
| Методика поэтапной отладки агентных воркфлоу для расследования инцидентов | Июнь 2025 | Инженерная команда (источник не называет конкретную компанию) | Бесплатно, открытое описание подхода |
Что такое ИИ-агент и почему его так сложно отлаживать?
Прежде чем разбирать методику, стоит разобраться с базой. Что такое ИИ-агент в контексте этой публикации: это программа, которая сама принимает решения, вызывает нужные инструменты (запросы к базам данных, метрикам, логам) и передаёт результат дальше по цепочке. В отличие от обычного чат-бота, агент действует автономно и многоступенчато.
Проблема в том, что каждый узел такой цепочки работает на языковой модели, а она недетерминирована: при одном и том же входе может дать разный результат. Сам воркфлоу (последовательность шагов) фиксирован, но внутри каждого шага модель «думает» по-своему.
Что нового
- Накопительная отладка вместо сквозного запуска. Вместо того чтобы прогонять весь воркфлоу целиком и читать итоговый журнал, инженеры обрезают цепочку после тестируемого этапа. Этапы до него выполняются вживую, этапы после него отключены.
- Контрольные проверки (gates) на каждом уровне. Для каждого этапа заранее задаётся формальный критерий: что именно он обязан гарантировать. Например, первый этап должен определить конкретный временной интервал инцидента, второй назвать подозреваемый компонент и расставить приоритеты.
- Проверка по действиям, а не по тексту. Контрольная проверка смотрит не на «красивый» текстовый ответ агента, а на фактически выполненные вызовы инструментов и их аргументы. Это исключает ситуацию, когда агент пропустил обязательный запрос, но сгенерировал правдоподобное резюме. Именно так работает галлюцинация (когда ИИ уверенно выдумывает то, чего не было) на уровне целого воркфлоу.
- Экономия токенов (единиц текста, за которые платят при каждом вызове модели). Полный прогон тратит токены на всех этапах и занимает минуты. Обрезанный прогон расходует ресурсы только до тестируемого этапа, что критично при многократных итерациях.
- Обнаружение бага в самом механизме оценки. Методика помогла найти ошибку там, где её не ждали: не в агенте, а в системе проверки результатов.
Четыре этапа воркфлоу расследования
Конкретный пайплайн (конвейер обработки), описанный в источнике, состоит из четырёх шагов:
- Определить временной интервал инцидента.
- Назвать наиболее вероятного «подозреваемого» (компонент системы) и оценить приоритет.
- Подтвердить гипотезу данными из независимого источника.
- Свести доказательства воедино и сформировать итоговый ответ.
Каждый шаг получает результат предыдущего. Ошибка на первом шаге, скажем, неправильно выбранное временное окно, отравляет все последующие.
Как попробовать?
- Разбейте свой агентный воркфлоу на изолируемые этапы. Для каждого этапа запишите, что именно он обязан выдать: конкретное значение, вызов определённого инструмента, структурированный результат.
- Напишите контрольную проверку для первого этапа. Проверка должна смотреть на действия агента (какие инструменты вызвал, с какими аргументами), а не на текст ответа.
- Запускайте первый этап многократно, пока он не будет стабильно проходить проверку. Один успешный прогон ничего не доказывает: модель недетерминирована, и удачный результат может быть случайностью.
- Подключайте следующий этап только после стабилизации текущего. Предыдущие этапы при этом продолжают работать вживую, не на кэшированных данных, чтобы тестируемый этап сталкивался с реальной вариативностью входов.
Есть ли аналоги в России?
В РФ агентные воркфлоу строят на YandexGPT и GigaChat. Обе платформы позволяют создавать цепочки вызовов, но готовых инструментов для поэтапной отладки с контрольными проверками ни одна из них пока не предлагает. Методику из этой публикации можно применить к любой модели: принцип «обрежь после тестируемого этапа и проверь по формальному критерию» не зависит от конкретного провайдера.
Если вы работаете с API YandexGPT или GigaChat и строите многошаговые сценарии, описанный подход адаптируется напрямую.
Что делать с этим прямо сейчас?
Автору Дзена. Если вы используете ИИ-агента для генерации контента в несколько шагов (сбор фактов, написание черновика, редактура), проверяйте результат каждого шага по отдельности. Не ждите финального текста, чтобы понять, что факты собраны криво.
Маркетологу. Агентные цепочки для аналитики и отчётов экономят время, но без поэтапного контроля вы рискуете получить красивый отчёт с ошибкой в основе. Введите «ворота качества» хотя бы на ключевых этапах.
Предпринимателю и разработчику. Контроль расхода токенов при отладке напрямую влияет на бюджет. Полный прогон десятки раз подряд обходится дорого. Обрезанный прогон по одному этапу может сократить расходы на отладку в разы, точных цифр источник не приводит, но логика очевидна: меньше этапов, меньше вызовов, меньше токенов.
Я вижу в этой методике главную ценность не для разработчиков инфраструктуры, а для всех, кто строит многошаговые сценарии с ИИ. Понимание того, что такое ИИ-агент на практике, начинается именно с момента, когда он ошибается и вы не можете понять где.
Подход «включай по одному звену» интуитивно понятен любому, кто чинил гирлянду: проверяешь лампочки по одной, а не трясёшь всю цепь. Но в мире ИИ-агентов этот здравый смысл почему-то забывают и запускают всё целиком, надеясь, что журнал выполнения подскажет проблему. Не подскажет.
Оговорка: методика требует инженерной работы. Написать хорошую контрольную проверку, по признанию самих авторов, бывает сложнее, чем написать сам этап. Это не «нажми кнопку и отладь».
Что сделать сегодня: если у вас есть хотя бы двухшаговый агентный сценарий, попробуйте запустить только первый шаг и формализовать, что именно он должен выдать. Одно это упражнение покажет, насколько нестабильна база, на которой строится всё остальное.
Частые вопросы
Чем поэтапная отладка отличается от обычного юнит-тестирования?
При юнит-тестировании каждый этап проверяют на фиксированных тестовых данных. В поэтапной отладке предыдущие этапы выполняются вживую, и тестируемый этап получает реальные, каждый раз немного разные входные данные. Это ближе к тому, что произойдёт в продакшене (реальной эксплуатации).
Можно ли применить метод, если я не программист?
Сам принцип, проверять каждый шаг по отдельности, прежде чем подключать следующий, работает и без кода. Если вы строите цепочку промптов (промпт, это текстовая инструкция для ИИ) в любом конструкторе, проверяйте выход каждого промпта вручную перед тем, как передавать его дальше. Формализовать проверку кодом эффективнее, но и ручной контроль лучше, чем запуск всей цепочки вслепую.
Зачем проверять действия агента, а не его текстовый ответ?
Языковая модель умеет генерировать убедительный текст даже тогда, когда пропустила обязательный шаг. Агент может написать «я проверил метрики за указанный период», хотя вызов к метрикам не сделал. Проверка по фактическим вызовам инструментов ловит именно такие случаи.
Если вы только начинаете работать с ИИ-агентами, запомните ключевое: не доверяйте финальному ответу цепочки, проверяйте каждое звено.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Anthropic отдала сильнейшие нейросети на безопасность опенсорса бесплатно, но без проверки человеком
Anthropic запустила бесплатный сканер уязвимостей OSS Scanner для опенсорс-проектов, и это первый случай, когда компания отдаёт свои сильнейшие модели, включая…
Google встроила нейросеть для создания игр прямо в браузер: код больше не нужен
Почему это важно Google открыла платформу, где игру можно собрать текстовым промптом без единой строчки кода, и это первый случай, когда нейросеть для создания…
Anthropic впервые запретила жестокость к Claude: что изменилось на официальном сайте нейросети
Anthropic второго июня впервые за полтора года обновила правила использования Claude, запретив жестокое обращение с моделью и расширив ограничения на…
Комментарии