
Что такое ИИ-агент без фреймворка: методология ICM заменяет код папками и markdown
Microsoft, OpenAI, CrewAI и другие упомянутые в источнике фреймворки и компании анализирую строго по тексту оригинала. Источник — публикация на Хабре, автор не указан по имени.
Разработчик на Хабре в июне 2025 года опубликовал методологию Interpretable Context Methodology, которая заменяет тяжёлые фреймворки для оркестрации ИИ-агентов обычной структурой папок и markdown-файлами.
Вместо того чтобы разбираться в API фреймворков вроде CrewAI или LangChain, инженер управляет поведением ИИ-агента через текстовые файлы, которые можно открыть в любом редакторе, прочитать и поправить вручную.
Если вы слышали про CrewAI, LangChain или AutoGen, вы знаете: это мощные, но громоздкие конструкции. Они берут на себя передачу контекста между шагами, память, обработку ошибок. Для сложных многозадачных систем это оправдано. Но когда задача последовательная и на каждом шаге нужен контроль человека, такие фреймворки создают непропорциональные инженерные затраты. Об этом прямо говорит автор публикации на Хабре.
ICM (Interpretable Context Methodology, методология интерпретируемого контекста) предлагает другой путь: один ИИ-агент, структура директорий вместо оркестратора, текстовые файлы вместо программных интерфейсов.
| Что | Когда | Кто опубликовал | Цена |
|---|---|---|---|
| Interpretable Context Methodology (ICM) | Июнь 2025 | Автор на Хабре (выжимка из оригинальной статьи) | Бесплатно, открытый подход |
Пять принципов, на которых стоит ICM
- Один этап — одна задача. Каждый шаг рабочего процесса живёт в своей папке и записывает результат в собственную директорию
/output. Никакой путаницы между шагами. - Текст как интерфейс. Этапы общаются между собой через markdown и json-файлы. Любой человек, способный открыть текстовый редактор, может проверить и изменить результат. Вопрос «что такое ИИ-агент в данном случае» решается просто: это программа, которая читает текстовые инструкции из папки и выполняет задачу по ним.
- Загрузка контекста слоями. ИИ-агент получает только тот контекст, который нужен для текущего шага. Автор ссылается на известную проблему: нерелевантный контекст ухудшает точность работы языковой модели даже при сжатии данных.
- Результат можно отредактировать. Каждый промежуточный файл открыт для проверки и правки человеком. Система продолжает работу с тем, что проверил человек. Автор связывает это с принципом «смешанной инициативы» Хорвица и парадигмой прямого манипулирования Шнайдермана.
- Настраиваем фабрику, а не продукт. Рабочее пространство конфигурируется один раз. Каждый запуск выдаёт новый результат, но конфигурация переиспользуется. Это реализация принципа continuous delivery (непрерывная доставка, когда производственные процессы должны быть повторяемыми).
Как устроена архитектура из пяти слоёв?
Рабочее пространство ICM — это обычная директория. ИИ-агент работает в контекстной иерархии из пяти слоёв, каждый отвечает на свой вопрос:
- Слой 0: AGENTS.md (примерно 800 токенов). Глобальная идентичность. Агент понимает, что содержит структура папок и где искать нужное. Это слой маршрутизации.
- Слой 1: CONTEXT.md (примерно 300 токенов). Информация по конкретному этапу: входные данные, процесс, ожидаемый результат.
- Слой 2: CONTEXT.md текущего этапа (от 200 до 500 токенов). Точки контроля. Здесь указано, какие файлы агенту загрузить и какие секции из них важны.
- Слой 3: эталон (от 500 до 2000 токенов). Дизайн-система, правила сборки, доменная информация, файлы навыков. Настраиваются перед началом работы и остаются стабильными.
- Слой 4: артефакты (размер варьируется). Результат предыдущего шага, данные от пользователя, всё специфичное для текущего запуска. Генерируются и потребляются при каждом прогоне.
По данным автора, при таком подходе каждый этап загружает контекст не более чем на 5 600 токенов (токен — это фрагмент текста, примерно три четверти слова, единица измерения «порции» для языковой модели). Для сравнения: типичный промпт (текстовая инструкция для ИИ) в CrewAI-проекте может занимать в разы больше.
Принципиальный момент: этапы выполняются строго последовательно. Папка /output предыдущего шага становится входными данными для следующего. Если пользователь вручную отредактирует файлы в 01_research/output, именно исправленная версия пойдёт на вход этапу 02_script. Подход унаследован от Unix-конвейеров и принципа «разделения зависимостей» Дейкстры: каждый модуль прячет свою внутреннюю логику от остальных.
Что с этого вам по ролям?
Разработчику и техническому автору Дзена. Если вы строите ИИ-агентов (программы, которые самостоятельно выполняют цепочку задач) для генерации контента или обработки данных, ICM даёт способ обойтись без CrewAI и LangChain. Достаточно создать папки, написать markdown-файлы с инструкциями и запустить одного агента. Вся логика читаема, отлаживается глазами, а не отладчиком.
Автору и копирайтеру без технического бэкграунда. Понимание того, что такое ИИ-агент и как он «думает», помогает точнее формулировать промпты. ICM показывает: агент работает лучше, когда получает узкий, чёткий контекст, а не всё сразу. Этот принцип работает и при обычном общении с ChatGPT или YandexGPT.
Предпринимателю в РФ и СНГ. Подход не привязан к конкретной модели или API. Его можно использовать с YandexGPT, GigaChat или любой открытой моделью (моделью с открытыми весами, которую можно запустить на своём сервере). Фреймворки вроде CrewAI и LangChain часто ориентированы на OpenAI API, а ICM работает с любым инструментом, способным читать текст.
Как попробовать?
- Создайте рабочую папку с файлами
AGENTS.mdиCONTEXT.mdпо структуре из статьи на Хабре. Опишите вAGENTS.md, какие этапы нужны и где лежат ресурсы. - Для каждого этапа создайте подпапку (
01_research/,02_script/и далее) с собственнымCONTEXT.md, папкойreferences/(эталонные файлы) иoutput/(результаты). - Запустите вашего ИИ-агента (Claude, ChatGPT, YandexGPT в режиме API или через терминальный клиент), передав ему
AGENTS.mdкак стартовую точку. Агент прочитает структуру и начнёт выполнять шаги последовательно. - После каждого этапа откройте папку
output/, проверьте результат, при необходимости отредактируйте. Агент на следующем шаге подхватит именно вашу версию.
Сравнение с российскими инструментами
В России нет прямого аналога ICM как методологии. Но принцип «давать модели только нужный контекст» применим к любому инструменту.
| Параметр | ICM | YandexGPT / GigaChat через API |
|---|---|---|
| Оркестрация | Структура папок и markdown | Нужен свой код или фреймворк |
| Контроль человека между шагами | Встроен: правите файлы вручную | Нужно реализовывать отдельно |
| Привязка к провайдеру | Нет, работает с любой моделью | Привязан к конкретному API |
| Порог входа | Нужно понимать структуру папок и уметь писать промпты | Нужны навыки программирования |
По моим наблюдениям, главная ценность ICM не в технической новизне, а в том, что подход делает поведение ИИ-агента прозрачным. Вы открываете папку, читаете текстовый файл и видите, что именно агент «знает» на каждом шаге. Никакого чёрного ящика.
Для тех, кто уже пробовал CrewAI или LangChain и утонул в абстракциях, это освобождение. Для тех, кто только начинает, это способ понять, что такое ИИ-агент на практике: не магия, а программа, которая читает инструкцию из файла, делает работу и кладёт результат в папку.
Оговорка: подход описан автором как методология, а не как готовый продукт с документацией и поддержкой. Для производственных систем с параллельными задачами он не подходит, автор сам указывает, что ICM заточен под последовательные процессы. Попробуйте на одном простом пайплайне из двух-трёх шагов и оцените, насколько это удобнее вашего текущего подхода.
Частые вопросы
Чем ICM отличается от обычного промпт-инжиниринга?
Промпт-инжиниринг (искусство составления текстовых инструкций для ИИ) работает с одним запросом. ICM организует цепочку запросов: каждый шаг получает свой промпт из отдельного файла, видит только нужный контекст и передаёт результат дальше. Это не замена промпт-инжинирингу, а надстройка для многошаговых задач.
Можно ли использовать ICM с YandexGPT или GigaChat?
Да. Подход не зависит от конкретной языковой модели. Если модель умеет читать текст и генерировать ответ, она работает внутри ICM. Достаточно передавать содержимое markdown-файлов через API или терминальный клиент.
Нужно ли уметь программировать?
Для базового использования достаточно умения создавать папки и редактировать текстовые файлы. Автор подчёркивает, что текст является интерфейсом: любой, кто может открыть редактор, может проверить и изменить результат. Для автоматизации запуска и интеграции с API понадобятся минимальные навыки работы с командной строкой или простые скрипты.
Если вы выстраиваете собственные ИИ-процессы и устали от того, что фреймворк знает о вашей задаче больше, чем вы сами, попробуйте развернуть одно рабочее пространство по схеме ICM и прогнать через него реальную задачу: разница в прозрачности чувствуется с первого запуска.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
DeepSeek desktop вышел для Windows и Mac: агент работает в фоне, но аналитику не отключить
DeepSeek 30 сентября выпустила десктопное приложение Harness Desktop для Windows и Mac, которое превращает браузерного ИИ-агента в полноценную программу с…
Что такое ИИ-агент в Telegram: собираем бота с визуализацией шагов за вечер
Оригинал обрывается на середине предложения, поэтому работаю строго по тому, что передано. Telegram даёт ботам встроенный интерфейс для отображения хода работы…
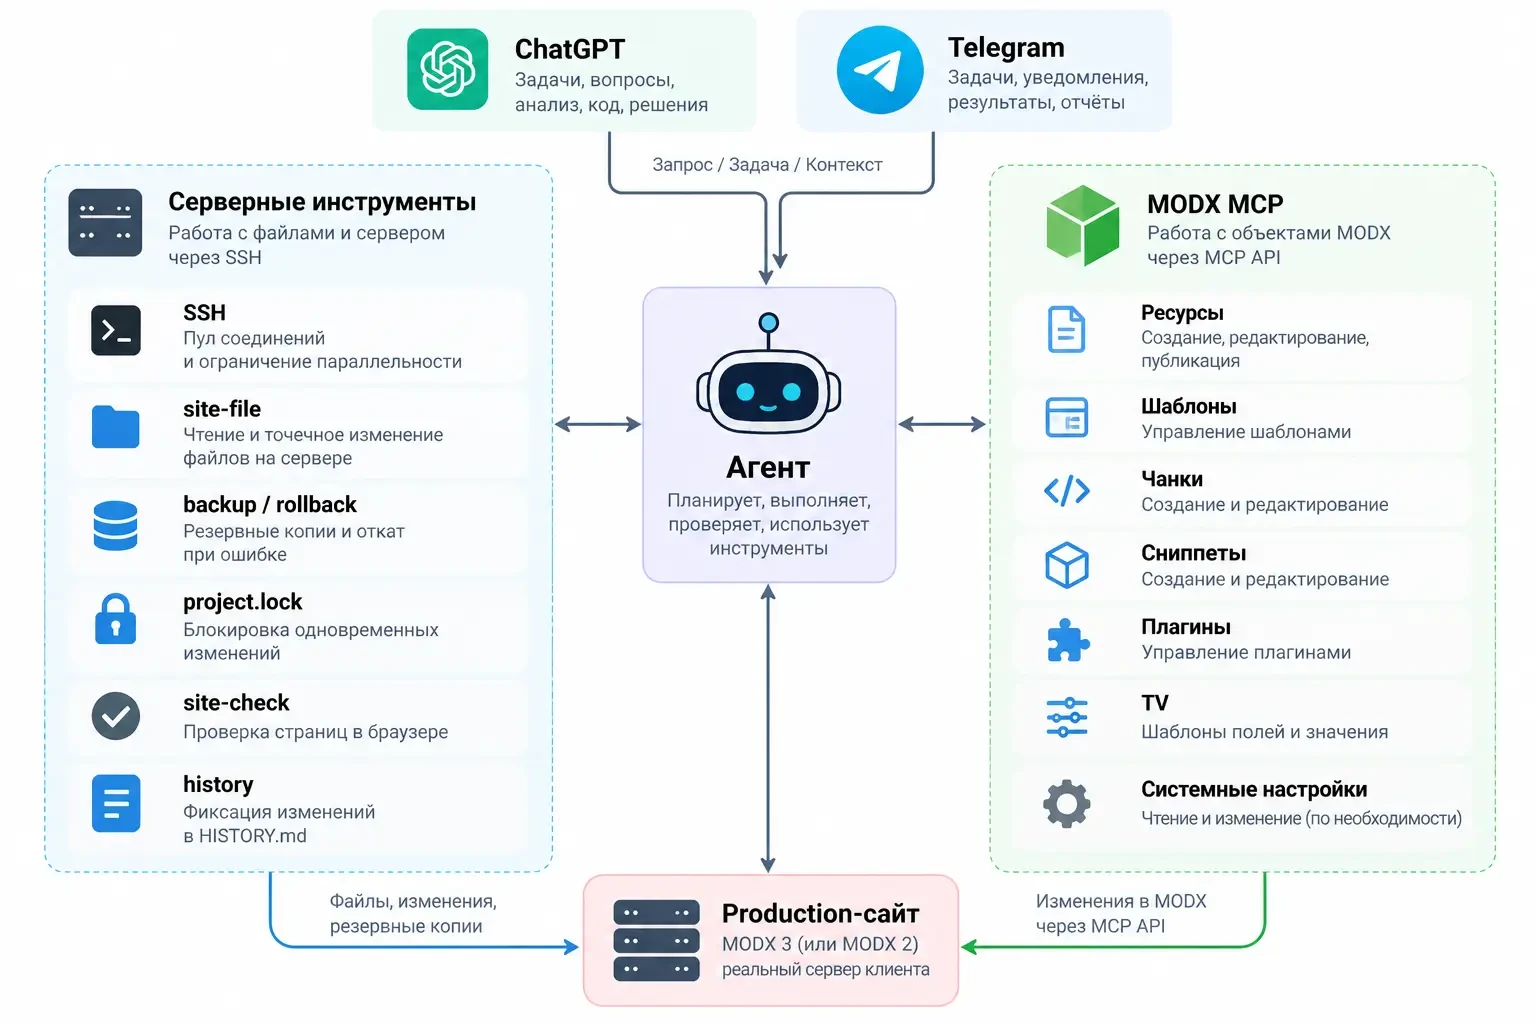
ИИ для тестирования сайтов блокируется хостингом: как обойти лимит SSH за 30 минут
Компания‑хостер заблокировала доступ трижды за трое суток, потому что ИИ-агент открывал десятки коротких SSH-соединений вместо одного длинного, и команда…
Комментарии