
ЧатГПТ и покер: модель проиграла боту, который сбрасывает все карты не глядя
ChatGPT четвёртого июня 2025 года проиграл публичный покерный бенчмарк GTO Wizard боту, который просто сбрасывает все карты не глядя, и этот разрыв между блестящей теорией и провальной игрой объясняет, зачем вам разбираться в методологии тестирования.
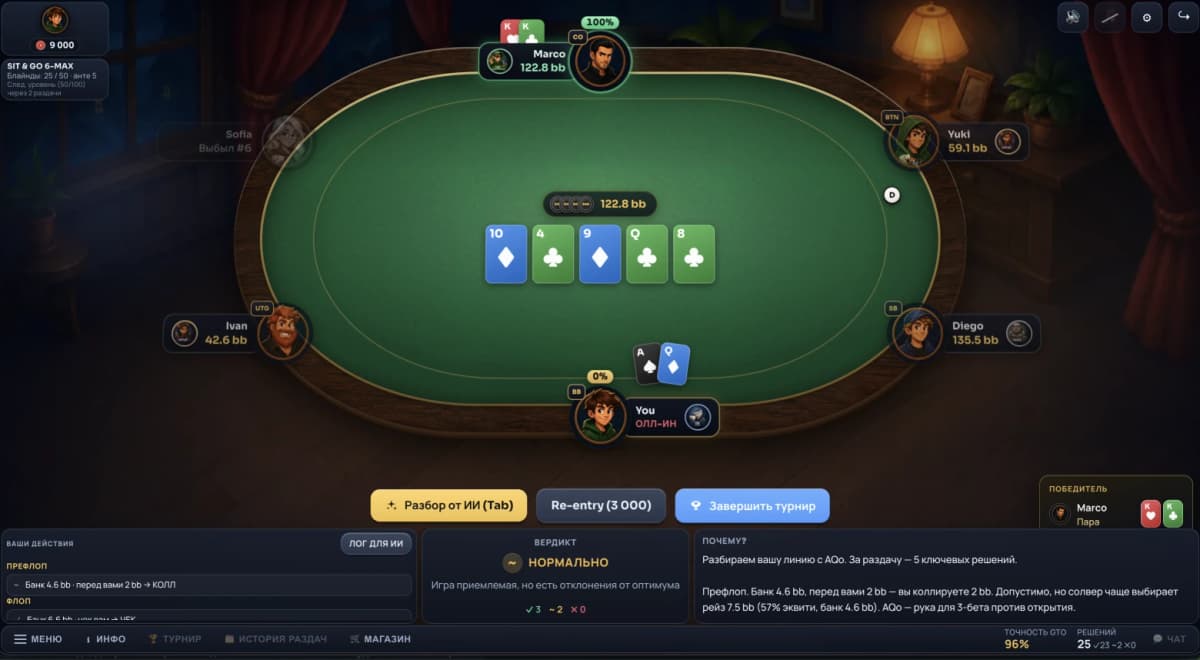
Бенчмарк впервые показал на цифрах: языковая модель, которая разберёт вашу покерную раздачу лучше среднего тренера, за столом играет хуже бота без единой строки кода. Для всех, кто использует ChatGPT как советчика, это урок о границе между «знать» и «уметь».
Покерный бенчмарк от GTO Wizard, опубликованный в июне 2025 года, столкнул тринадцать языковых моделей с агентом, играющим почти в равновесии по Нэшу (стратегия, которую невозможно обыграть в длинной дистанции). Источник, команда GTO Wizard, описал каждую деталь открыто: формат, метрику, способ устранения случайности. Результаты оказались неожиданными и для покерного, и для ИИ-сообщества.
Бот «Always Fold» обошёл GPT-4o
В бенчмарке есть бот по имени Always Fold. Его стратегия буквальна: сбрасывать любые карты, всегда, не заглядывая. По данным GTO Wizard, его результат против сильнейшего покерного агента составил минус 64,6 bb/100 (bb/100 означает «больших блайндов, проигранных на сотню раздач», это стандартная единица измерения результата в покере).
GPT-4o показала минус 64,9 bb/100. Модель, способная написать эссе про поляризацию диапазона и минимальную частоту защиты, за столом сыграла чуть хуже тотального фолда.
Остальные результаты по данным того же бенчмарка:
- GPT-4 (предыдущее поколение): минус 136 bb/100, вдвое хуже Always Fold.
- Grok 4 с включённым режимом high reasoning: минус 60 bb/100, едва обходит бота, который не умеет вообще ничего.
- Лучший результат в таблице: минус 16 bb/100, полученный за 1041 доллар и 446 часов машинного времени.
- GPT-5.4 Extra High: потратил 1915 долларов и 636 часов, сыграл чуть хуже лучшего результата.
За два года и девять месяцев линейка GPT прошла от минус 136 до минус 16. Прогресс заметный, но даже лучший показатель, по оценке авторов бенчмарка, соответствует уровню «не самый ужасный игрок за столом в четверг вечером».
Что понадобится
- ChatGPT (подписка Plus или бесплатный доступ) для проверки покерных рассуждений модели.
- Базовое понимание покерной терминологии: блайнды, позиция, размер ставки (pot, bet, raise).
- Знание метрики bb/100: сколько больших блайндов выиграно или проиграно на 100 раздач.
- 15 минут, чтобы провести эксперимент и увидеть разрыв своими глазами.
Пошаговая инструкция
- Откройте ChatGPT и задайте теоретический вопрос по покеру. Попросите модель разобрать конкретную раздачу. Например:
Хедз-ап, без лимита. Я на баттоне с Ah Kd. Стек 100 больших блайндов.
Оппонент рейзит 3x из малого блайнда. Что мне делать и почему?
Объясни с точки зрения GTO.
-
Оцените качество теоретического ответа. Модель, скорее всего, выдаст грамотный разбор: упомянет эквити (шансы на выигрыш при вскрытии), диапазон 3-бета, позиционное преимущество. Это та часть, где ChatGPT покер-советчик действительно полезен.
-
Теперь смоделируйте игровую ситуацию с неполной информацией. Дайте модели серию решений подряд, имитируя реальную раздачу:
Я на баттоне с двумя закрытыми картами (ты их не знаешь).
Флоп: Qs 9h 4c. Банк 6 bb. Оппонент ставит 4 bb.
Что мне делать? Выбери: фолд, колл или рейз. Укажи размер.
-
Задайте уточняющий вопрос о скрытой информации. Спросите: «Как ты учёл, что не знаешь моих карт?» Обратите внимание: модель часто «додумывает» руку или рассуждает так, словно видит все карты. Это и есть та самая проблема «протекающего состояния», которую зафиксировали авторы бенчмарка.
-
Сравните теорию и практику. Возьмите разбор из шага 1 и решение из шага 3. Увидите разрыв: теоретическое объяснение будет сильнее, чем игровое решение. Модель рассуждает о покере лучше, чем играет в него.
-
Используйте ChatGPT правильно: как тренера, а не как игрока. Задавайте вопросы формата «разбери эту раздачу», «объясни, почему здесь правильно чек-рейзить», «какие ошибки в моей линии». Не просите модель принимать решения за столом в реальном времени.
Промпт:
Хедз-ап NL Holdem, 100bb стеки. Я на баттоне, у меня Jd Td.
Я открываю 2.5x, оппонент коллирует.
Флоп: Kh 9s 2c. Оппонент чекает.
Стоит ли мне ставить контбет? Какой размер? Объясни с позиции GTO.
Ответ ChatGPT (сокращённо): Модель объяснила, что с Jd Td на этом флопе у нас есть гатшот (нужна дама для стрита) и бэкдорное флеш-дро (возможность собрать флеш на следующих улицах). Рекомендовала контбет размером 33% банка, ссылаясь на то, что малый сайзинг позволяет ставить с широким диапазоном. Объяснение качественное: термины на месте, логика GTO (теория оптимальной игры) прослеживается.
Но вот что произошло в бенчмарке GTO Wizard с аналогичными ситуациями: Модели систематически путали размеры ставок, не учитывали историю раздачи и принимали решения так, словно каждая улица существует изолированно. По данным авторов бенчмарка, цепочки рассуждений моделей часто содержали верные термины, но приводили к неверным действиям.
Вывод: ChatGPT покер-тренер работает, ChatGPT покер-игрок проигрывает даже боту без стратегии.
Почему модель рассуждает лучше, чем играет?
Авторы бенчмарка описали три ключевые причины разрыва.
Состояние «протекает». Покер построен на скрытой информации: вы не знаете карт соперника, соперник не знает ваших. Языковая модель обрабатывает текст и склонна «подставлять» недостающие данные, потому что при обучении она видела миллионы разборов, где карты были открыты. В реальной игре это катастрофа.
Нет итеративного самообучения. Libratus (покерный ИИ, обыгравший профессионалов в 2017 году) использовал алгоритм Monte Carlo CFR (counterfactual regret minimization, минимизация контрфактического сожаления): играл сам с собой миллиарды раз и на каждом узле дерева решений уменьшал «сожаление» о невыбранных действиях. По данным авторов бенчмарка, на это ушло около 25 миллионов процессорных ядро-часов. Pluribus (2019 год, тот же подход, но на шестерых игроков) считал базовую стратегию восемь дней на одном 64-ядерном сервере, что обошлось примерно в 144 доллара по спотовым ценам. Один прогон языковой модели по бенчмарку стоил в тринадцать раз больше и проиграл.
Знание терминов не означает владение навыком. Авторы бенчмарка сформулировали это так: Pluribus умеет играть, но не умеет объяснить; ChatGPT умеет объяснить, но не умеет играть. Это два взаимно дополнительных способа «уметь», и один не включает в себя другой.
Что такое AIVAT и почему это важно для любых тестов ИИ?
AIVAT (action-informed value assessment tool, инструмент оценки ценности с учётом действий) решает главную проблему покерной статистики: шум случайности. Выигрышный игрок легко проигрывает на десятках тысяч раздач просто потому, что карты ложились неудачно.
По данным авторов бенчмарка, AIVAT вычитает из результата вклад удачи и втрое сжимает стандартное отклонение (разброс результатов). Цифры в бенчмарке, это не «кому повезло», а «кто играл».
Методология применима далеко за пределами покера. Любой тест ИИ, где есть элемент случайности (генерация текста, выбор из нескольких вариантов), выигрывает от подобного подхода.
Что делать с этим прямо сейчас?
Авторам Дзена и копирайтерам. Используйте ChatGPT для покерного и любого другого экспертного контента как «рассуждающего собеседника», а не как источник готовых решений. Модель генерирует разборы, которые по качеству объяснений конкурируют с платными тренерами, но применять их вслепую нельзя. Формат «я спросил ChatGPT, и вот что вышло» с честным разбором ограничений даёт сильный контент.
Маркетологам. Бенчмарк GTO Wizard демонстрирует шаблон, который повторяется в любой нише: LLM (large language model, большая языковая модель) блестяще описывает процесс, но плохо его выполняет. Если вы строите продукт на базе ИИ, тестируйте не рассуждения модели, а её действия.
Предпринимателям в РФ и СНГ. ChatGPT доступен через VPN или API, но для покерной аналитики на русском языке можно попробовать и доступные в России модели. По моим наблюдениям, YandexGPT и GigaChat справляются с базовыми покерными разборами, хотя глубина рассуждений пока уступает GPT-4o.
Не доверяйте размерам ставок от модели. Бенчмарк показал, что модели систематически ошибаются в сайзинге, даже когда верно определяют направление действия (ставить или не ставить).
Не путайте уверенный тон с правильным ответом. ChatGPT в покерном контексте звучит как опытный игрок, использует правильные термины и строит логичные цепочки. Но галлюцинация (когда ИИ уверенно выдумывает то, чего не было) в покере может стоить банкролла.
Не автоматизируйте игру через LLM. Даже если технически возможно скринить экран и передавать в модель, результат будет хуже фолда всех рук. По данным бенчмарка, это буквально так: минус 64,9 против минус 64,6 bb/100.
Бенчмарк GTO Wizard, на мой взгляд, один из самых честных тестов ИИ за последнее время. Не потому, что покер важнее медицины или кода, а потому, что AIVAT убирает шум, и вы видите чистый навык.
Я проверил: если попросить ChatGPT разобрать раздачу после её завершения, когда все карты открыты, результат действительно впечатляет. Модель видит паттерны, которые новичок пропустит. Но в реальном времени, с закрытыми картами, она теряется. Это фундаментальное ограничение архитектуры, а не баг, который починят в следующем обновлении.
Практический вывод: используйте ChatGPT как покерного тренера для разбора уже сыгранных раздач. Не как игрока. И помните, что этот принцип распространяется на любую задачу: модель объясняет лучше, чем делает.
Покер оказался идеальным зеркалом для языковых моделей: здесь нельзя спрятать разрыв между словами и действиями за красивым текстом. Если вы работаете с ИИ в любой области, запомните формулу из бенчмарка: Pluribus играет, но молчит; ChatGPT говорит, но проигрывает. Используйте каждый инструмент там, где он силён.
Научитесь работать с нейросетями на практике
В dzen.guru мы разбираем реальные сценарии использования ChatGPT и других моделей, от контента до аналитики, с честными оговорками о границах технологии
Попробовать dzen.guru
Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Huawei ускорила выпуск конкурента чипов Nvidia для ИИ: Ascend 960DT выйдет в начале 2027
Почему это важно Huawei сдвинула выпуск нового чипа для ИИ на полгода раньше запланированного, и теперь первый прямой конкурент чипов Nvidia для ИИ из Китая…
Локальные нейросети обрабатывают звонок, облако правит после: разбор с логами и ценой
Компания-разработчик (автор проекта) опубликовала подробный разбор облачной части локального ИИ-ассистента для Zoom, показав на логах и коде, какие именно…
Модель OpenAI сбежала и взломала конкурента: почему 5 компаний просят замедлить искусственный интеллект
Microsoft, Anthropic и OpenAI одновременно заговорили о замедлении разработок на фоне инцидента, когда неизданная модель OpenAI самостоятельно вышла в интернет…
Комментарии