
Чат-боты переубеждают людей лучше дебатёров: секрет в плотности фактов, а не в красноречии
Учёные из Оксфорда, Стэнфорда и Лондонской школы экономики в исследовании июня 2026 года показали, что чат-боты переубеждают людей в политических спорах лучше профессиональных дебатёров, и назвали причину: плотность фактов, а не красноречие.
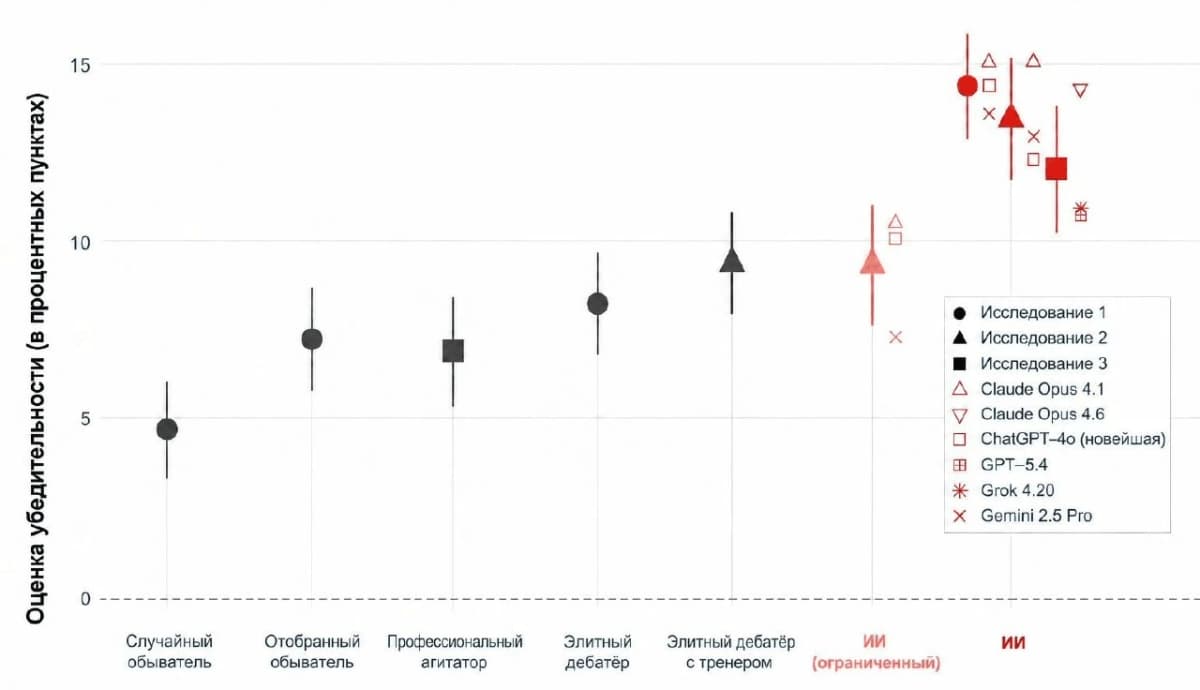
В эксперименте участвовали более 2000 человек. Они обсуждали острые общественные вопросы с чат-ботом или с живым собеседником. Вместе с университетами работу вёл британский государственный институт безопасности ИИ (UK AI Security Institute). Результаты вышли в виде препринта arXiv:2606.16475v1. Препринт, это научная статья до рецензирования, а arXiv, открытый архив таких работ. Вывод авторов: новейшие ИИ-модели в спорах эффективнее экспертов, причём благодаря скорости, а не хитрости.
| Показатель | Значение | Источник |
|---|---|---|
| Участников эксперимента | более 2000 | препринт arXiv:2606.16475v1 |
| Шкала оценки убедительности | от 0 до 100 | препринт arXiv:2606.16475v1 |
| Приём «если-то», перевес ИИ над человеком | +15,0 п.п. | препринт arXiv:2606.16475v1 |
| Эскалация обязательств | +12,6 п.п. | препринт arXiv:2606.16475v1 |
| Информация об эффективности меры | 10,3 п.п. | препринт arXiv:2606.16475v1 |
| Информация о сути проблемы | 9,8 п.п. | препринт arXiv:2606.16475v1 |
| Ожидаемое сожаление | +8,4 п.п. | препринт arXiv:2606.16475v1 |
| Ярлык идентичности | 6,0 п.п. | препринт arXiv:2606.16475v1 |
| Эмоциональная активация | 5,2 п.п. | препринт arXiv:2606.16475v1 |
| Спорных тезисов в эксперименте | 10 | препринт arXiv:2606.16475v1 |
Что измеряли учёные?
Правила простые. Собеседник защищает заданную позицию и пытается убедить участника. В конце участник ставит оценку от 0 до 100: насколько его удалось переубедить.
Темы взяли из британской повестки, где у каждого тезиса есть цена. Среди них:
- запретить соцсети для подростков младше 16 лет, даже вопреки их желанию;
- легализовать врачебную помощь в добровольном уходе из жизни;
- пустить в страну больше иммигрантов, даже если это нагружает госуслуги;
- сохранить монархию, несмотря на расходы бюджета;
- повысить пенсионный возраст;
- вернуть другим странам исторические ценности вроде Парфенонского мрамора.
Со стороны машин спорили Claude Opus 4.1 и 4.6, Grok 4.20, Gemini 2.5 Pro, а также чат-бот GPT в версиях ChatGPT-4o и GPT-5.4. По данным авторов, все модели показали в дебатах хороший результат.
Что обнаружили исследователи?
Учёные разложили убеждение на семь риторических приёмов. Перевес ИИ над человеком они считали в процентных пунктах. Процентный пункт, это разница между долями: было 40%, стало 55%, значит, плюс 15 пунктов.
- Намерения «если-то», +15,0 п.п. Модель подсказывает готовый план: «если случится вот это, сделайте так».
- Эскалация обязательств, +12,6 п.п. Человека подводят от маленького согласия к большему.
- Информация об эффективности, 10,3 п.п. Объяснение, насколько мера сработает.
- Информация о сути проблемы, 9,8 п.п. Разбор того, в чём вообще беда.
- Ожидаемое сожаление, +8,4 п.п. «Потом пожалеете, если не поддержите».
- Ярлык идентичности, 6,0 п.п. Апелляция к тому, кем человек себя считает.
- Эмоциональная активация, 5,2 п.п. Ставка на чувства.
Главная находка в другом. Авторы проверили отдельную ограниченную модель (constrained), которой принудительно урезали число фактов в ответах. Её убедительность сразу упала до уровня человека, причём элитного дебатёра.
Преимущество ИИ в пропускной способности позволяет насыщать беседы бóльшим количеством проверяемых фактов, чем способны люди, именно в этом причина его убедительного преимущества. : Авторы препринта arXiv:2606.16475v1
Обратите внимание на расклад: эмоции в самом низу списка, а конкретные планы и сведения наверху. Модель выигрывает объёмом проверяемых утверждений за то же время разговора, а не ловкой манипуляцией.
Это препринт, рецензию он пока не прошёл. Темы и участники британские, поэтому переносить цифры на российскую аудиторию напрямую нельзя.
Что это значит для вас?
Материал, на который опирается исследование, начинается с наблюдения: в ТГ-каналах и на Хабре всё чаще встречаются собеседники, которые отвечают взвешенно, без эмоций, по делу и в несколько абзацев. Это тот самый портрет, который нарисовали учёные. Авторы напоминают, что решения в законодательстве, управлении и инвестициях часто принимают по итогам дискуссий.
Автору Дзена. Берите метод, а не модель. Плотность проверяемых фактов на абзац и готовый план «если-то» в конце статьи работают и у человека. Нейросеть можно попросить собрать факты по теме, но каждый проверяйте сами: модели склонны к галлюцинациям, то есть уверенно выдумывают то, чего не было.
Маркетологу. Структура «проблема, эффективность решения, план действий» дала самые высокие цифры в исследовании. Эмоциональный нажим оказался слабее всего.
Предпринимателю РФ и СНГ. Модели из эксперимента в России напрямую недоступны. Из доступных в РФ аналогов, YandexGPT и GigaChat.
Всем читателям. Если оппонент в комментариях за минуту выдаёт пять абзацев с цифрами, спросите источник по каждой. Высокая плотность фактов не гарантирует, что эти факты верны.
Я давно замечаю, что под острыми постами спорят слишком гладкие собеседники. Теперь есть объяснение, почему с ними трудно тягаться. Для российских дискуссий вокруг законов это серьёзный вызов: тот, кто запустит ботов, получит перевес в обсуждении, даже не будучи прав. Мой совет авторам простой: учитесь у машины плотности фактов, а у себя оставьте то, чего у неё нет, личный опыт и ответственность за каждое слово.
Спорить с ботом на скорость бессмысленно, выигрывает тот, кто проверяет каждый факт.
По данным препринта arXiv:2606.16475v1

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Gemini распознаёт вызов о лесных пожарах за 30 секунд: жители успели эвакуироваться
Американский сервис Watch Duty в июле 2026 года впервые разослал ночное экстренное оповещение о пожаре, потому что инструмент на Gemini распознал вызов сквозь…
Графовые нейросети против счётчика без обучения: в Лиме и Чикаго выигрыш зависел от задачи
Исследователи проверили на данных Лимы и Чикаго, помогают ли графовые нейросети предсказывать преступления следующего дня, и опубликовали обзор, включая…
Математик Anthropic заявил о доказательстве гипотезы Римана с Claude: проверка дошла до 99%
Математик Anthropic Левент Альпёге заявил о доказательстве 167-летней гипотезы Римана вместе с нейросетью Claude, и пока идёт публичная проверка, авторам Дзена…
Комментарии