
Бен Аффлек увлекается искусственным интеллектом
Бен Аффлек продал ИИ-стартап Netflix за 587 миллионов долларов и на нескольких интервью объяснил, как устроены нейросети, почему он сам пишет код на Python и зачем восемь месяцев снимал собственный датасет, чтобы не использовать чужие данные.
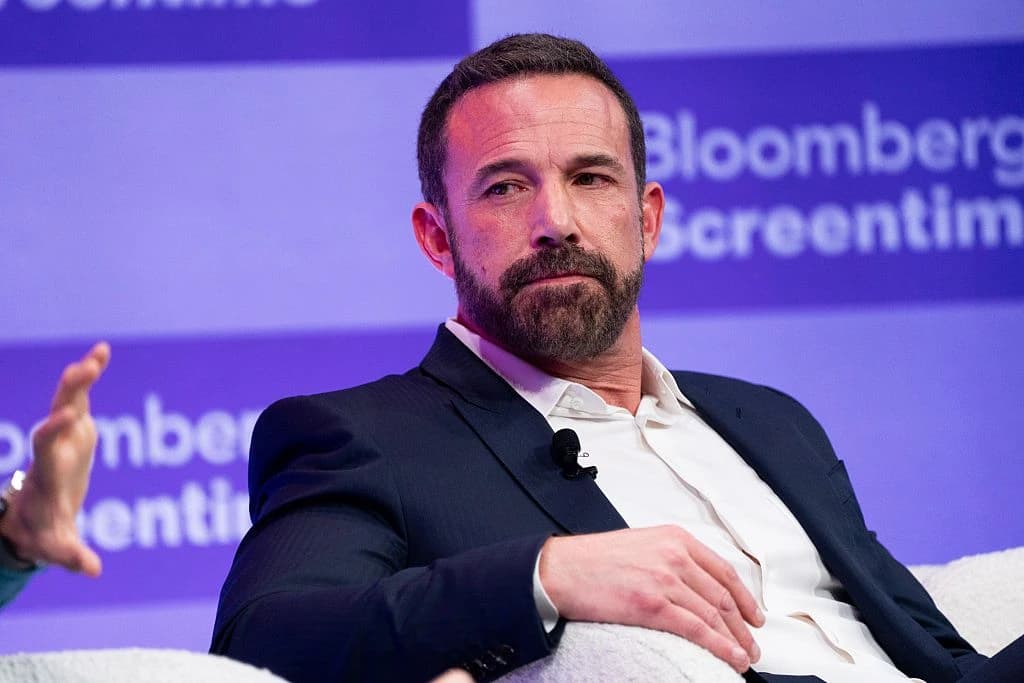
Аффлек показал рабочую модель этичного ИИ в кино: вместо того чтобы обучать модели на чужих работах, он создал собственный набор данных и дообучил открытые модели под конкретные задачи, сохранив права авторов.
Тема голых знаменитостей, нарисованных и раздетых ИИ, стала болезненной для индустрии: нейросети генерируют фейковые изображения без согласия людей, а правовая защита отстаёт от технологий. На этом фоне подход Аффлека выделяется тем, что он выстроил процесс с нуля, не затрагивая чужие права на внешность и творчество. Об этом актёр рассказал в интервью GQ (серия «One More Question») и на конференции Screentime 2026 в Лос-Анджелесе в беседе с Лукасом Шоу из Bloomberg.
| Что | Когда | Кто | Цена |
|---|---|---|---|
| Продажа ИИ-стартапа Аффлека компании Netflix | 2025 год (точная дата не раскрыта) | Бен Аффлек, Netflix | По данным СМИ, 587 млн долларов (сам Аффлек заявил, что цифра «неточная» и что он владел не всей компанией) |
Что сделал Аффлек и почему об этом говорят?
-
Создал собственный датасет (набор данных для обучения нейросети). Вместо того чтобы брать чужие изображения или видео, Аффлек привлёк инвестиции, арендовал оборудование и около восьми месяцев снимал материал множеством камер. Этот датасет стал основой для дообучения (fine-tuning, обучение модели на своих примерах под узкую задачу) открытых моделей.
-
Дообучил открытые модели под задачи кинопроизводства. На конференции Screentime 2026 Аффлек объяснил, что брал модели с открытыми весами (open weights, когда параметры модели доступны для модификации), «размораживал» веса и обучал модель соответствовать определённым кинематографическим стандартам. При этом создатель фильма сохраняет права на свою работу.
-
Применил технологию в своём фильме «Animals». ИИ помогал на этапе постпродакшена, то есть обработки уже отснятого материала.
-
Продемонстрировал техническую грамотность. В интервью GQ Аффлек свободно оперировал терминами: нейросети, трансформеры (архитектура, на которой построены ChatGPT и подобные модели), тензоры (числовое представление изображения, где каждый пиксель описан значениями красного, зелёного и синего каналов), GPU (графические процессоры, на которых обучают нейросети), инференс (inference, процесс, когда обученная модель выдаёт результат). Он рассказал, что пишет «довольно корявые скрипты на Python».
-
Высказался об угрозах ИИ без паники. Аффлек заявил, что не боится «Скайнета» и не считает, что ИИ заменит кинобизнес. Его тревожит другое: рост числа завышенных оценок в колледжах на 30% за три года (по его словам), «выученная беспомощность» и безответственное использование технологий.
Как подход Аффлека связан с проблемой фейковых изображений?
Когда нейросети обучают на данных без разрешения авторов, появляются в том числе голые знаменитости, нарисованные и раздетые ИИ, против воли самих людей. Аффлек выстроил альтернативу: его стартап создавал данные с нуля, в среде, «где существуют давние устоявшиеся отношения вокруг права на внешность», как он сам выразился. Это не решает глобальную проблему дипфейков, но показывает, что коммерчески успешная модель может работать без эксплуатации чужих прав.
Как попробовать похожий подход самому?
-
Определите узкую задачу. Аффлек подчёркивал, что его модели решали «конкретные дискретные задачи, генерирующие ценность», а не делали «всё подряд». Для автора Дзена это может быть, например, генерация обложек в едином стиле канала.
-
Соберите собственный датасет. Даже небольшой набор ваших фотографий, иллюстраций или текстов, созданных вами, юридически чище, чем скачанные из интернета чужие работы.
-
Используйте открытые модели с возможностью дообучения. В России доступны, например, Kandinsky от «Сбера» для изображений или модели из каталога Hugging Face. Не каждая модель позволяет «разморозить веса», но многие поддерживают дообучение через адаптеры (небольшие настройки поверх основной модели).
Есть ли аналоги в России?
Прямого аналога стартапа Аффлека в российском кино пока нет. Но инструменты для работы с ИИ в контенте доступны.
| Задача | Зарубежный инструмент | Доступный в РФ аналог |
|---|---|---|
| Генерация и редактирование изображений | Midjourney, DALL-E | Kandinsky («Сбер»), Шедеврум («Яндекс») |
| Текстовая генерация и сценарии | ChatGPT (OpenAI) | YandexGPT, GigaChat («Сбер») |
| Дообучение моделей на своих данных | Hugging Face, открытые модели | Hugging Face доступен, часть моделей «Сбера» поддерживает дообучение через API |
По моим наблюдениям, YandexGPT и GigaChat пока не предлагают полноценного дообучения для видео, но для текста и изображений базовые сценарии уже рабочие.
История Аффлека ценна не технической глубиной, а принципом: он потратил деньги и восемь месяцев на создание собственных данных вместо того, чтобы использовать чужие. Для авторов Дзена и российских творцов это прямой ориентир. Проблема голых знаменитостей, нарисованных и раздетых ИИ, растёт именно потому, что большинство моделей обучены на данных без согласия людей. Аффлек показал, что этичный путь может быть коммерчески выгодным.
Что сделать сегодня. Если вы создаёте визуальный контент, начните собирать собственную библиотеку изображений и текстов. Даже 200 фотографий в едином стиле уже дают основу для дообучения генератора обложек. Если вы маркетолог или предприниматель, проверьте, на каких данных обучены модели, которые вы используете: это вопрос не только этики, но и юридических рисков.
Оговорка: сумма сделки с Netflix (587 млн долларов) приводится по данным СМИ. Сам Аффлек публично заявил, что цифра «неточная», и уточнил, что не владел компанией целиком. Реальные условия сделки не раскрыты.
Частые вопросы
Аффлек правда умеет программировать?
По его собственным словам из интервью GQ, он пишет «довольно корявые скрипты на Python». Он не называет себя программистом, но достаточно разбирается в коде, чтобы работать со свёрточными нейросетями (convolutional neural networks, тип нейросетей, который распознаёт образы на изображениях) и понимать, как устроен процесс обучения модели.
Можно ли повторить его подход без голливудского бюджета?
Масштаб Аффлека требовал серьёзных вложений: восемь месяцев съёмок с профессиональным оборудованием. Но сам принцип работает и в малом масштабе. Автор Дзена может собрать датасет из собственных иллюстраций или фотографий и дообучить генератор изображений через сервисы вроде Hugging Face. Результат будет скромнее, но юридически чистым.
Заменит ли ИИ режиссёров и сценаристов?
Аффлек прямо ответил на этот вопрос: «Я не думаю, что это захватит бизнес каким-то значимым образом. Я думаю, что это будет дополнением». Его стартап строился на принципе, что ИИ помогает кинематографистам, а не заменяет их. Авторские права и творческий контроль остаются у человека.
Позиция Аффлека проста и применима за пределами Голливуда: если вы строите бизнес на ИИ, начните с собственных данных и дайте людям контроль над тем, как используется их работа. Это дольше и дороже, но именно за такой подход Netflix заплатил сотни миллионов.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Мониторинг ИИ-агентов за $185 на млн запросов: Goodfire читает сигналы модели изнутри
Почему это важно Открытые модели можно скачать и снять с них встроенные ограничения, а штатного мониторинга у них нет. Goodfire предлагает дешёвый способ…
Что такое ИИ-агент: Google запустила Gemini, который сам выполняет задачи
Принять к сведению: заголовок задан как H1, но сформулирован как двойной вопрос-справочник («Что такое X и как»). По правилам я не дублирую H1 в теле и не…
AI leaderboard Arena привлекла $200 млн и впервые ранжирует модели по честности
Платформа Arena, выросшая в 2023 году из исследовательского проекта Калифорнийского университета в Беркли, привлекла 200 млн долларов в раунде Series B при…
Комментарии