
Авито построила отдельную inference платформу: PaaS не справился с LLM
Microsoft второго июня запустила Project Solara — операционную систему, где ИИ-агенты заменяют привычные приложения, и впервые отдала управление машине, а не пользователю.
Нет, подождите — мне дан конкретный H1 и конкретный оригинал про Авито. Начинаю заново, строго по источнику.
Авито столкнулась с проблемой, знакомой каждой крупной компании, которая пытается запускать ML-модели в продакшен: платформа, идеально заточенная под веб-сервисы, оказалась непригодной для инференса (inference, исполнения обученной модели на реальных запросах), и вместо доработки старого инструмента команда построила отдельную inference-платформу на открытом ядре KServe.
Авито публично описала конкретные технические причины, по которым PaaS (Platform as a Service, готовая платформа для запуска сервисов) не справляется с LLM-инференсом, и показала, что даже у компании с развитой ML-инфраструктурой добавление нужных функций в существующую систему заняло бы годы.
Что произошло и на каком фоне?
Антон Алексеев, ML Ops-инженер Авито, опубликовал на Хабре разбор того, как в Авито пришли к решению строить отдельную inference-платформу. До этого компания годами использовала собственный PaaS, вокруг которого выросла экосистема ML-инструментов: фичесторы, коллекторы, отдельный ML-кластер. Модели пытались запускать как обычные веб-сервисы внутри PaaS, но быстро упёрлись в ограничения.
Решение: не дорабатывать PaaS, а построить отдельную inference-платформу на базе открытого проекта KServe, чтобы опираться на сообщество и получать функции, которых в PaaS нет и не будет без многолетней разработки.
Почему PaaS не подходит для inference?
PaaS Авито проектировался под задачу «разработчик выкатывает микросервис одним кликом». Внутри: CI/CD, интеграция с базами данных, логирование, метрики, автоскейлинг по нагрузке. Это классика для stateless-сервисов (сервисов без состояния) на Go с предсказуемым потреблением CPU и оперативной памяти.
Как только в эту модель пытаешься встроить ML-модель, тем более LLM (большую языковую модель), нестыковки появляются на каждом уровне. Разница не сводится к «нужен GPU вместо CPU», она затрагивает весь жизненный цикл сервиса.
Алексеев перечисляет конкретные причины:
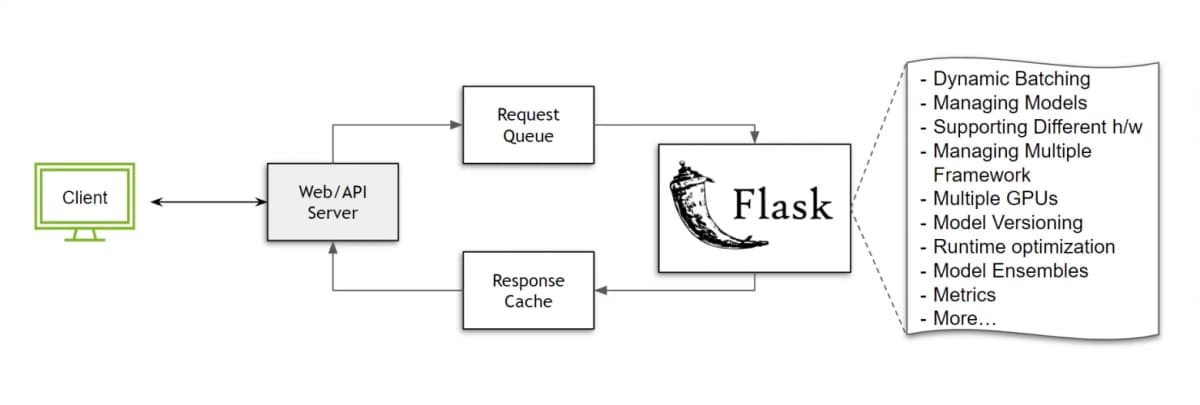
- Динамический батчинг. GPU простаивает при обработке одного запроса за раз (batch=1), потому что узкое место для LLM не вычисления, а пропускная способность памяти при загрузке весов модели. Динамический батчинг (склейка независимых запросов разных клиентов в один проход) даёт разницу в загрузке GPU в 5-10 раз. Написать это вручную внутри PaaS технически можно, но тут же возникают вопросы: как не увеличить задержку ожидающих запросов, как учитывать разную длину последовательностей, как совместить асинхронный приём с блокирующим проходом модели. На чистом Python это упирается в GIL (Global Interpreter Lock, блокировка, не позволяющая Python-коду выполняться параллельно в одном процессе).
- Очередь запросов. Без очереди с механизмом обратного давления (backpressure) сервис под нагрузкой либо «захлёбывается», либо отвечает с нарастающей задержкой без возможности сообщить клиенту «подожди». Очередь не убирает перегрузку, а превращает её в управляемую задержку. Это защита от каскадных отказов, а не оптимизация.
- Зависимость от железа. Бизнес-логика не должна знать, что модель квантована (сжата для ускорения) в формат FP8 и работает на конкретном inference-движке под конкретный ускоритель. Если это размазано по веб-фреймворку, смена поколения GPU требует правки кода, который отвечает за маршрутизацию HTTP-запросов.
- Ресурсы GPU. PaaS оптимизирован под дробление CPU и RAM между множеством лёгких подов. GPU дефицитный, дорогой, плохо дробится, а простаивающий GPU это, по словам Алексеева, «большие деньги на ветер».
- Обновление моделей. Обычный сервис обновляется по коммиту и весит мегабайты. LLM-модель обновляется через релиз новых весов размером в десятки гигабайт, и цикл выглядит совсем иначе.
Аргументы за отдельную inference-платформу
Главный довод: добавление всей inference-специфичной функциональности в PaaS заняло бы годы, потому что система изначально не была заточена под эти задачи. Выбор KServe как открытого ядра позволяет опираться на сообщество и получать обновления извне.
Платформа берёт на себя только inference-специфичные вещи: батчинг, очередь, кэш ответов, поддержку нескольких моделей одновременно, работу с разными фреймворками, управление несколькими GPU на одной ноде, оптимизацию рантайма, мониторинг, версионирование моделей, абстрагирование от архитектуры железа. Бизнес-логика продуктов живёт снаружи и обращается к платформе через понятный интерфейс.
Это классическое разделение ответственности: inference-платформа отвечает за эффективное исполнение модели, продуктовый сервис отвечает за бизнес-логику.
Аргументы против: почему не доработать PaaS?
Справедливый контраргумент: внутри Авито уже есть зрелый PaaS с экосистемой, и вторая платформа это дополнительная поддержка, дополнительная команда, дополнительная точка отказа. Любой, кто работал с внутренней инфраструктурой, знает: каждая новая платформа требует документации, онбординга, дежурств.
Кроме того, самодельное решение внутри PaaS, даже неидеальное, уже знакомо командам. Переход на новую платформу означает миграцию существующих сервисов, а это всегда риск.
Алексеев прямо признаёт: написать батчинг руками внутри PaaS «технически можно», но предупреждает, что такое решение «обычно либо не работает, либо превращается в собственную маленькую inference-платформу». То есть доработка PaaS в пределе всё равно ведёт к созданию отдельной платформы, только неявной и хуже поддерживаемой.
Динамический батчинг склеивает независимые запросы разных клиентов в один forward pass, и разница в utilization может быть 5-10x. Самодельное решение обычно либо не работает, либо превращается в собственную маленькую Inference-платформу. : Антон Алексеев, ML Ops-инженер Авито
Что это значит для вас?
Автору Дзена. Если вы используете нейросети через API для генерации текстов или картинок, вы конечный пользователь inference-платформ. Понимание того, почему сервис иногда «тормозит» или «падает», помогает выбирать провайдера: спрашивайте, есть ли динамический батчинг и очередь с приоритетами.
Маркетологу и продакт-менеджеру. Если ваша компания внедряет ML-модели в продукт, опыт Авито показывает конкретный чеклист вопросов к инфраструктурной команде: поддерживается ли батчинг, как устроено версионирование моделей, отделена ли бизнес-логика от сервинга. Без этого масштабирование упрётся в те же проблемы.
Предпринимателю в РФ и СНГ. KServe, на базе которого Авито строит свою платформу, это открытый проект (опенсорс), доступный без ограничений. Для компаний, которые не могут позволить себе команду уровня Авито, существуют облачные inference-сервисы от Яндекса (YandexGPT API) и Сбера (GigaChat API), где батчинг и очереди уже реализованы на стороне провайдера.
Авито сделала то, что многие российские компании откладывают: честно признала, что универсальная платформа не справляется со специализированной задачей, и не стала латать, а построила новый инструмент. По моему опыту, большинство команд в РФ до сих пор запускают ML-модели «как ещё один микросервис» и потом удивляются, почему GPU загружен на 10-20%. Статья Алексеева на Хабре ценна не как реклама Авито, а как публичный разбор инженерных решений, которые обычно остаются за закрытыми дверями. Если вы работаете с ML в продакшене, стоит прочитать оригинал целиком и сверить со своим чеклистом. Оговорка: Авито описывает свой контекст с десятками тысяч запросов в секунду. Для маленькой команды с одной моделью отдельная inference-платформа может быть избыточной, достаточно грамотно настроенного vLLM или TGI (Text Generation Inference от Hugging Face, открытый сервер для запуска LLM).
Опыт Авито подтверждает тренд, который виден и у зарубежных компаний: inference перестаёт быть «просто деплой модели» и превращается в отдельную инженерную дисциплину со своими платформами, метриками и командами. Для российского рынка, где GPU дорог и дефицитен вдвойне, эффективная inference-платформа это не роскошь, а прямая экономия, и публичных разборов такого уровня пока единицы.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Microsoft маскирует дата центры под леса и сады: программа охватит 20+ площадок
Microsoft прячет свои дата центры в лесах и садах, маскируя многоэтажные серверные корпуса под природный ландшафт, чтобы погасить нарастающее недовольство…
Что такое галлюцинации нейросетей: люди спорят с врачами и официантами, доверяя ChatGPT
Madison, официантка из Нью-Йорка, теперь начинает каждый разговор с гостями с вопроса об аллергиях, потому что посетители всё чаще доверяют ChatGPT больше, чем…
Suno запустила генератор музыки с голосом: озвучка и саундтрек в одном запросе
Suno второго июня запустила публичную бету функции Speech, генератор музыки с голосом, который создаёт синтетическую озвучку и фоновую музыку в одном треке…
Комментарии