
Архитектура трансформер с обратной связью: идея из Принстона пока без экспериментов
Принстонский исследователь Ифан Чжан опубликовал технический отчёт Recurrent Looped Transformer, архитектуру трансформер нейронной сети, где последний слой передаёт своё полное состояние первому слою следующего токена, закрывая контур обратной связи, которого у стандартных моделей нет.
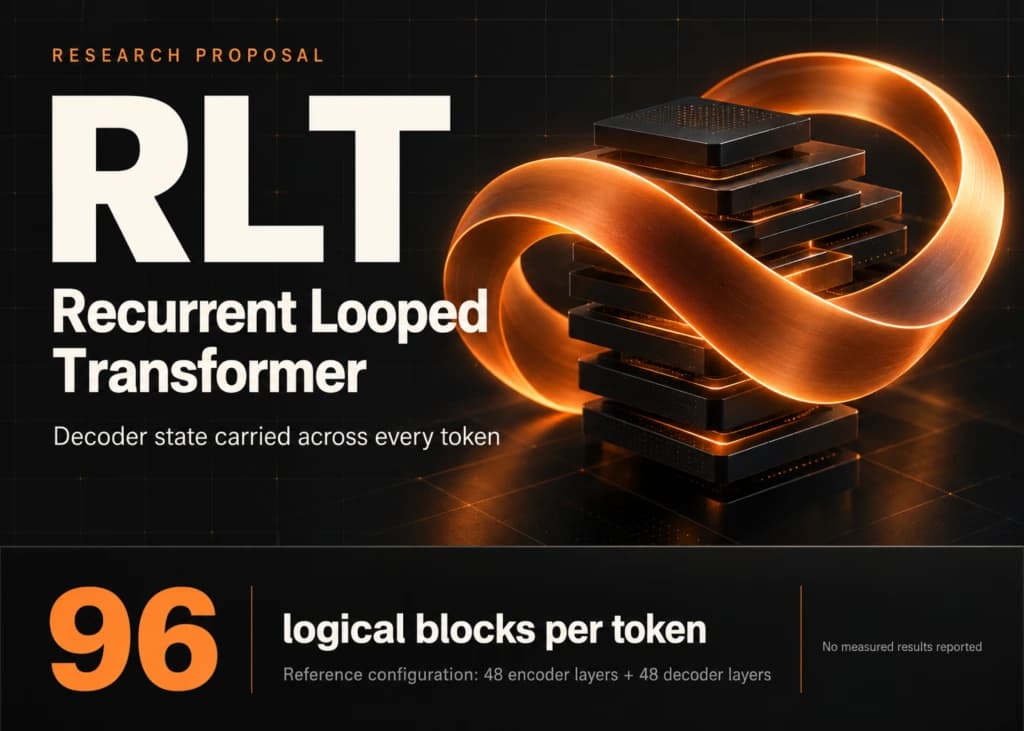
Это проектный документ без единого эксперимента: ни одного замера качества, скорости или масштабирования не проведено, а значит, архитектура пока остаётся гипотезой, не доказанным преимуществом.
Архитектуру предложил Ифан Чжан из Принстона. Сегодня в стандартных декодерных моделях (GPT, LLaMA и подобных) информация, вычисленная на последнем слое для токена t, никак не попадает на первый слой токена t+1. Позиции общаются только через кэш ключей и значений в механизме внимания. RLT предлагает замкнуть этот контур и передавать скрытое состояние целиком, от токена к токену, без сброса на границе между промптом и ответом.
| Показатель | Значение | Источник |
|---|---|---|
| Слои энкодера (эталонная конфигурация) | 48 | Технический отчёт RLT |
| Слои декодера (эталонная конфигурация) | 48, с привязкой весов к энкодеру | Технический отчёт RLT |
| Логических блоков на токен | 96 | Технический отчёт RLT |
| Глубина пути состояния после t токенов | 48 × t блоков декодера | Технический отчёт RLT |
| Заявленный параллельный скан для декодера | не заявлен | Технический отчёт RLT |
| Ускорение предзаполнения (prefill) | не заявлено | Технический отчёт RLT |
| Экспериментальные замеры (качество, скорость, масштабирование) | отсутствуют | Технический отчёт RLT |
Как устроена архитектура RLT?
В стандартном трансформере (архитектура трансформер, transformer) каждый слой обрабатывает токен и передаёт результат следующему слою вверх, но не вперёд, к следующему токену. Представьте конвейер, где каждая деталь проходит все станки, но станки не помнят предыдущую деталь.
RLT делит модель на две части: каузальный энкодер и рекуррентный декодер.
- Энкодер обрабатывает токены параллельно, как обычный трансформер, и создаёт представления, из которых формируется память ключей и значений.
- Декодер работает последовательно. Его полное состояние для каждого токена складывается из финального выхода и кэша скользящего окна внимания (SWA, sliding-window attention, механизм, при котором модель смотрит только на ближайшие W позиций, а не на всю последовательность). Перед обработкой нового токена специальный вентиль объединяет текущее представление от энкодера с предыдущим выходом декодера.
Эталонная конфигурация использует 48 слоёв энкодера и 48 слоёв декодера с общими весами. Каждый токен проходит 96 логических блоков. При этом Чжан подчёркивает, что это повторное использование параметров, а не копирование активаций.
Три принципа, на которых стоит RLT
Скрытое рассуждение с неограниченной временной глубиной. После обработки t токенов путь состояния проходит через 48 × t блоков декодера. Вычислительная нагрузка на один токен постоянна, но структурная глубина растёт с длиной последовательности. Сам автор оговаривает: вентили и сжатие могут подавлять длинные пути, поэтому структурная глубина не гарантирует качества рассуждений.
Совместное проектирование модели и оборудования. Энкодер параллелен, декодер последователен внутри одной последовательности, но обновления из независимых последовательностей можно объединять в один пакетный вычислительный вызов. Отчёт прямо указывает: параллельный скан для нелинейного декодера не предполагается, ускорение предзаполнения не заявлено. Пакетная обработка, слияние ядер и чекпойнтинг (контрольные точки для экономии памяти) перечислены как цели реализации, а не готовые решения.
Совместное проектирование модели и RL-алгоритма. Предобучение, дообучение (fine-tuning, обучение модели на специализированных данных), сэмплирование и воспроизведение в обучении с подкреплением (RL, reinforcement learning) используют одну и ту же функцию перехода состояний. При RL-обучении обучающий модуль пересчитывает память энкодера, рекуррентный выход и весь кэш SWA с начала последовательности под текущими параметрами, прежде чем оценивать каждое действие. Старые состояния из прошлых прогонов никогда не переиспользуются.
Что обнаружили?
- Путь состояния через 48t блоков декодера создаёт структурную глубину, которая растёт линейно с числом обработанных токенов, при фиксированных вычислениях на каждый токен.
- Веса привязаны между энкодером и декодером: 96 логических блоков на токен при одном наборе параметров.
- Снимок состояния для многооборотного обслуживания включает кэш энкодера, полное состояние декодера, метаданные позиции, настройки окна и версию модели. При обновлении весов все старые снимки становятся недействительными.
- При обучении с подкреплением требуется полный пересчёт всех состояний с начала последовательности, старые состояния не кэшируются и не переиспользуются.
- Экспериментальных результатов нет: качество рассуждений, эффективность и масштабирование RL остаются открытыми вопросами.
Отчёт не содержит ни одного измерения. Ни бенчмарков, ни сравнений с существующими моделями, ни тестов масштабирования. Автор явно об этом пишет. Структурная глубина 48t блоков выглядит внушительно, но сам Чжан предупреждает, что вентили и сжатие могут гасить длинные пути, а значит, выгода остаётся теоретической. Частичное отсечение градиентов (partial detaching) признано рискованным: через кэш ключей и значений декодера остаются перекрёстные градиентные пути, поэтому любая схема урезанного обратного распространения должна явно перечислять все отсечённые тензоры. Это проектная спецификация, не проверенный продукт.
Что это значит для вас?
Авторам Дзена и копирайтерам. Пока ничего не меняется на практике: ни одна доступная модель не использует RLT. Но полезно понимать сам принцип. Если архитектура трансформер нейронной сети получит «память» между токенами, будущие модели смогут лучше держать контекст в длинных текстах. Следить за реализацией стоит, менять рабочие процессы рано.
Разработчикам и тем, кто запускает локальные модели в РФ. Ключевое ограничение: RL-обучение в RLT требует полного пересчёта кэша с начала последовательности при каждом обновлении параметров. Старые состояния выбрасываются целиком. Для локальных проектов с ограниченными GPU это означает, что дообучение с подкреплением на такой архитектуре обойдётся значительно дороже по памяти и времени, чем стандартный подход, где кэш переиспользуется. Если вы работаете с открытыми моделями (LLaMA, Qwen) на российских серверах, просто учитывайте этот ограничитель при оценке будущих архитектур.
Предпринимателям. Архитектура не реализована, продукта нет. Принимать решения на её основе преждевременно.
Идея красивая: дать трансформеру память, которая течёт от токена к токену, а не обнуляется. Это напоминает возврат к рекуррентным сетям (RNN), но с вычислительной мощью трансформера. На мой взгляд, честность автора обезоруживает: он сам пишет, что результатов нет, глубина не гарантирует качества, а параллельное ускорение не заявлено. Если кто-то реализует RLT и получит замеры, это будет по-настоящему интересная новость. Пока перед нами чертёж, а не двигатель.
Для тех, кто работает с локальными моделями в России, главный практический вывод уже сейчас: любая архитектура с полным пересчётом состояний при RL-обучении ставит жёсткий порог по железу, и это нужно закладывать в бюджет до начала экспериментов, а не после.
По данным технического отчёта Recurrent Looped Transformer (Yifan Zhang, Princeton)

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
Junie от JetBrains: аналог Cursor для России с оплатой в рублях
Российская компания JetBrains выпустила Junie, встроенного ИИ-агента для среды разработки, который работает прямо внутри редактора кода и решает задачи от…
ИИ агенты управляют Chrome через accessibility API
Google Docs, Trello, CRM, почта: всё залогинено в вашем Chrome, но ни один ИИ-агент не мог туда попасть без отдельного профиля и ручной авторизации, пока не…
Генерация ТЗ с помощью ИИ: как собрать требования из всех каналов за 1–3 дня
Составление технического задания вручную, когда требования разбросаны по почте, мессенджерам, комментариям в Jira и файлам, отнимает у системного аналитика…
Комментарии