
Anthropic скупает и уничтожает книги: обучение нейросети на своих данных оказалось легальным
Anthropic и другие крупные ИИ-лаборатории массово скупают бумажные книги, сканируют их для обучения нейросети на своих данных, а после оцифровки уничтожают физические экземпляры, и это оказывается легально по американскому копирайт-праву.
Суд фактически подтвердил: если компания купила книгу и уничтожила оригинал после сканирования, копия считается законной заменой, а не пиратством. Для авторов и издателей это означает, что их тексты попадают в обучающие данные (training data, массивы текстов, на которых тренируют нейросеть) без отдельного лицензирования.
Скандал вспыхнул после того, как в англоязычном сегменте сети снова всплыли подробности практики: ИИ-компании заказывают миллионы книг, промышленным способом отрезают корешки для ускорения сканирования, оцифровывают содержимое и отправляют бумажные остатки на утилизацию. Anthropic уже получала штраф в 1,5 млрд долларов за нарушение авторских прав при использовании книг. Источник при этом фиксирует: практика не прекратилась, она лишь адаптировалась к судебным решениям.
Зачем компании уничтожают книги после сканирования?
Логика простая и циничная. Всё, что доступно в открытом интернете, ИИ-лаборатории уже использовали многократно. Качественных текстов в сети не так много: значительная часть онлайн-контента не подходит для повышения уровня модели. Бумажные книги выигрывают тем, что их писал живой автор, а затем проверял редактор.
Но просто купить и отсканировать книгу означает создать копию, а это потенциальное нарушение копирайта. Судья в одном из разбирательств с Anthropic разъяснил: если оригинал уничтожен, юридически происходит не копирование, а трансформация одного экземпляра из физической формы в цифровую. Нет второго экземпляра, нет и нарушения.
Как выглядит процесс обучения нейросети на своих данных у Anthropic?
Исходя из описания процесса, цепочка такова:
- Закупка. Компания массово заказывает книги, включая редкие издания с ограниченным тиражом.
- Подготовка. Корешки книг срезают промышленным способом, чтобы страницы проходили через поточный сканер.
- Оцифровка. Текст сканируется и конвертируется в данные, пригодные для дообучения (fine-tuning, обучение модели на новых примерах под конкретную задачу) или базового обучения модели.
- Уничтожение. Физический экземпляр утилизируется, что по американскому праву делает цифровую копию легальной заменой, а не пиратской копией.
Что понадобится
Если вы автор или издатель и хотите понять, затрагивает ли вас эта практика:
- Проверить, продаются ли ваши книги через открытые маркетплейсы (Amazon, AbeBooks и аналоги), откуда ИИ-компании делают массовые закупки
- Изучить лицензионные условия ваших договоров с издательством: передавали ли вы право на перепродажу без ограничений
- Отслеживать судебные прецеденты: решения американских судов формируют практику, которую другие юрисдикции могут перенять или отвергнуть
Пошаговая инструкция: как проверить, используются ли ваши тексты
- Откройте модель Claude (разработка Anthropic) или ChatGPT и задайте прямой вопрос о содержании вашей книги. Если модель воспроизводит фрагменты или пересказывает структуру, ваш текст с высокой вероятностью попал в обучающие данные.
Перескажи содержание книги [название] автора [имя].
Процитируй фрагмент из главы 3 книги [название].
- Зафиксируйте ответ модели: сделайте скриншот с датой.
- Проверьте, есть ли ваша книга в известных датасетах. Сервис «Have I Been Trained» позволяет искать по части открытых обучающих наборов.
- Если нашли свой текст, обратитесь к юристу по интеллектуальной собственности в вашей юрисдикции. Американский прецедент не действует автоматически в РФ.
Автор нишевой книги по маркетингу (тираж 2 000 экземпляров) вводит в Claude промпт (запрос к нейросети): «Перескажи ключевые идеи книги [название]». Модель выдаёт точный пересказ пяти из восьми глав, включая авторские примеры и метафоры. Это означает, что текст попал в обучающие данные. При этом автор не давал согласия и не получил компенсации.
Переносить американскую логику на РФ. Российское копирайт-право не содержит нормы, по которой уничтожение оригинала легализует цифровую копию. В РФ обязательны архивные экземпляры (закон об обязательном экземпляре документов), поэтому модель «купил, отсканировал, уничтожил» юридически здесь не работает.
Думать, что редкость книги защищает. Как раз редкие издания привлекательнее для ИИ-компаний: это уникальные данные, которых нет в интернете.
Игнорировать масштаб. Речь идёт о миллионах экземпляров, а не о единичных случаях. Если ваша книга продаётся на открытом рынке, она потенциально в зоне риска.
Что делать прямо сейчас, по ролям
Авторам Дзена и копирайтерам. Ваши тексты на платформе индексируются поисковиками и парсерами. Обучение нейросети на своих данных, которое ведут крупные лаборатории, затрагивает и веб-контент. Проверьте robots.txt вашего сайта: директива для ботов ИИ-компаний (GPTBot, ClaudeBot, anthropic-ai) позволяет хотя бы формально ограничить сбор.
Издателям и правообладателям. Включайте в договоры с дистрибьюторами запрет на перепродажу для целей машинного обучения. Это не гарантия, но создаёт юридическое основание для претензий.
Предпринимателям в РФ. В России аналогичных массовых закупок книг для обучения ИИ публично не зафиксировано. Но YandexGPT и GigaChat тоже обучаются на текстах. Разница в том, что российское законодательство строже в части архивных копий и не допускает уничтожения оригинала как основания для легализации копии.
История с Anthropic обнажает разрыв между юридической нормой и здравым смыслом. По букве американского закона компания действует легально: один экземпляр превращается в другую форму. По существу, автор лишается контроля над своим текстом без компенсации и без согласия.
Для тех, кто работает с контентом в РФ, я вижу два практических вывода. Первый: любой текст, доступный для покупки или скачивания, рано или поздно попадёт в обучающие данные какой-то модели, это вопрос времени, а не принципа. Второй: пока нет международного регулирования, единственная реальная защита это договорные ограничения и мониторинг.
Штраф в 1,5 млрд долларов Anthropic не остановил. Значит, экономика обучения перевешивает штрафы. Это честный сигнал для каждого, кто создаёт тексты профессионально.
Ситуация с массовой скупкой и уничтожением книг ради обучения нейросетей ставит конкретный вопрос перед каждым автором: не «украдут ли мой текст», а «уже украли или ещё нет». Проверьте сегодня, ответ может неприятно удивить.
Проверьте, как ИИ работает с вашим контентом
Генератор промптов dzen.guru поможет составить точные запросы для проверки, попали ли ваши тексты в обучающие данные
Попробовать генератор
Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
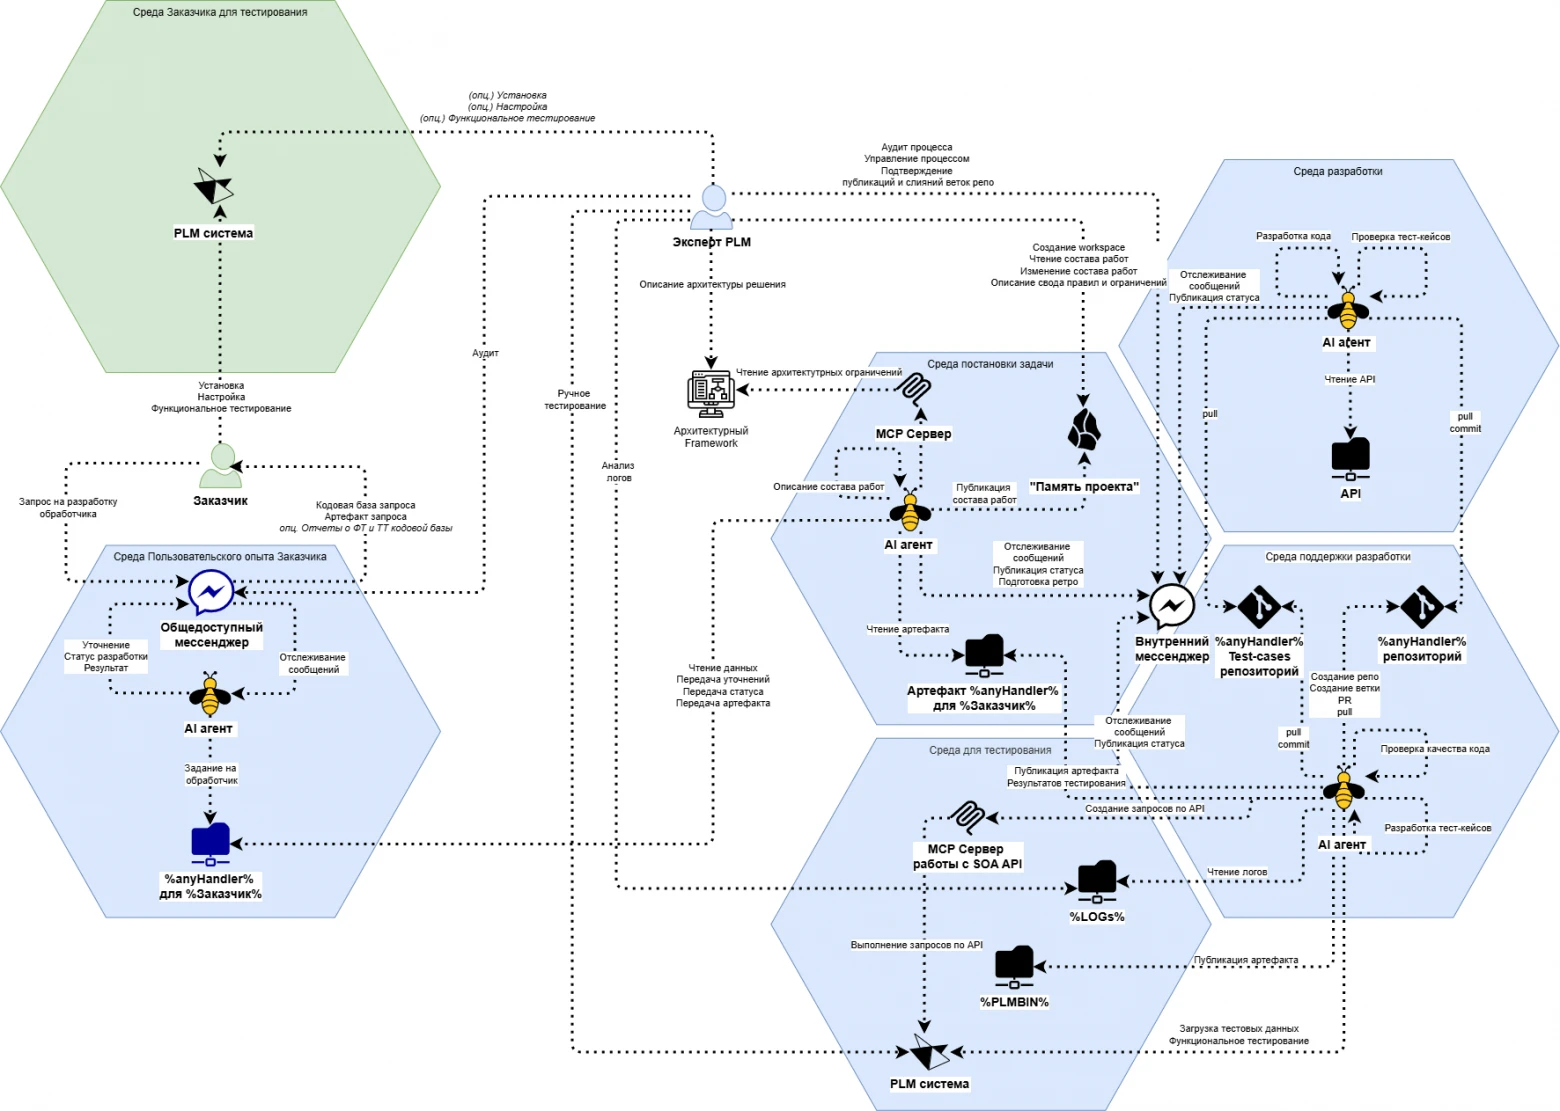
Что такое ИИ-агент в кастомизации PLM: закрытую систему доработали без узких специалистов
Кастомизация PLM (Product Lifecycle Management, система управления жизненным циклом изделия) силами ИИ-агентов (программ, которые сами выполняют цепочку…
AI SaaS и DevOps: что это за подход, когда модель расследует сбой, а не маскирует его
Инженер показывает нейросети строку ошибки и пишет «почини», а модель мгновенно выдаёт пять вариантов от «очистить кэш» до «перезапустить сервис», и один из…
DeepSeek desktop вышел для Windows и Mac: агент работает в фоне, но аналитику не отключить
DeepSeek 30 сентября выпустила десктопное приложение Harness Desktop для Windows и Mac, которое превращает браузерного ИИ-агента в полноценную программу с…
Комментарии