
14 нейросетей для 1С сравнили в открытом бенчмарке: Claude Opus 5 и GPT 5.6 Sol лидируют
Компания 1С и её экосистема разработки получили первый независимый бенчмарк, который сравнивает 14 крупнейших нейросетей по реальным задачам платформы, и автор проекта vibecoding1c.ru опубликовал результаты в открытом доступе вместе со всеми артефактами на GitHub.
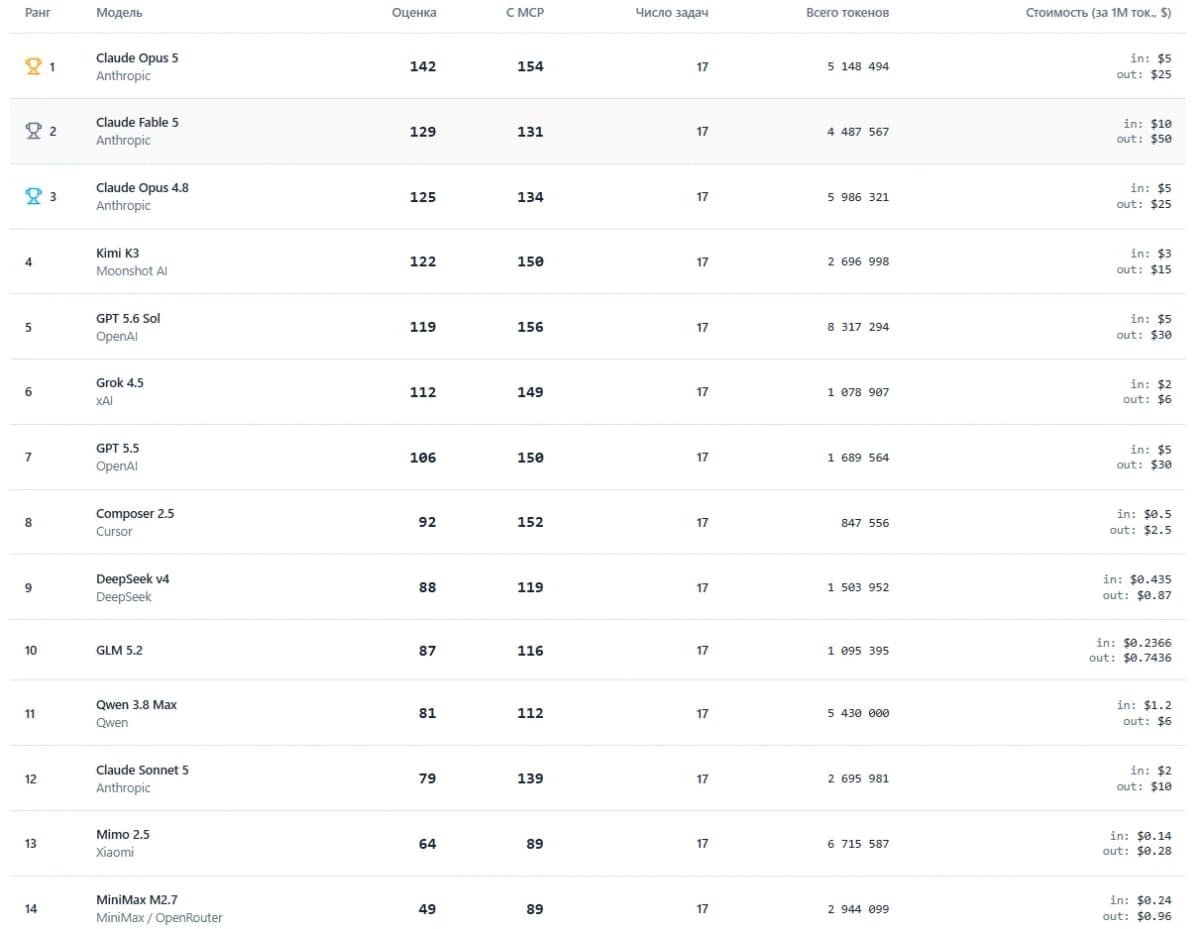
Впервые нейросеть для 1С можно выбрать не по маркетинговым обещаниям, а по публичному тесту с реальными задачами: от генерации форм до разработки подсистем с обновлением базы данных.
Универсальные бенчмарки кодовых моделей до сих пор измеряли способность писать на Python или JavaScript, но игнорировали 1С. Автор проекта vibecoding1c.ru (создатель набора MCP-серверов и правил для ИИ-разработки на 1С) запустил специализированный тест в мае 2025 года и с тех пор регулярно обновляет его, добавляя модели и задачи. Актуальная версия живёт на портале vibecoding1c.ru/bench, а тексты задач и эталонные ответы выложены на GitHub.
| Параметр | Значение |
|---|---|
| Кто | vibecoding1c.ru (независимый проект) |
| Тип | Открытый бенчмарк для ИИ-моделей в 1С-разработке |
| Число моделей | 14 |
| Дата запуска | Май 2025, регулярные обновления |
| Код задач | github.com/comol/1CLLMBenchTasks |
Что именно тестируют и как устроен бенчмарк?
Задачи разбиты на шесть категорий: алгоритмы, архитектура, механизмы платформы, производительность, работа с метаданными (служебной информацией о структуре базы) и разработка форм. Если в начале 2025 года моделям предлагали «написать сортировку пузырьком» на языке 1С, то теперь бенчмарк начинается с хитрых алгоритмических задач и заканчивается разработкой подсистем с обновлением базы данных и тестированием.
Каждую модель запускали в «родной» среде вендора: Claude Code для моделей Claude, Codex для GPT, Kimi Code для Kimi, Cursor для Grok и Composer. Автор объясняет этот выбор тем, что вендор лучше всего знает, какой системный промпт (базовая инструкция, задающая поведение модели) подходит его продукту.
Для каждой модели зафиксированы потраченные токены (единицы текста, которые модель «читает» и генерирует), при этом кэшированные токены исключены, чтобы результат отражал реальную нагрузку. Все оценки, сгенерированный код и артефакты доступны на портале с фильтрами по категории задач и режиму (с MCP или без).
MCP (Model Context Protocol, протокол подключения внешних инструментов к модели) и специализированные правила разработки на 1С использовались в отдельном варианте теста. Автор подчёркивает: без дополнительных MCP и правил нейросеть для 1С знает платформу заметно хуже, и на практике разработка без них почти не ведётся.
Кто лидирует и кому какая модель подходит?
Claude Opus 5 занял первое место в режиме без MCP. Автор называет её лучшей моделью для кодинга на текущий момент, особенно для архитектурных задач. Однако у моделей Claude есть характерная проблема: они могут игнорировать часть инструкций. Поэтому в варианте «с MCP» лидером стала GPT 5.6 Sol, которая точнее следует правилам и расходует при этом меньше токенов.
Kimi K3 показала результаты на уровне лучших платных моделей и даже выше по ряду задач. Главное ограничение пока в скорости: при сопоставимом количестве токенов время выполнения у Kimi K3 существенно больше.
Grok 4.5 и Composer 2.5 показали близкие результаты и работают лучше с MCP и правилами. DeepSeek v4 и GLM 5.2 автор рекомендует только при жёстких бюджетных ограничениях и исключительно с MCP.
Модели Qwen 3.8 Max, Claude Sonnet 5, Mimi 2.5 и MiniMax M2.7 автор пока не рекомендует для разработки на 1С.
Отдельное наблюдение: у моделей нового поколения (GPT 5.6 Sol, Kimi K3, Qwen 3.8, Claude Fable 5) рассуждающий режим (reasoning) настолько «упорный», что модель пытается решить задачу «до победного», тратя много токенов и времени. Временной фактор в бенчмарке пока не учитывается, но автор планирует добавить его в следующих версиях.
Утверждение может показаться слишком смелым, но даже разработчик уровня senior едва ли решит половину задач данного бенчмарка. Средняя модель справляется со всеми задачами за 3-4 часа. : Автор проекта vibecoding1c.ru
Что это значит для вас?
Разработчикам 1С. Теперь есть способ выбрать нейросеть для 1С по реальным задачам вашей платформы, а не по общим рейтингам. Если у вас настроены MCP и правила, GPT 5.6 Sol обойдётся дешевле за счёт меньшего расхода токенов. Если работаете без обвязки и нужна максимальная точность в архитектуре, Claude Opus 5 пока впереди.
Авторам Дзена и контент-маркетологам. Бенчмарк показывает, что даже без специальных настроек многие модели уже собирают внешнюю обработку или отчёт на 1С. Это значит, что статьи и обучающие материалы по 1С-разработке с ИИ перестают быть футуристикой и становятся практическими руководствами с конкретной аудиторией.
Предпринимателям в РФ и СНГ. Все 14 моделей доступны через API или собственные среды разработки. Из моделей, доступных без VPN, обратите внимание на DeepSeek v4: результаты скромнее лидеров, но цена существенно ниже, и для типовых задач с MCP этого может хватить.
Этот бенчмарк закрывает реальную дыру. Все универсальные рейтинги (HumanEval, SWE-bench) проверяют модели на Python и общих алгоритмах, а 1С-разработчик оставался наедине с догадками. Теперь можно открыть таблицу, посмотреть, сколько токенов потратила модель на задачу из вашей категории, и принять решение с цифрами. По моим наблюдениям, самое ценное здесь даже не рейтинг лидеров, а колонка «с MCP / без MCP»: она показывает, что вложения в настройку окружения дают прирост, сопоставимый с переходом на более дорогую модель. Оговорка: оценку артефактов (например, удобство сгенерированных форм) выполнял автономный ИИ-агент Hermes на базе GPT 5.6 Sol, и автор честно признаёт долю субъективности. Перепроверяйте результаты на своих задачах.
Бенчмарк пока не учитывает время выполнения и полную стоимость задач. Для моделей вроде Kimi K3, которые тратят столько же токенов, но работают заметно медленнее, реальная экономика может отличаться от табличной. Автор планирует добавить эти метрики в будущих версиях.
Если вы разработчик на 1С и до сих пор выбирали модель «на глаз», откройте vibecoding1c.ru/bench, отфильтруйте задачи по своей категории и сравните результаты с MCP и без: разница между моделями в этом режиме иногда важнее, чем разница между самими моделями.

Основатель dzen.guru. Эксперт по монетизации и продвижению на Дзен. Автор курса «Старт на Дзен 2026».
Читайте также
ИИ-агенты перегрузили Defender: загрузка процессора упала с 67% до 12% после исключений
Разработчик проекта Local Commander выяснил, почему его компьютер с Windows начал подвисать: почти круглосуточная работа ИИ-агентов Claude Code и Codex…
Разработчики Битрикс24 сделали «Лови коллег» в стиле Pokémon Go: игра узнаёт лица сотрудников
Разработчик Битрикс24 Алексей опубликовал разбор игры «Лови коллег», которая узнаёт сотрудников по снимку с телефона, и показал на деле: распознавание лиц для…
Codemode меняет работу ИИ-агентов с MCP: инструменты больше не забивают контекст
Разработчики агентной обвязки Pi с выходом версии 1.0 добавили поддержку MCP через Codemode, хотя один из них больше года советовал не грузить такие…
Комментарии